Le pas d'apprentissage
Jusqu'où on peut allonger le pas avant que la descente cesse de descendre.
La page 2 n'a prouvé qu'une chose locale : la direction. Il ne dit rien du pas fini . Prenons donc la fonction la plus simple qui ait un minimum, et calculons tout.
Hypothèses
avec , de minimum
Le pas est constant : ne dépend pas de
Point de départ
Propriétés utilisées
La caractérisation de la convergence d'une suite géométrique : si et seulement si
Étapes
On substitue la dérivée et on factorise :
substitution puis factorisation
C'est une suite géométrique de raison , dont le terme général s'écrit directement :
récurrence immédiate
La convergence vers zéro équivaut donc à , qu'on résout :
définition de la valeur absolue, puis soustraction de 1 et changement de signe
Résultat
Interprétation
Le seuil ne dépend ni du point de départ, ni du nombre d'itérations : c'est une propriété de la courbure seule. Plus la fonction est courbée, plus le pas doit être court.
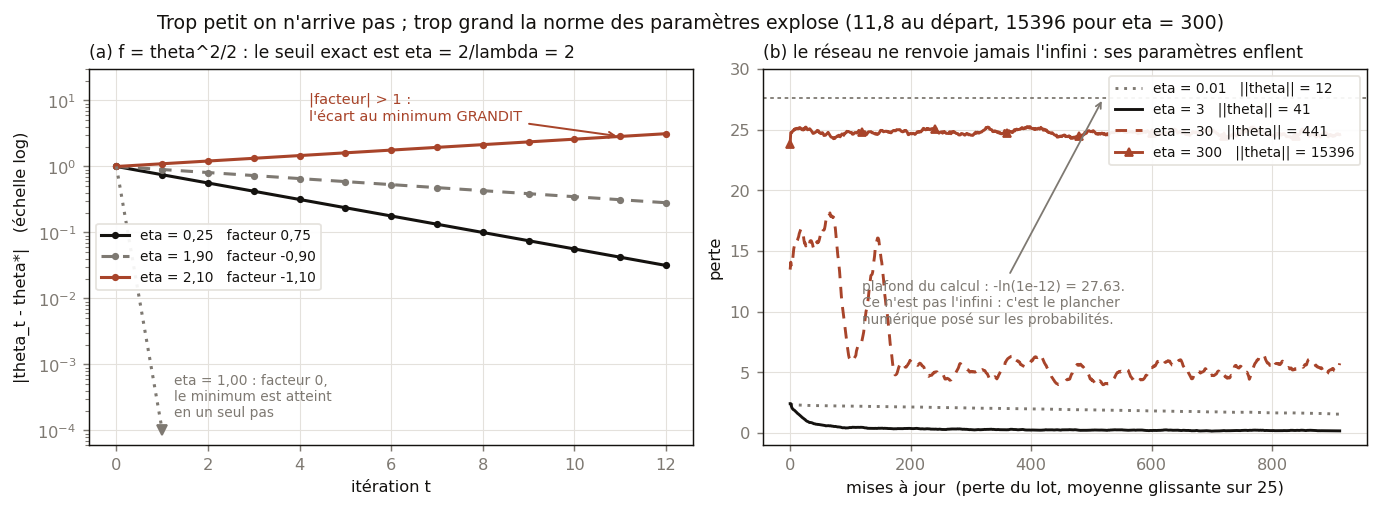
Les quatre régimes, calculés
         eta  1 - eta lambda   |facteur|   theta_0=1 -> theta_1..theta_5
        0.25            0.75        0.75   +0.7500  +0.5625  +0.4219  +0.3164  +0.2373
        0.50            0.50        0.50   +0.5000  +0.2500  +0.1250  +0.0625  +0.0312
        1.00            0.00        0.00   +0.0000  +0.0000  +0.0000  +0.0000  +0.0000
        1.50           -0.50        0.50   -0.5000  +0.2500  -0.1250  +0.0625  -0.0312
        2.00           -1.00        1.00   -1.0000  +1.0000  -1.0000  +1.0000  -1.0000
        2.10           -1.10        1.10   -1.1000  +1.2100  -1.3310  +1.4641  -1.6105
Lecture
entre 0 et 1 : décroissance monotone.
, soit : le minimum est atteint en un seul pas. C'est le pas optimal, calculable ici parce que est connu.
entre et 0 : le signe alterne, on saute par-dessus le minimum à chaque fois, mais on s'en rapproche.
: à exactement, oscillation d'amplitude constante, jamais de convergence. Au-delà, l'écart est multiplié par à chaque pas.
En dimension p : la courbure devient un spectre
Généralisons au quadratique multivarié , avec symétrique définie positive. Alors (vérification des dimensions : , et un gradient a bien la dimension de ).
En diagonalisant et en posant , chaque coordonnée évolue indépendamment selon . Le problème se décompose en problèmes à une variable, chacun avec sa courbure. La convergence exige la condition pour toutes les coordonnées, donc pour la plus grande.
Sur le réseau : la mesure, et ce qu'elle corrige
python cours/lecon3/experiences2.py E5 · 937 mises à jour, B = 64
           eta   perte finale   pire perte    ||theta||   precision test
         0.001         2.2312         2.56         11.8           0.3883   <- trop lent
      (depart)                                     11.8
         0.010         1.5757         2.47         12.2           0.7240   <- trop lent
         0.100         0.3919         2.39         16.6           0.8950
         0.500         0.2575         2.96         21.0           0.9208
         1.000         0.1958         4.74         25.3           0.9393
         3.000         0.1826         7.07         40.7           0.9410
        10.000         0.6677        17.44        105.2           0.7961   <- degrade
        30.000         5.2892        24.22        441.2           0.2051   <- pire que le hasard
       100.000        24.2415        27.20       2937.1           0.1032   <- pire que le hasard
       300.000        24.6940        27.63      15395.8           0.1010   <- pire que le hasard
Lecture
Une correction que la mesure impose. J'allais écrire « au-delà d'un seuil, la perte diverge ». C'est faux. À aucun testé, jusqu'à 300, la perte ne devient infinie ni indéfinie.
La raison est dans le code : la perte est calculée avec un plancher de sur les probabilités, donc elle ne peut pas dépasser . Et l'on mesure exactement à . Le plafond observé est le plancher numérique, pas une propriété du réseau.
Le vrai témoin de la divergence est la norme des paramètres : , soit un facteur 1305. Les paramètres partent bien à l'infini ; c'est la perte qui ne peut pas les suivre.
Trop petit () : la norme bouge à peine, et la courbe de perte descend proprement. C'est l'échec difficile à voir, parce qu'il ressemble à un entraînement qui marche.
La plage utile couvre un facteur 30 ( à ). C'est ce qui rend le réglage par tâtonnement praticable.
Vue de dessus
Coût par itération
Le coût baisse, mais la trajectoire s'arrête avant d'arriver. Rien n'indique l'erreur : c'est l'échec difficile à voir.
À , la précision est , la meilleure de la table, et la pire perte rencontrée en cours de route est , bien au-dessus de , la perte d'un réseau qui répondrait au hasard.
- a
Comment un entraînement peut-il passer par un état pire que le hasard et finir meilleur que tous les autres ? Donne l'explication en termes de trajectoire.
- b
Quelle quantité faudrait-il tracer, en plus de la perte, pour distinguer cette situation d'un vrai début de divergence ?
Aucune réponse à cliquer : il y a un calcul à faire.