L'initialisation
Pourquoi on ne part pas de zéro, et d'où vient l'échelle du tirage au hasard.
Le choix le plus naturel est de tout mettre à zéro : neutre, sans arbitraire, sans graine aléatoire. Prouvons qu'il est fatal.
Hypothèses
et
Toutes les colonnes de sont initialisées à la même valeur
Le pas et la suite des mini-lots sont quelconques
Point de départ
Chaîne de dépendances
x → z^[1] → a^[1] → z^[2] → a^[2] → ℓ
Propriétés utilisées
La rétropropagation du cours précédent :
Le gradient d'une couche :
Étapes
Initialisation. À , toutes les lignes valent zéro : elles sont égales.
hypothèse
Hérédité. Supposons qu'à l'étape toutes les lignes valent un même vecteur , et tous les biais un même . Alors pour tout exemple et tout neurone caché :
la couche cachée produit 128 fois la même valeur
Remontons le gradient. Le second facteur ne dépend pas de , on vient de le voir ; le premier non plus, puisque les colonnes de sont identiques.
rétropropagation, et hypothèse sur les colonnes de la seconde couche
Le gradient de la première couche a donc toutes ses lignes égales. Vérification des dimensions : .
produit extérieur d'un vecteur à composantes égales
La mise à jour soustrait la même quantité à chaque ligne : les lignes restent égales à l'étape .
conclusion de la récurrence
Résultat
Interprétation
Le réseau a 128 neurones cachés mais un seul degré de liberté caché : il se comporte pour toujours comme un réseau à un neurone. Ce n'est pas une convergence lente, c'est une impossibilité structurelle, et aucun réglage du pas ne la lève.
Vérification, après 200 mises à jour depuis l'initialisation nulle
      lignes distinctes de W1 : 1 sur 128
      ecart maximal entre deux lignes : 0.00e+00
      perte test 1.9896   precision test 0.2532   (hasard = 0.1000)
Lecture
L'écart maximal entre deux lignes est exactement nul, au bit près. Pas « petit » : nul. La preuve est confirmée sans approximation.
Une note honnête sur . Le réseau fait mieux que le hasard, ce qui peut surprendre. C'est normal : la couche de sortie, elle, n'est pas symétrique. Ses dix neurones voient le même unique signal caché, mais leurs biais peuvent diverger et apprendre les fréquences des classes, plus ce seul signal. Le réseau n'est pas mort ; il est réduit à une seule caractéristique apprise.
Second obstacle : tirer au hasard ne suffit pas
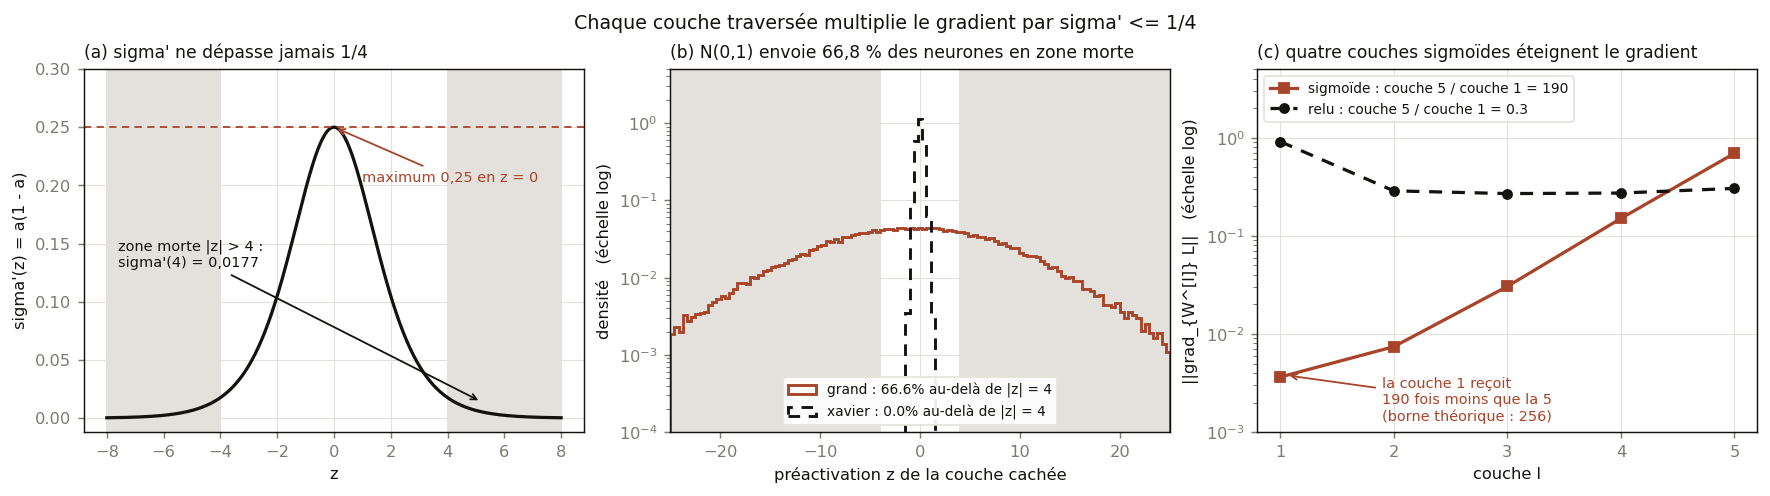
Puisqu'il faut casser la symétrie, tirons au hasard. Prenons la loi normale centrée réduite, le choix le plus évident. Mesurons les préactivations avant tout apprentissage.
python cours/lecon3/experiences2.py E6
      methode        Var(Z1)    |Z1| > 4   moy sigma prime  lignes W1 distinctes
      zero            0.0000       0.00%          0.250000                     1
      grand          91.9551      66.81%          0.041835                   128
      xavier          0.1173       0.00%          0.243062                   128

      sigma prime maximal possible = 0.25 (atteint en z = 0).
Lecture
Avec la loi normale centrée réduite, la variance de la préactivation vaut , soit un écart-type de .
des préactivations dépassent , où . La dérivée moyenne tombe à , soit six fois moins que le maximum .
Les deux tiers des neurones sont en zone morte dès l'initialisation : leur gradient est presque nul, ils n'apprendront que très lentement.
Le cahier des charges de l'initialisation
| Critère | Pourquoi | |
|---|---|---|
(D1) | Deux neurones d'une même couche doivent être distinguables | sinon la couche a un seul degré de liberté |
(D2) | Les préactivations doivent rester dans la zone non saturée | la dérivée y est proche de son maximum |
(D3) | Le critère précédent doit tenir couche après couche | sinon il se dégrade avec la profondeur |
(D4) | Il ne doit pas dépendre d'un réglage à la main | sinon c'est un hyperparamètre de plus, par couche |
Hypothèses
Les poids sont indépendants, centrés, de variance , et indépendants des entrées
Les entrées sont indépendantes, centrées, de variance
Le biais est nul
Point de départ
Propriétés utilisées
L'indépendance de et :
L'additivité de la variance pour des variables indépendantes
Étapes
Par indépendance et centrage, chaque terme est de moyenne nulle, donc aussi.
indépendance et centrage
Les termes étant indépendants, les variances s'ajoutent :
additivité de la variance, puis identité des lois
Le critère (D3) s'écrit « la variance ne change pas d'une couche à l'autre », donc :
traduction du critère, puis division par v non nul
Résultat
Interprétation
L'écart-type tombe du cahier des charges ; on ne l'a pas choisi. Il ne dépend d'aucun réglage, seulement de la largeur de la couche d'entrée : le critère (D4) est satisfait. C'est l'initialisation dite de Xavier, dans sa version « avant ». Vérification : pour et des entrées de moment d'ordre deux , la prédiction est , et l'on mesure . L'écart de 5 % vient de ce que les pixels ne sont ni centrés ni indépendants : les hypothèses sont approchées, et le résultat tient quand même.
Ce que ce résultat ne dit pas
Pour la ReLU, la moitié des valeurs sont annulées : si est symétrique, , la variance est divisée par deux à chaque couche. Il faut compenser par , l'initialisation de He, celle de la page 7.
Verdict
| Candidat | (D1) | (D2) | (D3) | (D4) | Précision | Verdict |
|---|---|---|---|---|---|---|
Tout à zéro | ✗ | ✓ | sans objet | ✓ | rejeté | |
Loi normale centrée réduite | ✓ | ✗ | ✗ | ✓ | rejeté | |
Xavier | ✓ | ✓ | ✓ | ✓ | retenu |
La couche cachée de notre réseau a une largeur d'entrée de 784, la couche de sortie de 128.
- a
Quels sont les deux écarts-types d'initialisation ? Donne les valeurs numériques.
- b
Pourquoi la couche de sortie a-t-elle droit à des poids plus grands que la couche cachée ? Réponds en une phrase, en te servant de la dérivation.
Aucune réponse à cliquer : il y a un calcul à faire.