Le lot complet, et le mini-lot
Ce que coûte un pas calculé sur tout le jeu, et ce que le mini-lot y change.
Le risque empirique est une moyenne sur tout le jeu, et son gradient aussi. La descente honnête calcule cette somme entière à chaque pas. Mesurons ce qu'elle coûte, et ce qu'elle rapporte.
L'obstacle, prouvé
python cours/lecon3/experiences.py E2
  N = 60000   B = 64   p = 101770

  Cout d'UNE mise a jour (mediane, apres passe a blanc) :
    lot COMPLET     6049.4 ms   soit  100.82 us par exemple
    MINI-LOT          45.2 ms   soit  705.48 us par exemple

    Par exemple, le lot complet est 7.0 x PLUS efficace :
    une grande multiplication de matrices exploite mieux le cache.
    Et pourtant il ne produit qu'UNE mise a jour, contre 937.

  Ce que chacun obtient pour UN passage sur les 60000 exemples, eta = 0.5 :
    methode             mises a jour    duree   perte test   precision
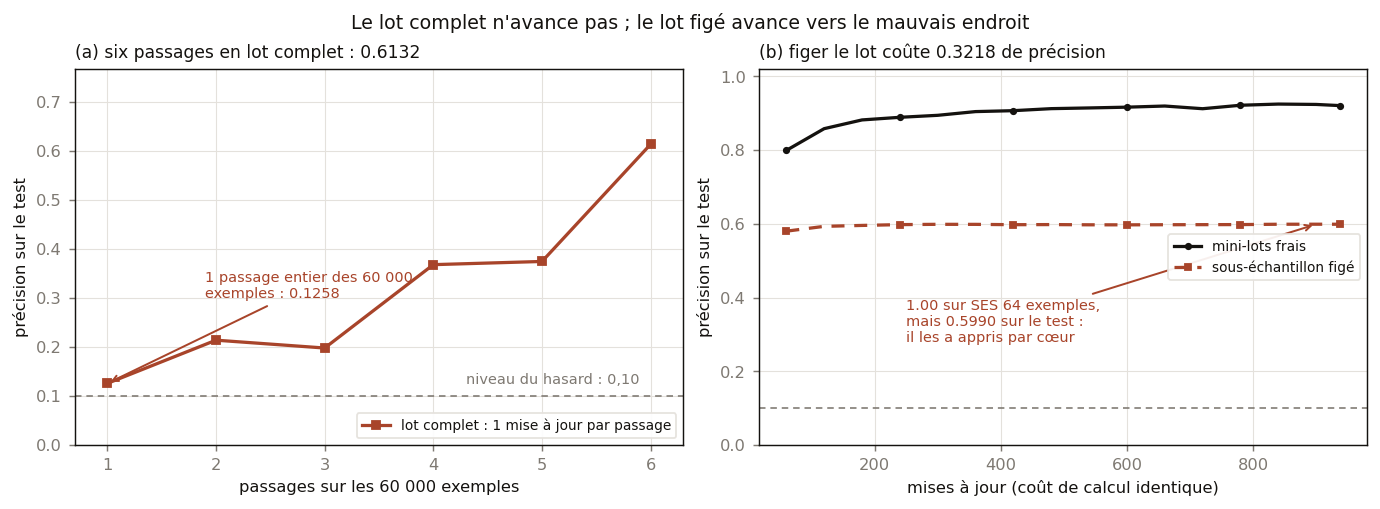
    lot complet                    1    7.32s       2.3103      0.1258
    mini-lots B=64               937   29.92s       0.2546      0.9273
Lecture
Le lot complet est plus efficace par exemple : contre , un facteur en sa faveur. Une grande multiplication de matrices amortit mieux les accès mémoire. Le grief contre lui n'est donc pas le coût arithmétique.
Le grief est ailleurs : pour le même parcours des données, il produit une mise à jour au lieu de 937.
Le résultat est sans appel : de précision de test, contre pour un tirage au hasard entre dix classes. Après avoir vu les 60 000 exemples, le réseau n'a rien appris.
Le cahier des charges
Ce que la solution devra satisfaire
| Critère | Pourquoi | |
|---|---|---|
(C1) | Le coût d'une mise à jour ne doit pas dépendre de | sinon le nombre de mises à jour par heure s'effondre quand le jeu grandit |
(C2) | La direction utilisée doit être en moyenne le gradient complet | sinon on optimise autre chose, et on ne sait plus quoi |
(C3) | L'erreur commise doit être contrôlable par un réglage | sinon on ne peut pas arbitrer entre vitesse et précision |
(C4) | Le coût mémoire ne doit pas dépendre de | en flottants 64 bits fait déjà 376 Mo |
Le candidat naïf, mis en échec
Le candidat le plus simple répond à (C1) et (C4) sans effort : puisque le lot complet coûte cher, tirons une fois pour toutes un petit sous-échantillon, et travaillons dessus. C'est le premier réflexe, et il faut le tuer avec une mesure, pas avec un argument.
python cours/lecon3/experiences.py E3 · 937 mises à jour, coût identique
  sous-echantillon fige : 937 mises a jour, meme cout de calcul
    sur les 64 exemples figes : perte 0.0036   precision 1.0000
    sur le jeu de test        : perte 1.3899   precision 0.5990

  mini-lots frais : 937 mises a jour, meme cout de calcul
    sur les 64 exemples figes : perte 0.3925   precision 0.9062
    sur le jeu de test        : perte 0.2664   precision 0.9208

  Ecart de precision de test : 0.9208 - 0.5990 = +0.3218
Lecture
Le candidat figé atteint sur ses propres 64 exemples, perte : il les a appris par cœur. Et sur le test.
Le détail qui tranche : les mini-lots frais font moins bien que le figé sur ces 64 exemples précis ( contre ) et beaucoup mieux partout ailleurs.
Le candidat naïf viole (C2) : la direction qu'il suit est le gradient exact d'une autre fonction, celle qui ne porte que sur ses 64 exemples.
La solution, dérivée du cahier des charges
(C1) et (C4) imposent un lot de taille fixe, indépendante de . (C2) impose que ce lot soit retiré à chaque pas, et de façon uniforme. Cela suffit à tout démontrer.
Hypothèses
est tiré uniformément parmi les parties de taille de
est la moyenne des gradients individuels sur
Point de départ
Propriétés utilisées
La linéarité de l'espérance
La symétrie du tirage uniforme : tous les indices jouent le même rôle
Étapes
Le tirage étant uniforme, la probabilité d'appartenance ne dépend pas de . Comme la somme de ces probabilités vaut l'espérance du cardinal, c'est-à-dire :
symétrie, puis comptage
Par linéarité de l'espérance, appliquée à la somme finie :
linéarité de l'espérance ; les facteurs B se simplifient
Résultat
Interprétation
Le critère (C2) est satisfait exactement, pas approximativement, et pour toute taille de lot, y compris . Le mini-lot ne donne pas « à peu près » la bonne direction : il donne une direction dont la moyenne est la bonne. C'est ce qui autorise à faire beaucoup de pas médiocres plutôt qu'un pas parfait.
Hypothèses
Tirage avec remise : les tirages sont indépendants et de même loi
est la moyenne des carrés des écarts entre gradients individuels et gradient complet
Point de départ
Propriétés utilisées
Les sont de moyenne nulle, par la dérivation précédente
L'indépendance des tirages annule les termes croisés
Étapes
On développe le carré de la norme de la moyenne :
bilinéarité du produit scalaire
Pour , l'indépendance et la moyenne nulle annulent le terme. Il ne reste que les termes diagonaux, chacun égal à .
indépendance et moyenne nulle
Résultat
Interprétation
Le critère (C3) est satisfait, et le réglage est . Mais le rendement est décroissant : quadrupler ne divise l'erreur que par deux, alors qu'il quadruple le coût. C'est l'argument quantitatif en faveur des petits lots.
Ce que ce résultat ne dit pas
La preuve suppose un tirage avec remise. Sans remise, s'ajoute le facteur de population finie , compris entre et pour et : indétectable dans nos mesures, mais il existe.
python cours/lecon3/experiences.py E4 · 200 tirages par taille de lot
  ||grad complet|| = 0.863256   (reference)

       B   ||moyenne - complet||   ecart quadratique moyen   x sqrt(B)
       1                0.334587                  5.876873      5.8769
       4                0.303096                  2.923644      5.8473
      16                0.122570                  1.455154      5.8206
      64                0.062213                  0.725300      5.8024
     256                0.024452                  0.363179      5.8109
    1024                0.014276                  0.186764      5.9764
Lecture
Colonne 2, à ne pas surinterpréter. Elle tend vers zéro, mais ce n'est pas un biais : la proposition dit que le biais est exactement nul. C'est l'erreur résiduelle de Monte-Carlo sur une moyenne de 200 tirages, qui vaut environ l'écart divisé par . Pour : , et l'on mesure . Même ordre.
Colonne 4 : l'écart multiplié par vaut , , , , , sur trois ordres de grandeur de . La loi en est vérifiée, et la constante est mesurée.
La remontée à est du bruit : avec 200 répétitions, l'erreur type relative est d'environ , et l'écart observé est de .
Le chiffre à retenir : pour un gradient complet de norme . Le bruit d'un gradient à un seul exemple est près de sept fois plus grand que le signal, et pourtant cela fonctionne, parce que ce bruit est de moyenne nulle et que les pas sont nombreux.
Verdict
| Candidat | (C1) | (C2) | (C3) | (C4) | Verdict |
|---|---|---|---|---|---|
Lot complet | ✗ | ✓ | ✗ | ✗ | rejeté : après un passage |
Sous-échantillon figé | ✓ | ✗ | ✗ | ✓ | rejeté : contre |
Mini-lot retiré à chaque pas | ✓ | ✓ | ✓ | ✓ | retenu |
On mesure et un gradient complet de norme .
- a
Quelle taille de lot faudrait-il pour que l'écart quadratique moyen tombe à de la norme du gradient complet ? Donne le calcul.
- b
Sachant qu'un exemple coûte environ en lot complet, combien de temps coûterait alors une mise à jour ? Compare aux 45 ms du mini-lot à , et conclus.
Aucune réponse à cliquer : il y a un calcul à faire.