Pourquoi cette direction, et pourquoi ce signe
Pourquoi on descend dans la direction opposée au gradient, et pas dans une autre.
Depuis deux cours nous écrivons la règle de mise à jour, et nous n'avons jamais prouvé ni pourquoi c'est cette direction, ni pourquoi c'est moins. Nous avons dit « on descend la pente », une formulation qui ne dit rien de vérifiable. Réglons cela.
Il faut d'abord définir « direction » et « le plus vite ». Une direction est un vecteur de norme . La contrainte est indispensable : sans elle, il suffirait d'allonger pour faire baisser la perte davantage, et la question n'aurait pas de réponse.
Le signe, en une variable : les trois cas
Commençons par une seule variable, où tout se voit. Soit dérivable en , et le pas avec . Trois cas, et trois seulement.
| Cas | Où faut-il aller | Signe du pas | Verdict |
|---|---|---|---|
la fonction croît : vers la gauche | négatif | ✓ | |
la fonction décroît : vers la droite | positif | ✓ | |
nulle part | nul, l'algorithme s'arrête | ✓ |
La direction, en p variables
Hypothèses
de dans est différentiable en
est non nul
parcourt la sphère unité, c'est-à-dire
Point de départ
Chaîne de dépendances
u → θ + h u → f(θ + h u)
Propriétés utilisées
La définition de la différentiabilité :
L'inégalité de Cauchy-Schwarz et son cas d'égalité
Étapes
On applique la différentiabilité avec l'accroissement , dont la norme vaut puisque est unitaire.
définition de la différentiabilité
On soustrait , on divise par , et on fait tendre vers zéro. Le terme en disparaît.
passage à la limite
Cauchy-Schwarz encadre ce produit scalaire, pour tout de norme .
Cauchy-Schwarz, avec la norme de u égale à 1
Le cas d'égalité exige colinéaire à ; comme , les deux seuls candidats sont . On vérifie directement que la borne est atteinte.
cas d'égalité de Cauchy-Schwarz, puis calcul direct
Résultat
Interprétation
La direction opposée au gradient n'est pas une bonne direction : c'est la meilleure, et la borne qu'elle atteint vaut exactement . Ce nombre est donc à la fois la pente maximale et la mesure de « à quel point on n'est pas à un point critique ».
Ce que ce résultat ne dit pas
La preuve est locale : elle ne dit rien au-delà d'un déplacement infinitésimal. Rien ne garantit qu'un pas fini fasse baisser la perte. C'est l'objet de la page 4.
Elle suppose différentiable. La ReLU ne l'est pas en zéro (page 7).
« Plus forte décroissance » est relatif à la norme euclidienne. Changer de norme change la direction optimale : c'est l'idée qui donnera plus tard le gradient naturel.
La borne est-elle serrée ?
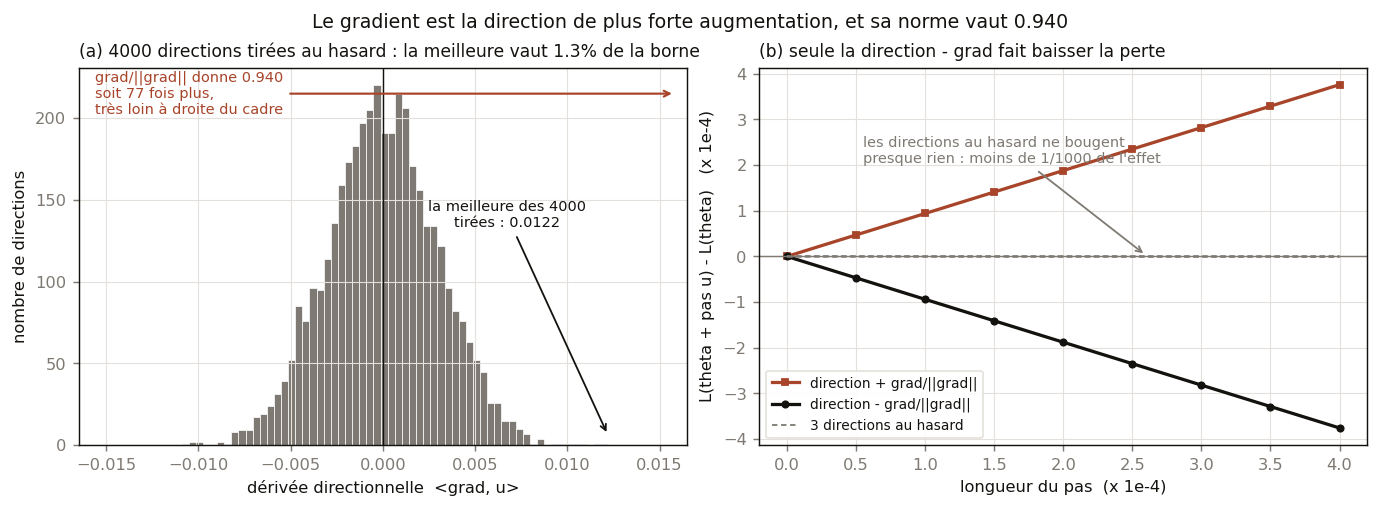
La preuve dit que . Une borne peut être vraie et molle. Mesurons : réseau , initialisation Xavier, graine 0, 512 exemples ; on calcule dans , puis on tire 2000 directions unitaires au hasard.
python cours/lecon3/experiences.py E1
  p = 101770          ||grad|| = 0.940183

  Derivee directionnelle <grad, u> pour 2000 directions unitaires tirees au hasard :
    maximum observe        0.012205
    minimum observe        -0.008903
    ecart-type             0.002975
    borne theorique +||g||  0.940183
    meilleure direction tiree / borne = 0.0130

  Direction u = grad/||grad||    <grad, u> = 0.940183   (= ||grad||)
  Direction u = -grad/||grad||   <grad, u> = -0.940183   (= -||grad||)

  Effet reel d'un pas de 0.0001 (perte de depart 2.414597) :
    direction           L(theta + eps u)     variation   prevue eps<g,u>
    +grad/||grad||            2.41469140      9.40e-05          9.40e-05
    -grad/||grad||            2.41450336     -9.40e-05         -9.40e-05
    aleatoire 1               2.41459749      1.28e-07          1.28e-07
    aleatoire 2               2.41459712     -2.49e-07         -2.49e-07
    aleatoire 3               2.41459727     -9.86e-08         -9.86e-08
Lecture
La meilleure des 2000 directions tirées atteint , soit 1,30 % de la borne. Tirer au hasard dans ne trouve rien : c'est la concentration de la mesure en grande dimension, où deux vecteurs tirés indépendamment sont presque orthogonaux.
La direction du gradient atteint , c'est-à-dire exactement , au chiffre près. La borne n'est pas molle : elle est atteinte.
Les deux dernières colonnes valident le développement limité : la variation mesurée et la variation prévue coïncident sur trois chiffres significatifs, pour les cinq directions.
Une surface en cuvette est représentée par ses lignes de niveau, des ellipses concentriques allongées horizontalement. Un point part en haut à gauche. À chaque étape, une flèche de brique montre le gradient, toujours perpendiculaire à la ligne de niveau qu'il traverse, et le point avance dans la direction opposée. La trajectoire zigzague d'abord d'un flanc à l'autre de la vallée, parce que la pente est beaucoup plus raide en travers qu'en long, puis s'aligne sur le fond et ralentit : les flèches raccourcissent à mesure que la pente s'aplatit. Le point s'immobilise au centre, où le gradient est nul.
Dans la sortie ci-dessus, le produit scalaire pour la direction aléatoire n° 2 vaut , puisque la variation à vaut .
- a
Quelle est la valeur du cosinus de l'angle entre cette direction et le gradient ? Donne le calcul.
- b
À quel angle en degrés cela correspond-il ? Que dis-tu de cet angle ?
Aucune réponse à cliquer : il y a un calcul à faire.