Un exemple ne suffit pas
Ce qui arrive si l'on n'écoute qu'une seule image, et pourquoi on moyenne les corrections.
Tout ce qui précède n'a regardé qu'une seule image, et rien n'empêche de lui appliquer deux cents pas de descente pour voir ce que le réseau répond ensuite sur dix mille images qu'il n'a jamais vues. Que devient un réseau qui n'a écouté qu'un seul exemple ?
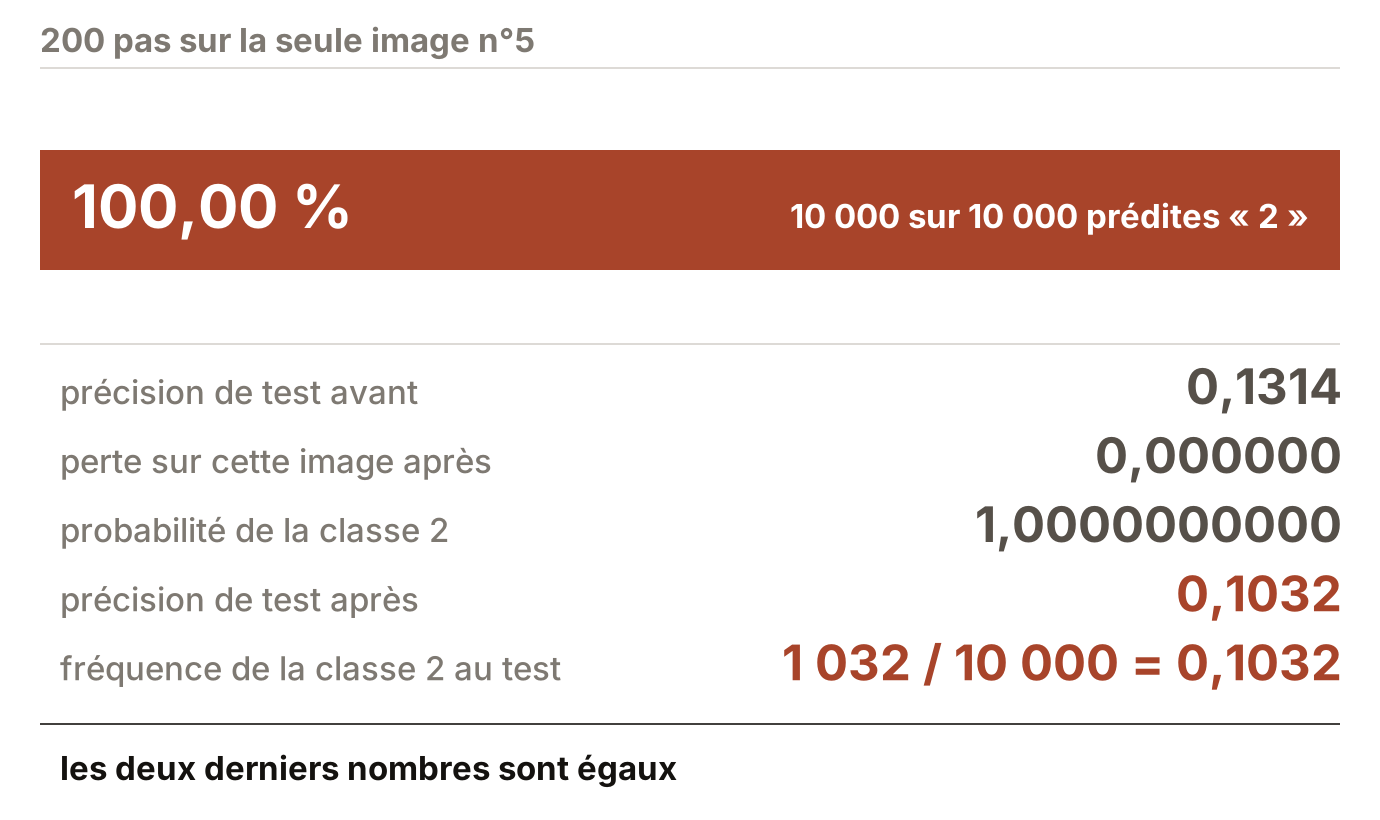
Le réseau a parfaitement appris l'image qu'on lui a donnée, et il répond à tout le reste, sans une seule exception sur dix mille images.
Les deux derniers nombres du relevé sont égaux, et ce n'est pas une coïncidence.
Ce qui arrive si l'on n'écoute qu'un seul exemple
Deux cents pas sur une seule image · cours/lecon4/mesures.py, mesure 4
  200 pas de descente sur la seule image de travail, eta = 0.5

  précision de test AVANT les pas                0.1314
  perte sur cette image avant les pas             1.408379
  perte sur cette image après 200 pas             0.000000   (sous le seuil de représentation)
  probabilité accordée à la classe 2 après       1.0000000000
  images de test prédites « 2 »                  10000 sur 10000
  part des images de test prédites « 2 »         100.00 %
  précision de test                              0.1032
  fréquence de la classe 2 dans le jeu de test    1032 / 10000 = 0.1032
  écart entre la précision et cette fréquence     0.000e+00

  la classe la plus fréquente du jeu de test     1, 1135 / 10000 = 0.1135
  c'est le plafond de tout réseau qui répond toujours la même chose
Lecture
Le réseau a parfaitement appris l'image, puisque sa perte tombe sous le seuil de représentation et qu'il accorde à la classe à l'affichage, la proposition 1 interdisant d'atteindre exactement .
Il répond à tout, et non presque tout : images sur , sans exception, parce que la descente n'a écouté qu'une demande et l'a exaucée jusqu'au bout.
Sa précision, , est exactement la fréquence de la classe dans le jeu de test, , à zéro près : un réseau qui répond toujours la même chose a pour précision la fréquence de cette classe, puisqu'il a raison sur les images de cette classe et sur aucune autre.
Le plafond d'un tel réseau est , la fréquence de la classe la plus représentée, et aucune constante ne fait mieux.
La grille de l'image de travail apparaît à gauche, un deux manuscrit en gris sur vingt-huit cases sur vingt-huit, et le réseau derrière elle. La grille pâlit, et dix barres horizontales poussent depuis une ligne verticale tracée à droite des dix ronds de sortie, une par classe, chacune à la hauteur de son neurone et de son chiffre. Leurs longueurs sont très inégales : celle de la classe deux fait les sept dixièmes de l'espace libre, celles des classes zéro et cinq le huitième, les sept autres sont des moignons. Les neuf barres autres que celle de la classe deux se rétractent alors jusqu'à disparaître, pendant que celle de la classe deux s'allonge jusqu'au bout de l'espace libre et passe au brique. Sa valeur s'inscrit à son extrémité : dix mille. Les neuf autres barres ont entièrement disparu, et il ne reste qu'une seule barre en face des dix chiffres.
La moyenne des corrections
On refait donc pour chaque exemple le parcours qui précède, et l'on moyenne les corrections souhaitées. Reste à savoir ce que cette moyenne est.
Hypothèses
, avec .
Chaque admet des dérivées partielles en .
est fixé et ne dépend pas de .
Propriétés utilisées
Linéarité de la dérivation : et
Définition du gradient comme vecteur des dérivées partielles
Étapes
On dérive composante par composante. Pour fixé, est la dérivée d'une somme finie de fonctions, multipliée par la constante .
Linéarité de la dérivation. Il n'y a aucune approximation à cette ligne : c'est une égalité.
On rassemble les composantes. Le vecteur dont la -ième composante est est, par définition du gradient, .
Résultat
Interprétation
La moyenne des corrections souhaitées est le gradient du coût : ni « en gros », ni « quelque chose de proportionnel », et sans facteur, sans approximation, sans hypothèse sur les données. C'est la linéarité de la dérivation, et rien d'autre. La descente du chapitre 3 réclame et l'algorithme donne ; cette proposition ferme le passage entre les deux.
Ce que ce résultat ne dit pas
L'égalité vaut pour la moyenne sur tout le jeu. Une moyenne sur un sous-ensemble n'est pas le gradient du coût, et le chapitre 3 a dit dans quel sens elle en approche.
Pourquoi la moyenne est nécessaire
Deux exemples demandent-ils la même chose ? · cours/lecon4/mesures.py, mesure 5
  cosinus entre les gradients de deux exemples pris séparément
  réseau non entraîné, 2000 paires de chaque sorte

      paires                cosinus moyen     écart-type     paires
      même classe            +0.4110          0.1438        2000
      classes différentes    -0.0263          0.0494        2000
Lecture
Deux images de la même classe demandent des corrections qui vont grossièrement dans le même sens, de cosinus moyen , et grossièrement seulement, puisque l'écart-type dit que la valeur va d'environ à d'une paire à l'autre.
Deux images de classes différentes demandent des corrections presque sans rapport, en moyenne avec un écart-type de : presque orthogonales, très légèrement opposées.
C'est ce désaccord qui rend la moyenne nécessaire, parce qu'exaucer une demande à la fois revient à défaire ce que la précédente a fait, et la mesure 4 montre où cela mène quand on n'en écoute qu'une.
En pratique, on ne moyenne pas sur tout le jeu
La proposition 7 porte sur les exemples, alors qu'un entraînement moyenne sur des mini-lots de . Le chapitre 3, page 9, l'a établi : le gradient d'un mini-lot est un estimateur sans biais du gradient complet, proposition 4, et sa qualité croît comme la racine de la taille du lot, proposition 5. Ce chapitre ne redémontre ni l'un ni l'autre.
Le réseau entraîné sur un seul exemple a une précision de test de , et le jeu de test compte images de classe sur .
- a
D'où vient exactement ce nombre ? Répondre sans invoquer d'apprentissage.
- b
Quelle serait la précision d'un réseau qui répondrait toujours ? Et quel est le meilleur score atteignable par un réseau qui répond toujours la même chose ?
Aucune réponse à cliquer : il y a un calcul à faire.
Deux exemples de classes différentes ont des gradients de cosinus moyen .
- a
Qu'est-ce que cela dit de ce qui arriverait si on les traitait l'un après l'autre plutôt qu'en moyenne ?
- b
Le cosinus de deux exemples de même classe vaut en moyenne, et non . Que faudrait-il pour qu'il vaille ?
Aucune réponse à cliquer : il y a un calcul à faire.