• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
44/59
Démonstration8 min

Remonter d'une couche

Le dernier pas en arrière : la porte ReLU, et les gradients de la première couche.

La demande est arrivée sur les activations cachées, et ce ne sont toujours pas des réglages. Sur cette image, soixante et onze des cent vingt-huit neurones cachés sont éteints : que devient la part de demande qui leur revient ?
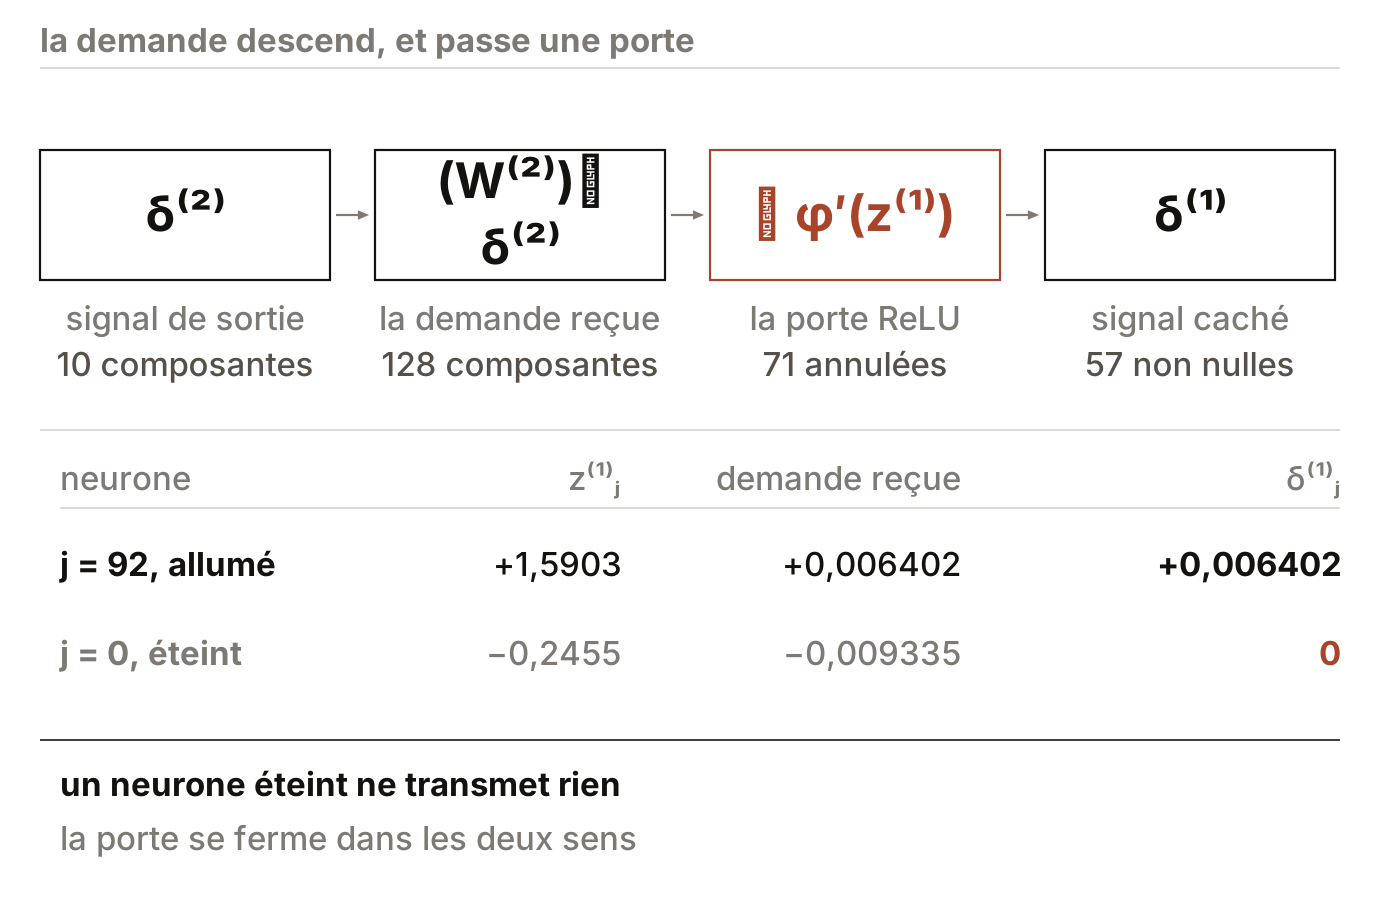
Quatre cadres en file, reliés par des flèches : le signal d'erreur de sortie et ses dix composantes ; la demande reçue, transposée de la seconde matrice appliquée à ce signal, et ses cent vingt-huit composantes ; la porte ReLU, en brique, qui en annule soixante et onze ; et le signal d'erreur caché, dont cinquante-sept composantes restent non nulles. Dessous, un tableau de deux lignes compare un neurone allumé et un neurone éteint : le quatre-vingt-douzième, de préactivation plus un virgule cinq neuf zéro trois, reçoit plus zéro virgule zéro zéro six mille quatre cent deux et transmet la même valeur ; le neurone zéro, de préactivation moins zéro virgule deux quatre cinq cinq, reçoit moins zéro virgule zéro zéro neuf mille trois cent trente-cinq et transmet zéro. En pied, deux mentions : un neurone éteint ne transmet rien, et la porte se ferme dans les deux sens.
La porte se ferme dans les deux sens, et c'est la même qu'à l'aller.

Les deux lignes du bas comparent un neurone allumé et un neurone éteint qui reçoivent tous les deux une demande non nulle. Le premier la transmet sans qu'un seul chiffre change, le second ne transmet rien.

La page démontre cette différence, et en tire le compte des zéros de la première matrice.

De l'activation à la somme pondérée

Il reste à passer de grada[1] ℓ\mathrm{grad}_{\mathbf{a}^{[1]}}\,\ellgrada[1]​ℓ à gradz[1] ℓ\mathrm{grad}_{\mathbf{z}^{[1]}}\,\ellgradz[1]​ℓ, et ce pas est le plus simple de tous parce que aj[1]=ReLU(zj[1])a_{j}^{[1]}=\mathrm{ReLU}(z_{j}^{[1]})aj[1]​=ReLU(zj[1]​) ne dépend que de zj[1]z_{j}^{[1]}zj[1]​ : il n'y a qu'un seul chemin, et la règle de la chaîne à plusieurs chemins se réduit à sa forme simple.

δj[1]=∂ℓ∂zj[1]=∂ℓ∂aj[1]⋅∂aj[1]∂zj[1]=[(W[2])Tδ[2]]j⋅ReLU′(zj[1])\delta_{j}^{[1]}=\frac{\partial\ell}{\partial z_{j}^{[1]}}=\frac{\partial\ell}{\partial a_{j}^{[1]}}\cdot\frac{\partial a_{j}^{[1]}}{\partial z_{j}^{[1]}}=\Big[\big(W^{[2]}\big)^{\mathsf{T}}\boldsymbol{\delta}^{[2]}\Big]_{j}\cdot\mathrm{ReLU}'\big(z_{j}^{[1]}\big)δj[1]​=∂zj[1]​∂ℓ​=∂aj[1]​∂ℓ​⋅∂zj[1]​∂aj[1]​​=[(W[2])Tδ[2]]j​⋅ReLU′(zj[1]​)
(4.8)
Un produit composante par composante : la jjj-ième composante de l'un multipliée par la jjj-ième de l'autre, sans aucune somme et sans mélange entre indices.
Produit de HadamardHadamard product, element-wise product

Pour u,v∈Rm\mathbf{u},\mathbf{v}\in\mathbb{R}^{m}u,v∈Rm, le vecteur u⊙v=(u1v1,…,umvm)T∈Rm\mathbf{u}\odot\mathbf{v}=(u_{1}v_{1},\ldots,u_{m}v_{m})^{\mathsf{T}}\in\mathbb{R}^{m}u⊙v=(u1​v1​,…,um​vm​)T∈Rm. Il ne change pas la dimension et ne fait aucune somme : c'est le produit ordinaire de R\mathbb{R}R, appliqué mmm fois en parallèle.

 δ[1]=[(W[2])Tδ[2]]⊙ReLU′(z[1]) ∈R128\boxed{\ \boldsymbol{\delta}^{[1]}=\Big[\big(W^{[2]}\big)^{\mathsf{T}}\boldsymbol{\delta}^{[2]}\Big]\odot\mathrm{ReLU}'\big(\mathbf{z}^{[1]}\big)\ }\qquad\in\mathbb{R}^{128} δ[1]=[(W[2])Tδ[2]]⊙ReLU′(z[1]) ​∈R128
(4.9)
Dimensions : (128×10)(10×1)=128×1(128\times 10)(10\times 1)=128\times 1(128×10)(10×1)=128×1, puis un produit de Hadamard avec un vecteur de R128\mathbb{R}^{128}R128, qui rend un vecteur de R128\mathbb{R}^{128}R128.

La dérivée de ReLU, et sa convention en zéro

ReLU′(u)=1{u>0}\mathrm{ReLU}'(u)=\mathbb{1}\{u>0\}ReLU′(u)=1{u>0} vaut 111 où la somme pondérée est strictement positive et 000 ailleurs. En u=0u=0u=0 la fonction n'est pas dérivable, le chapitre 2 a posé la convention ReLU′(0)=0\mathrm{ReLU}'(0)=0ReLU′(0)=0, et ce chapitre la garde. Le choix est libre et sans conséquence pratique, puisque l'événement zj=0z_{j}=0zj​=0 exactement est de mesure nulle sur des flottants.

Ce que la porte fait

ReLU′(z[1])\mathrm{ReLU}'(\mathbf{z}^{[1]})ReLU′(z[1]) est un vecteur de 000 et de 111, et c'est ce vecteur qu'on appellera la porte : le produit de Hadamard laisse passer certaines composantes sans les modifier et annule les autres. Sur l'exemple de travail, 575757 passent et 717171 sont annulées.

Un neurone allumé, un neurone éteint · cours/lecon4/mesures.py, mesure 3

  a^[1]_92 = 1.5903, neurone ALLUMÉ (z^[1]_92 = +1.5903)
  composante 92 de (W^[2])^T delta^[2]            +0.006402
  composante 92 de delta^[1], après la porte ReLU  +0.006402

  pour comparaison, le neurone ÉTEINT j = 0 (z^[1]_0 = -0.2455)
      demande reçue,  (W^[2])^T delta^[2] en 0    -0.009335
      composante 0 de delta^[1]                  -0.000000

Lecture

  • ·

    Le neurone 929292 est allumé, sa demande traverse la porte sans changer d'un chiffre, et la porte ne rééchelonne donc rien : elle laisse passer, ou elle coupe.

  • ·

    Le neurone 000 est éteint et reçoit pourtant une demande non nulle, −0,009335-0{,}009335−0,009335, que la porte annule : les dix neurones de sortie lui adressent bien quelque chose.

  • ·

    Un neurone éteint ne transmet rien parce qu'il n'a rien envoyé. Son activation valait 000 à l'aller, il n'a donc contribué à aucune des dix sommes pondérées, et changer un peu sa somme pondérée ne changerait toujours rien puisqu'elle resterait négative. La perte n'en dépend pas, et sa dérivée est nulle.

La porte ReLU sur les 128128128 composantes : elle en laisse passer 575757 et en coupe 717171.

Le réseau pâlit et rend ses cotes. Une ligne horizontale se trace au milieu du cadre, et cent vingt-huit barres très fines y poussent, une par neurone caché : un peigne serré, moitié au-dessus de la ligne, moitié en dessous, d'inégales longueurs, et pas une seule n'est nulle. Une cote de brique donne leur nombre : cent vingt-huit. Les barres des neurones allumés passent alors au brique, les autres restent à l'encre. Toutes les barres d'encre s'écrasent d'un coup sur la ligne et disparaissent, pendant que les barres de brique ne bougent pas : aucune ne se raccourcit, aucune ne change de sens. Le peigne est devenu clairsemé. Deux cotes s'inscrivent de part et d'autre de la ligne : cinquante-sept pour ce qui passe, soixante et onze pour ce qui est coupé.

0:00 / 0:12

Les gradients de la première couche

Les propositions 3 et 4 n'ont rien de particulier à la couche de sortie, puisqu'elles dérivent zk=∑jWkjaj+bkz_{k}=\sum_{j}W_{kj}a_{j}+b_{k}zk​=∑j​Wkj​aj​+bk​, ce qui est vrai de toute couche. On les applique donc telles quelles une couche plus bas, avec x\mathbf{x}x à la place de a[1]\mathbf{a}^{[1]}a[1], l'entrée jouant le rôle d'activation de la couche précédente.

gradb[1] ℓ=δ[1]∈R128,gradW[1] ℓ=δ[1]xT∈M128,784(R)\mathrm{grad}_{\mathbf{b}^{[1]}}\,\ell=\boldsymbol{\delta}^{[1]}\in\mathbb{R}^{128},\qquad \mathrm{grad}_{W^{[1]}}\,\ell=\boldsymbol{\delta}^{[1]}\mathbf{x}^{\mathsf{T}}\in\mathcal{M}_{128,784}(\mathbb{R})gradb[1]​ℓ=δ[1]∈R128,gradW[1]​ℓ=δ[1]xT∈M128,784​(R)
(4.10)
Dimensions : (128×1)(1×784)=128×784(128\times 1)(1\times 784)=128\times 784(128×1)(1×784)=128×784, la forme de W[1]W^{[1]}W[1]. Les quatre blocs du gradient sont maintenant écrits.

Combien des 128×784=100 352128\times 784=100\,352128×784=100352 coefficients sont nuls ?

La formule (4.10) permet de prédire ce compte avant de le faire, car le coefficient (j,i)(j,i)(j,i) de gradW[1] ℓ\mathrm{grad}_{W^{[1]}}\,\ellgradW[1]​ℓ vaut δj[1]xi\delta_{j}^{[1]}x_{i}δj[1]​xi​ et il est nul dès que l'un des deux facteurs l'est. Or δj[1]=0\delta_{j}^{[1]}=0δj[1]​=0 pour les 717171 neurones éteints, et xi=0x_{i}=0xi​=0 pour les pixels du fond, ceux que l'encre n'a pas touchés, dont la mesure 1 dit qu'il y en a 784−188=596784-188=596784−188=596.

Le compte des non nuls demande en outre qu'aucun des 57×18857\times 18857×188 produits restants ne s'annule par accident, ce que la prédiction suppose et que la mesure constate.

#{non nuls}=57×188=10 716,#{nuls}=100 352−10 716=89 636\#\{\text{non nuls}\}=57\times 188=10\,716,\qquad \#\{\text{nuls}\}=100\,352-10\,716=89\,636#{non nuls}=57×188=10716,#{nuls}=100352−10716=89636
(4.11)
Prédiction faite avant le comptage, à partir des seuls nombres de la mesure 1.

Les zéros de $\mathrm{grad}_{W^{[1]}}\,\ell$ · cours/lecon4/mesures.py, mesure 8

  -- La mesure -------------------------------------------------------------
  coefficients exactement nuls                   89636
  écart à la prédiction                          0

  nuls parce que le pixel d'entrée est nul       596 x 128 = 76288
  nuls parce que le neurone caché est éteint     71 x 188 = 13348
  somme des deux causes                          89636
  lignes de grad_W1 entièrement nulles           71 sur 128
  colonnes de grad_W1 entièrement nulles         596 sur 784
  part de coefficients nuls                      89.32 %

Lecture

  • ·

    La prédiction tombe juste, écart zéro, et c'est le contrôle le plus économique du chapitre puisqu'il ne demande aucun calcul de dérivée, seulement la structure de la formule (4.10).

  • ·

    Les deux causes se partagent les 89 63689\,63689636, et ce partage est un choix : 596×128596\times 128596×128 compte les coefficients des colonnes entièrement nulles, puis 71×18871\times 18871×188 ceux des lignes nulles parmi les colonnes qui restent. Compté dans l'autre ordre, 71×78471\times 78471×784 puis 596×57596\times 57596×57, le total est le même.

  • ·

    89,32 %89{,}32\,\%89,32% du gradient de la première couche est exactement nul sur cet exemple, et le procédé par différences finies aurait dépensé deux propagations avant pour chacun de ces 89 63689\,63689636 zéros.

Une couche de plus, et la forme générale

S'il y avait une troisième couche, le même geste se répéterait : la transposée de la matrice de la couche suivante prendrait la place de celle de W[2]W^{[2]}W[2], et la dérivée de l'activation de cette couche celle de ReLU′\mathrm{ReLU}'ReLU′. Ce chapitre n'écrit pas cette formule. La forme générale à LLL couches, la règle de la chaîne multivariée sous forme jacobienne et le traitement d'une fonction d'activation quelconque sont le chapitre 5. Ce qui est établi ici, c'est ce que l'algorithme fait sur un réseau à deux couches, et qu'il le fait juste.

Vérification rapide n° 45

Pour l'image de travail, 575757 neurones cachés sur 128128128 sont allumés, et l'image compte 188188188 pixels non nuls sur 784784784.

  1. a

    Combien de lignes de gradW[1] ℓ\mathrm{grad}_{W^{[1]}}\,\ellgradW[1]​ℓ sont entièrement nulles, et combien de colonnes ? Justifier par la formule (4.10).

  2. b

    Le même compte pour gradW[2] ℓ\mathrm{grad}_{W^{[2]}}\,\ellgradW[2]​ℓ : combien de ses 1 2801\,2801280 coefficients sont nuls, et pour quelle raison ?

Aucune réponse à cliquer : il y a un calcul à faire.

Leçon suivante
PrécédenteDix demandes, une sommeSuivanteUn exemple ne suffit pas