L'algorithme, et sa vérification
L'algorithme complet, et la vérification qu'il calcule bien ce qu'il prétend calculer.
Six égalités ont été posées sur une seule image, et rassemblées dans l'ordre elles forment un algorithme. Combien de fois faut-il alors traverser le réseau pour obtenir ses cent mille dérivées, et comment sait-on qu'elles sont justes ?
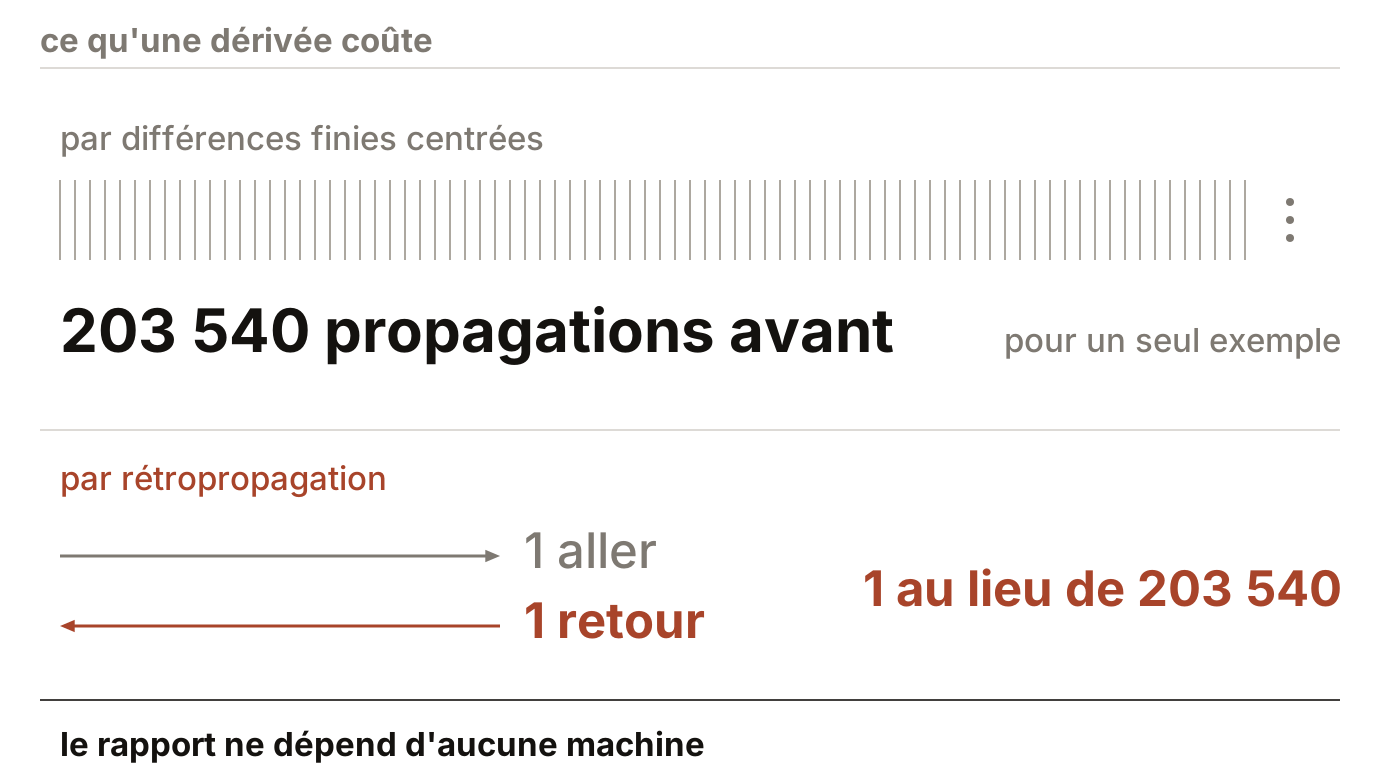
Le compte du haut est celui de la formule (4.1), deux propagations par coefficient ; celui du bas est ce que l'algorithme des pages 3 à 9 demande.
Ce rapport ne dépend ni de la machine, ni du langage, ni de la charge : les durées de la fin de page, elles, en dépendent toutes.
L'aller
Le retour
def avant(theta, x): # x : (784,) z1 = theta["W1"] @ x + theta["b1"] # (128, 784)(784,) -> (128,) a1 = np.maximum(z1, 0.0) # (128,) z2 = theta["W2"] @ a1 + theta["b2"] # (10, 128)(128,) -> (10,) a2 = softmax(z2) # (10,) return {"x": x, "z1": z1, "a1": a1, "z2": z2, "a2": a2} def arriere(theta, cache, c): d2 = cache["a2"] - onehot(c) # (10,) proposition 1 g_W2 = np.outer(d2, cache["a1"]) # (10, 128) proposition 4 g_b2 = d2 # (10,) proposition 3 g_a1 = theta["W2"].T @ d2 # (128,) proposition 6 d1 = g_a1 * (cache["z1"] > 0.0) # (128,) formule 4.9 g_W1 = np.outer(d1, cache["x"]) # (128, 784) proposition 4 g_b1 = d1 # (128,) proposition 3 return {"W1": g_W1, "b1": g_b1, "W2": g_W2, "b2": g_b2}Le commentaire de droite nomme, pour chaque ligne du retour, la proposition qui l'établit, sauf la première, qui est la formule (4.2) admise page 3. Le programme calcule avant , ce que rien n'interdit puisque les deux ne dépendent que de .
Ce qu'il faut garder entre l'aller et le retour
| Quantité gardée | Taille | Employée par |
|---|---|---|
, la porte | ||
Soit nombres à retenir, contre coefficients dans le réseau, et c'est tout ce qu'il met en mémoire : il ne recalcule rien, il se souvient. Le programme garde en outre , dont le retour ne se sert pas. Un procédé qui ne garderait rien devrait refaire la propagation avant à chaque dérivée, et l'on retomberait sur les différences finies.
La vérification
160 dérivées confrontées aux différences finies · cours/lecon4/mesures.py, mesure 2
  epsilon = 1e-05
  50 coefficients tirés dans chaque bloc PARMI CEUX DE DÉRIVÉE NON NULLE.

      bloc    non nuls / total    contrôlés   écart rel. médian   écart rel. max   écart abs. max
      W1         10716 / 100352            50          9.87e-11         6.62e-09         1.10e-11
      b1            57 / 128               50          9.44e-11         4.57e-09         2.35e-11
      W2           570 / 1280              50          2.13e-10         7.01e-09         2.02e-11
      b2            10 / 10                10          3.70e-11         1.52e-10         9.41e-12

  coefficients contrôlés                       160
  ÉCART RELATIF MAXIMAL SUR LES 160            7.013e-09
  écart relatif médian sur les 160             1.192e-10
  écart ABSOLU maximal sur les 160             2.354e-11

  -- Les dérivées nulles le sont aussi par différences finies --------------
  coefficients de dérivée analytique nulle contrôlés   150
  dont la différence finie vaut exactement zéro        150
Lecture
L'écart relatif maximal vaut sur coefficients, et c'est le juge que le chapitre 3 a posé : les identités donnent, à huit chiffres significatifs près, ce que donne la définition même de la dérivée.
Le tirage est restreint aux dérivées non nulles, et c'est délibéré : la mesure 8 montre que des coefficients de ont une dérivée exactement nulle, et les tirer au hasard dans ce bloc ferait passer le contrôle neuf fois sur dix sans rien contrôler.
Les dérivées nulles sont contrôlées à part, et elles le sont aussi numériquement, puisque coefficients sur donnent une différence finie exactement nulle. Ce n'est pas une coïncidence : perturber un poids qui part d'un neurone éteint ne change pas la sortie du réseau, donc pas la perte.
est le seul bloc exhaustif, ses dix coefficients étant tous contrôlés sans qu'aucun soit tiré, et son écart maximal de est aussi le plus petit des quatre.
D'où vient le peu qui reste
L'écart absolu ne dépend pas de la dérivée · mesure 2, suite
  |dérivée| médiane des 160 coefficients contrôlés   0.0448
  |dérivée| du coefficient d'écart relatif maximal    2.35e-03
  écart ABSOLU médian, dérivées sous la médiane       4.63e-12
  écart ABSOLU médian, dérivées au-dessus             5.68e-12
  écart RELATIF médian, dérivées sous la médiane      3.19e-10
  écart RELATIF médian, dérivées au-dessus            4.91e-11
  plancher d'annulation, eps_machine x l / (2 eps)    1.56e-11
Lecture
L'écart absolu médian est le même de part et d'autre, pour les petites dérivées et pour les grandes : il ne dépend pas de la dérivée qu'on mesure.
L'écart relatif, lui, varie d'un facteur , pour les petites dérivées contre pour les grandes, parce que c'est le même écart absolu divisé par un dénominateur plus petit.
La cause est nommée et chiffrée : est calculée à près, et la soustraction de deux valeurs voisines divisée par amplifie cette incertitude d'un facteur . Le plancher vaut : les écarts absolus médians sont en dessous d'un facteur trois, et les maximaux du même ordre que lui.
Ce n'est donc pas un défaut de l'algorithme mais une propriété de la mesure, et le coefficient qui affiche le plus grand écart relatif a une dérivée de , dix-neuf fois plus petite que la médiane .
Ce que l'algorithme économise
Le coût comparé · cours/lecon4/mesures.py, mesure 7
  -- Le compte des propagations, qui ne dépend d'aucune machine ------------
  coefficients du réseau                              101770
  différences finies centrées, propagations avant     203540
  rétropropagation, propagations avant                1
  rétropropagation, propagations arrière              1
  rapport des propagations avant                      203540

  -- Le temps unitaire, meilleur de trois séries de 2 000 appels -----------
  une propagation avant seule                    226.4 us
  un gradient complet par rétropropagation       2384.1 us

  -- Le même gradient par différences finies -------------------------------
  estimation, 203540 x le temps d'une propagation   46.1 s
  mesure réelle de la boucle complète            42.9 s
  écart entre l'estimation et la mesure          8 %

  -- Le rapport ------------------------------------------------------------
  différences finies / rétropropagation, estimé  19329
  différences finies / rétropropagation, mesuré  17975
Lecture
Le nombre qui compte est le premier, propagations avant contre une seule, et il ne dépend ni de la machine, ni du langage, ni de la charge : c'est contre , et il vaudrait sur un réseau de mille coefficients comme il vaut sur celui-ci.
Les durées dépendent en revanche de la machine et de sa charge, et celles reproduites ici viennent d'une exécution sur une machine chargée : elles ne valent pas comme mesure de performance, seulement comme ordre de grandeur.
L'estimation et la mesure réelle de la boucle s'accordent à , ce qui confirme que la boucle de différences finies ne fait rien d'autre que propagations avant.
Le rapport mesuré, , est plus petit que parce qu'une passe arrière n'est pas gratuite : elle refait de l'algèbre, dont deux produits extérieurs. C'est un facteur constant, et non un facteur qui croît avec .
Sur les coefficients contrôlés, l'écart absolu médian vaut pour les dérivées sous la médiane et pour celles au-dessus. L'écart relatif médian, lui, vaut contre .
- a
Pourquoi le rapport s'inverse-t-il d'une ligne à l'autre ? Répondre en écrivant la définition de l'écart relatif.
- b
Le plancher d'annulation vaut . Que deviendrait-il si l'on prenait au lieu de , et est-ce une bonne idée ?
Aucune réponse à cliquer : il y a un calcul à faire.