Synthèse, formulaire et erreurs fréquentes
La rétropropagation en un paragraphe, le formulaire, et les erreurs fréquentes.
Le retour est passé par six étapes, chacune établie sur sa page, et le formulaire les alignera sans dire ce qu'on récolte à chaque pas. Dans quel ordre s'exécutent-elles, et que récolte-t-on au passage ?
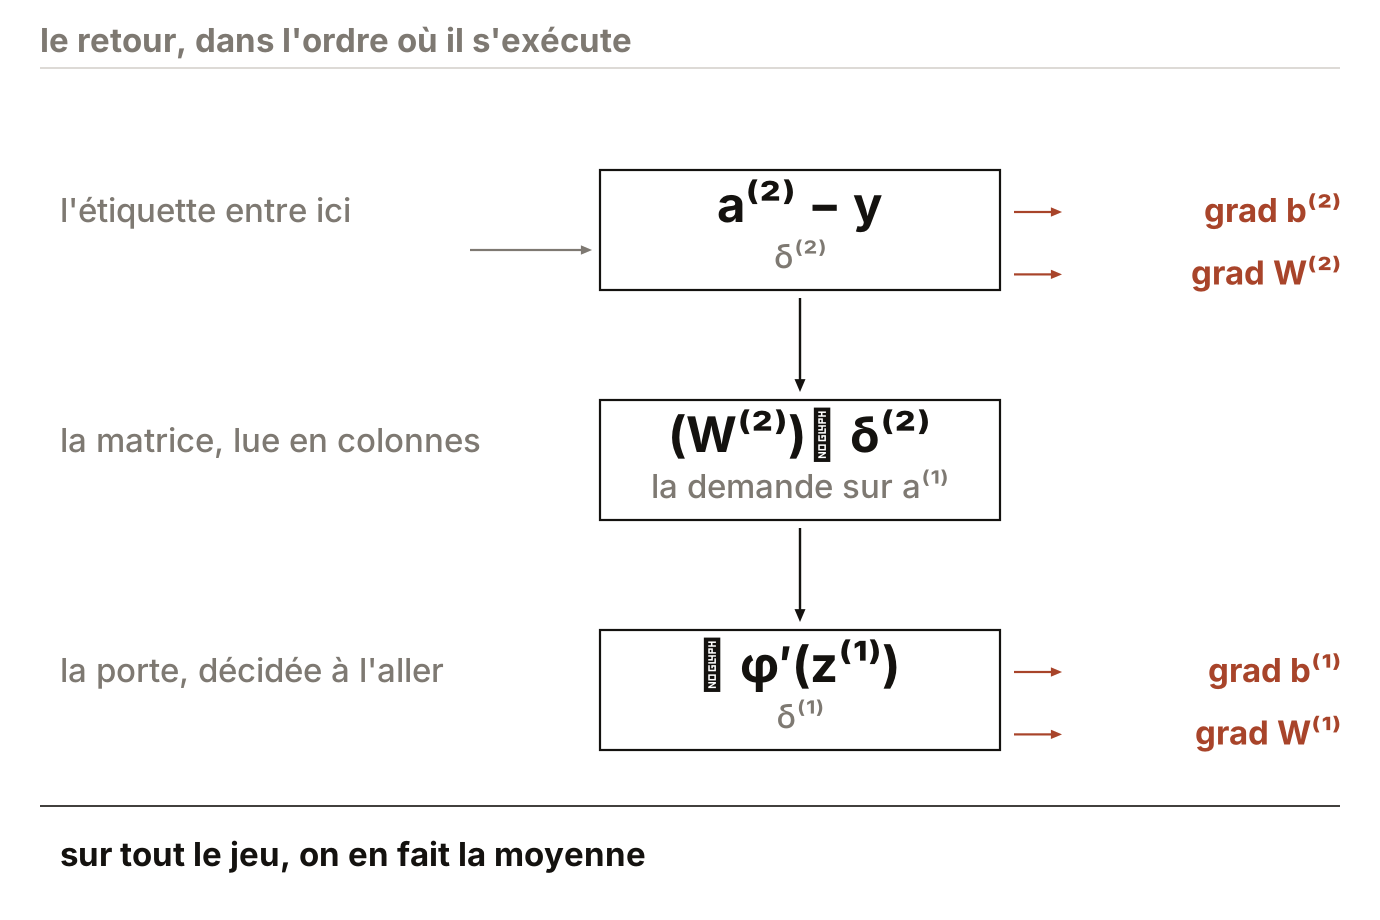
Chaque cadre transforme ce qu'il reçoit en un objet neuf, et les quatre gradients tombent en chemin, sans qu'il faille repasser par le réseau.
Les trois notes de gauche disent d'où vient ce qui entre dans chaque cadre : l'étiquette au premier, la matrice de la couche de sortie au deuxième, et au troisième la porte, dont l'ouverture a été décidée à l'aller par le signe de .
Le trajet, d'un bout à l'autre
Une image traverse le réseau et donne dix activations, l'étiquette dit ce qu'elles devraient être, et la différence est le signal d'erreur, dont une seule composante est négative, celle de la vraie classe, qui pèse autant que les neuf autres réunies.
Ce signal se transforme sans autre calcul en gradient des biais de sortie, et en produit extérieur avec les activations cachées pour le gradient des poids, d'où la proportionnalité exacte à l'activation.
Reporté sur la couche cachée par la transposée de la matrice, qui redistribue au retour ce qu'elle avait collecté à l'aller, il traverse , qui coupe ce qui arrive à un neurone éteint, et redevient un signal d'erreur. S'il y avait une couche de plus, la même mécanique recommencerait un cran plus bas. Sur tout le jeu, la moyenne de ces corrections est le gradient du coût, exactement.
Le réseau est allumé : la grille de l'image de travail à gauche, les trois colonnes remplies chacune à ses valeurs, la colonne cachée très inégalement. Une lueur de brique parcourt le premier faisceau de la gauche vers la droite, en cascade, puis le second, toujours vers la droite : c'est l'aller, et il va vite. Le réseau reste un instant immobile. Puis une lueur repart, du second faisceau cette fois, et elle va de la droite vers la gauche, plus lentement : elle quitte les dix ronds de sortie et gagne la colonne cachée. Elle s'arrête. Une seconde lueur repart du premier faisceau, toujours vers la gauche, et gagne la colonne d'entrée. Le même geste recommence une fois, dans le même ordre : de la sortie vers la couche cachée, puis de la couche cachée vers l'entrée. Rien d'autre ne bouge, aucun nombre ne s'écrit, et les activations ne changent pas.
Formulaire
Les objets du chapitre
| Symbole | Signification | Ensemble | Dimension | Rôle |
|---|---|---|---|---|
Signal d'erreur de la couche | Tout ce qu'il faut savoir de l'aval pour dériver la couche | |||
Produit de Hadamard | Appliquer la porte d'activation, sans mélanger les indices | |||
Produit extérieur | Écrire d'un coup les dérivées d'une matrice de poids | |||
, convention | scalaire, appliqué composante par composante | Décider si un neurone laisse passer le signal de retour | ||
Perte de l'exemple , vue comme fonction des paramètres | en entrée | Ce qu'on dérive. À ne pas confondre avec le du chapitre 2, qui prend une sortie et une étiquette | ||
Coût sur le jeu | en entrée | Ce que la descente minimise | ||
Gradient de la perte d'un exemple | en sortie | Ce que l'algorithme calcule |
L'algorithme, en pseudo-code
ENTRÉE x (784), c la classe, theta = {W1, b1, W2, b2}SORTIE grad_W1, grad_b1, grad_W2, grad_b2 ALLER x reçu garder x z1 <- W1 x + b1 garder z1 a1 <- ReLU(z1) garder a1 z2 <- W2 a1 + b2 a2 <- softmax(z2) garder a2 RETOUR d2 <- a2 - onehot(c) (10) grad_b2 <- d2 (10) grad_W2 <- d2 a1^T (10, 128) d1 <- (W2^T d2) ⊙ ReLU'(z1) (128) grad_b1 <- d1 (128) grad_W1 <- d1 x^T (128, 784) COÛT 1 propagation avant, 1 propagation arrière 1 050 nombres gardés entre les deuxErreurs fréquentes
| Ce qu'on écrit | Ce qu'il faut écrire | Page |
|---|---|---|
La rétropropagation approche le gradient | Elle le calcule exactement, puisque c'est la règle de la chaîne organisée et non une méthode numérique. Ce sont les différences finies qui approchent | 2 |
On retient la demande la plus forte parmi les dix | On les additionne, parce que la règle de la chaîne à plusieurs chemins l'impose ; retenir la plus forte donnerait au lieu de | 8 |
, car les deux produits existent et donnent contre , et seul le second a la forme de | 5 | |
Une dérivée nulle veut dire un poids nul | Elle veut dire que la perte ne dépend pas de ce poids sur cet exemple, parce que l'activation ou le pixel est nul. Le poids, lui, vaut ce qu'il vaut | 9 |
La dérivée par rapport au biais dépend des activations | Elle vaut et rien d'autre, ce qui distingue la voie du biais des deux autres | 4 |
La transposée est là pour que les dimensions tombent juste | Elle est la redistribution : la colonne de rend à l'activation ce que la ligne lui avait pris à l'aller | 8 |
Le réseau « pense » que l'image est un 2 | Il ne pense rien : l'étiquette impose la réponse attendue, et c'est elle qui rend négatif | 6 |
Un neurone éteint reçoit une petite correction | Il n'en reçoit aucune, puisque la porte annule sa composante et que les dix poids qui partent de lui ont une dérivée exactement nulle | 5 et 9 |
La moyenne des corrections est proportionnelle au gradient | Elle est le gradient, sans facteur ni approximation : c'est la linéarité de la dérivation | 10 |
est le gradient par rapport aux activations | , par rapport aux sommes pondérées. Les deux diffèrent d'un facteur , et le neurone de la mesure 3 les sépare : contre | 3 et 9 |
Les 🧪 de ce chapitre
| n° | Page | Ce qu'elle contrôle |
|---|---|---|
35 | 3 | La somme nulle et l'égalité , sur les nombres |
36 | 4 | Le sens de la poussée d'un biais, lu sur le signe de la dérivée |
37 | 4 | Pourquoi la dérivée d'un biais ne dépend d'aucune activation |
38 | 5 | Le rapport de deux corrections de poids d'une même ligne |
39 | 5 | Ce que devient un poids qui part d'un neurone éteint |
40 | 6 | Le signe qui décide qu'un poids augmente, et la classe qu'il désigne |
41 | 6 | Les deux raisons pour lesquelles l'analogie de Hebb est inexacte |
42 | 7 | Le sens demandé à une activation reliée par un poids négatif |
43 | 8 | Pourquoi on somme les dix demandes plutôt que d'en choisir une |
44 | 8 | Les dimensions de , et celles du produit sans transposition |
45 | 9 | Le compte des lignes et des colonnes nulles de |
46 | 10 | D'où vient la précision d'un réseau qui répond toujours |
47 | 10 | Ce que dit un cosinus de entre deux gradients d'exemples |
48 | 11 | Pourquoi l'écart relatif et l'écart absolu ne classent pas les blocs pareil |
Un réseau , même structure, même perte. Une image dont pixels sont non nuls, et pour laquelle neurones cachés sont allumés. Répondre sans écrire une seule ligne de code.
Attendu · Les quatre dimensions, le compte total de coefficients, les deux comptes de zéros, et le nombre de propagations avant des différences finies centrées.
La suite du parcours
Tout ce qui précède porte sur deux couches et sur , et les identités ne changeront pas de nature, mais leur écriture doit cesser de nommer et pour valoir en général.
C'est l'objet du chapitre 5 : la règle de la chaîne multivariée sous forme jacobienne, la récursion qui donne à partir de , et le traitement d'une fonction d'activation quelconque.