Le cadre du cours
Ce que le chapitre établit : le même calcul, pour un réseau d'autant de couches qu'on veut.
Un réseau qui apprend déplace ses poids d'un rien, dans le sens qui fait baisser son erreur, et il lui faut pour chacun d'eux un nombre qui dise de combien et dans quel sens. Que faut-il connaître d'un réseau pour savoir de combien bouger chacun de ses poids ?
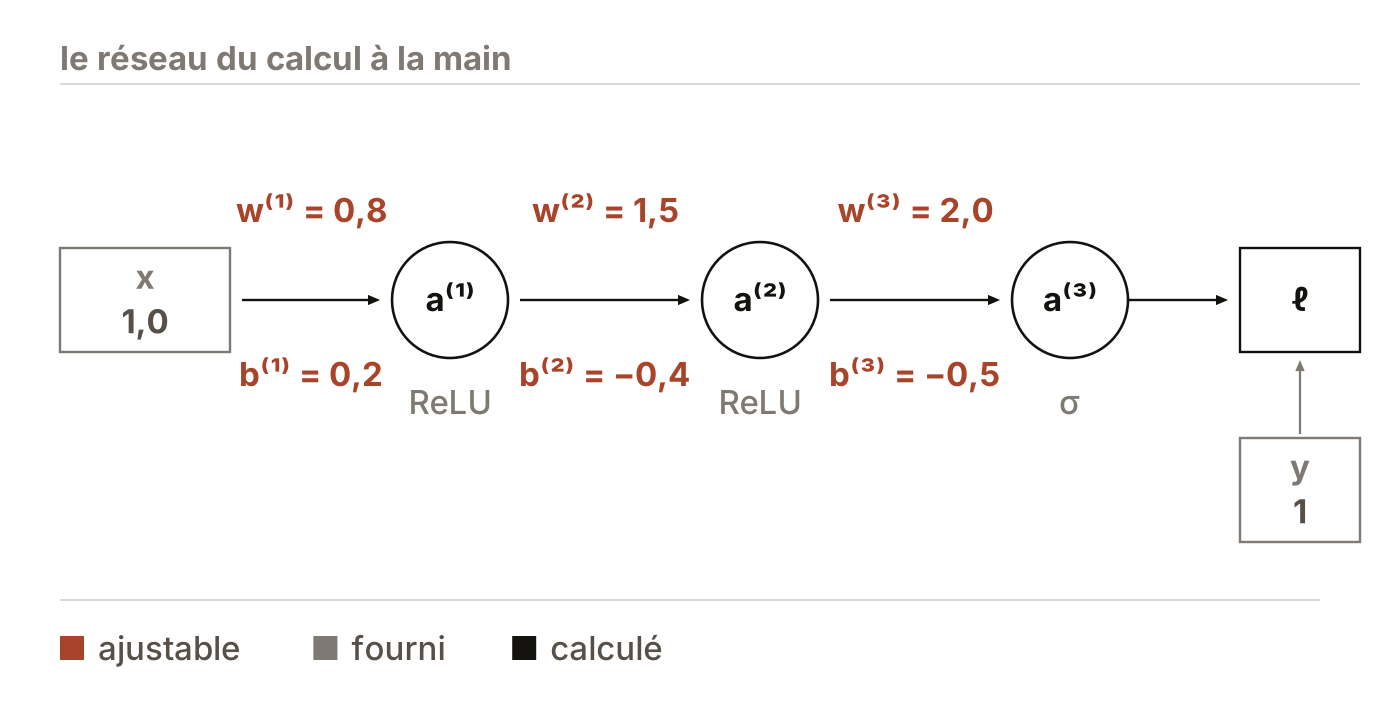
cours/lecon5/mesures.py, réseau minuscule.Ce réseau porte six paramètres, et chacun a son nombre : de combien la perte varie quand ce paramètre seul bouge d'un cheveu. Ces six nombres se calculent exactement, sans réévaluer le réseau une fois par paramètre, et le procédé qui les donne ne dépend ni du nombre de couches ni de l'activation choisie.
Prérequis
- 01
Le chapitre 4 en entier : le signal d'erreur , les trois voies, le produit de Hadamard, la transposée au retour.
- 02
La sigmoïde et sa dérivée , démontrée au chapitre 2, page 9, ainsi que l'entropie croisée, posée à la page 6 du même chapitre.
- 03
La dérivée partielle et la différence finie centrée , où dit de quelle composante de on parle, définies au chapitre 3, page 8.
- 04
Le produit matriciel et sa règle de dimensions : .
Objectifs
- 01
Énoncer la règle de la chaîne dans ses deux formes, et donner le critère qui dit laquelle s'applique.
- 02
Construire l'arbre des dépendances d'un réseau à un neurone par couche, et y lire la décomposition d'une dérivée.
- 03
Établir les trois dérivées constitutives , et , chacune à partir de l'équation dont elle sort.
- 04
Démontrer par récurrence que , avec son initialisation et son hérédité séparées.
- 05
Écrire comme un produit de poids et de dérivées d'activation, et en tirer la décroissance géométrique du gradient avec la profondeur.
- 06
Démontrer qu'avec plusieurs neurones par couche un seul terme change de nature, et que c'est de lui que vient la transposée.
- 07
Définir la jacobienne, la distinguer du gradient, et démontrer que celle de par rapport à est diagonale.
- 08
Majorer le coût de l'algorithme par trois propagations avant, et confronter cette majoration à une mesure.
- 09
Vérifier chaque identité par différences finies, sur le réseau minuscule puis sur un réseau à cinq couches.