Synthèse, formulaire et erreurs fréquentes
Le chemin d'une image jusqu'au chiffre, le formulaire, et les erreurs fréquentes.
Une image de vingt-huit sur vingt-huit entre d'un côté, un chiffre sort de l'autre, et tout ce qui a été construit tient entre les deux. Saurais-tu redire la chaîne complète sans regarder ? Entre l'image et le chiffre, cinq quantités se succèdent et six opérations les relient, et chacune de ces cinq quantités se mesure sur une image réelle.
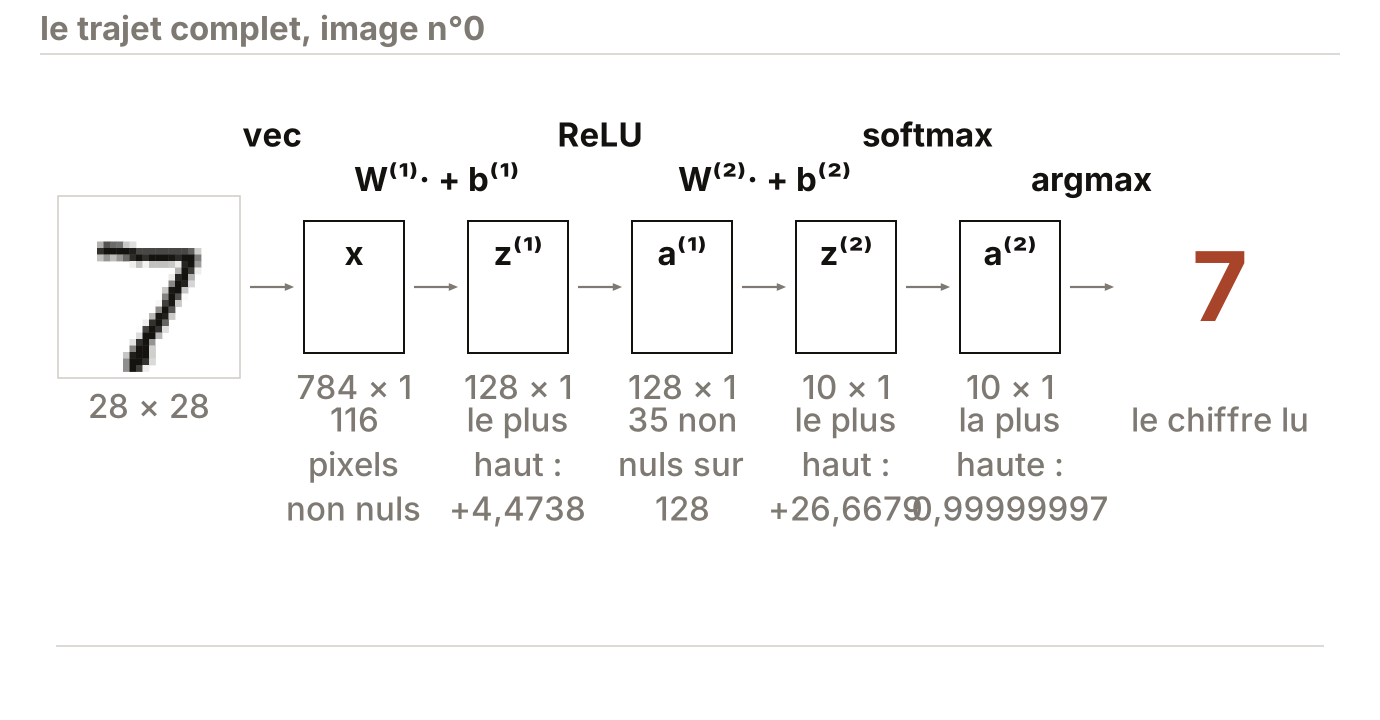
Le trajet
Une image devient un vecteur de par , sans rien perdre, mais la géométrie de la grille y devient invisible au modèle.
Un neurone calcule ensuite , où ses poids positifs disent où il cherche de l'encre et ses poids négatifs où il n'en veut pas, et en fait une image qu'on regarde. Dix neurones suivis d'un donnent une loi sur dix classes, et paramètres suffisent à atteindre .
Pourquoi ce premier modèle plafonne
Ce chiffre ne bouge plus que de quelques dixièmes de point, et la forme de la famille dit pourquoi il ne peut pas monter beaucoup : ses régions de décision sont convexes, quelle que soit la façon dont on l'entraîne, ce qui lui interdit certaines séparations. La proposition 2 dit cette forme et non un nombre d'erreurs ; la mesure, elle, la rend visible : sur paires dont les deux extrémités reçoivent la même classe, le milieu est classé ailleurs fois.
Ce que la non-linéarité change
Ajouter une couche sans rien entre les deux ne change rien : la famille obtenue est la même, ce que la double inclusion démontre, et les paramètres n'achètent que point.
Insérer , qui ne coûte aucun paramètre, rend le réseau affine par morceaux sur au plus régions. Le même compte de milieux mal classés, nul sur les paires du modèle sans activation, vaut sur les du réseau à ReLU, et les erreurs tombent de à .
Le réseau complet est la fonction , et regarder ce que sa couche cachée a appris montre que ce n'est pas ce qu'on espérait.
Formulaire
| Objet | Formule | Page |
|---|---|---|
Normalisation | 3 | |
Aplatissement | , | 3 |
Un neurone | 4 | |
Décomposition par signe | 4 | |
Gabarit | 4 | |
Une couche | 6 | |
Simplexe ouvert | 6 | |
Softmax | 6 | |
Invariance par translation | 6 | |
Cas binaire | 6 | |
One-hot | 6 | |
Perte | 6 | |
Prédiction | , hors ex æquo | 6 |
Précision | 6 | |
Région de décision | 7 | |
ReLU | , pour , et par convention en | 9 |
Sigmoïde | , | 9 |
Biais et seuil | 9 | |
Propagation avant | ; pour , et | 10 |
Compte des paramètres | 10 | |
Corrélation | 11 |
Tous les objets du chapitre
Notations d'ensembles et symboles généraux
| Symbole | Signification | Ensemble ou type | Dimension |
|---|---|---|---|
, , | Réels, réels positifs ou nuls, réels strictement positifs | Ensembles | · |
, | Entiers naturels, entiers naturels non nuls | Ensembles | · |
Intervalle d'entiers | Ensemble fini | éléments | |
Matrices réelles à lignes et colonnes | Espace vectoriel | ||
Matrices carrées, | Espace vectoriel | ||
Matrice identité | |||
Simplexe ouvert, lois de probabilité sur classes | coordonnées, degrés de liberté | ||
Indicatrice d'une condition | Scalaire | ||
Vecteur de uns | |||
-ième vecteur de la base canonique | |||
Produit scalaire canonique | Scalaire | ||
Norme euclidienne | Scalaire | ||
Matrice de permutation, | |||
Partie convexe de | · |
Fonctions, avec départ et arrivée
| Fonction | Départ | Arrivée | Page |
|---|---|---|---|
3 | |||
3 | |||
6 | |||
6 | |||
6 | |||
, où est l'ensemble des dont le maximum est atteint par au moins deux coordonnées | 6 | ||
9 | |||
9 | |||
appliquée composante par composante, où est une activation quelconque | 9 | ||
10 | |||
11 |
Données, paramètres et quantités calculées
| Symbole | Signification | Ensemble | Dimension | Nature |
|---|---|---|---|---|
Espace des entrées | · | Ensemble | ||
Espace des étiquettes | · | Ensemble fini | ||
, | Tailles des jeux | Constantes : , | ||
Indice d'exemple | · | Indice | ||
Image du -ième exemple | Donnée | |||
Étiquette, un code | Donnée | |||
, | Un lot de exemples, empilés en lignes | , | Donnée, page 10 | |
Image aplatie | Donnée | |||
Coordonnée | Donnée | |||
Étiquette encodée | Donnée dérivée | |||
, | Poids et biais d'un neurone | , | , | Paramètres appris |
, | Poids et biais d'une couche | , | , | Paramètres appris |
, | Poids et biais de la couche | , | , | Paramètres appris |
Tous les paramètres | Paramètres appris | |||
Nombre de paramètres | Calculé | |||
, , | Préactivations | , , | · | Calculées |
, | Activation cachée | , non borné | Calculée | |
Sortie | Calculée | |||
, | Gabarit d'un neurone, d'une classe | Lecture d'un paramètre | ||
Nombre de couches | , | Choisi | ||
Largeur de la couche | Choisi, sauf et | |||
Nombre de classes | Imposé : | |||
Largeur de la couche cachée | Choisi : , non justifié | |||
Seuil d'un neurone | ||||
Région de décision | · | Convexe sans activation, page 7 ; plus du tout avec ReLU, page 9 | ||
Région d'activation, une par partie des neurones allumés | · | Convexe, page 9 | ||
Matrice diagonale de et de | Calculée par région | |||
, | Familles de fonctions | · | · | Ensembles de fonctions |
, | Pas d'entraînement, posé page 6 ; taille d'un lot, posée page 10 | , | Réglages, traités au chapitre 3 |
La propagation avant, c'est-à-dire le trajet de l'image vers la réponse
ENTREE X matrice 28 x 28, coefficients entiers de 0 a 255 theta { W[1..L], b[1..L] }SORTIE a[L] vecteur du simplexe ouvert de dimension d_L - 1 1. X <- X / 255 coefficients dans [0, 1]2. a[0] <- vec(X) vecteur 784 x 13. pour l de 1 a L :4. z[l] <- W[l] . a[l-1] + b[l] (d_l x d_{l-1})(d_{l-1} x 1) = d_l x 15. si l < L : a[l] <- ReLU(z[l]) composante par composante6. sinon : a[l] <- softmax(z[l]) somme des coordonnees = 17. rendre a[L] Les a[l] sont gardes : le chapitre 3 en aura besoin couche par couche. PREDICTION c_chapeau <- (argmax_k a[L]_k) - 1 (indefinie si ex aequo)PLUS HAUT SCORE a[L]_{c_chapeau + 1} ce n'est pas une confiance, voir page 11Erreurs fréquentes
| L'erreur | Ce qui est vrai |
|---|---|
Écrire sans vérifier les dimensions | . Si les deux ne coïncident pas, le produit n'existe pas : ce n'est pas une convention, c'est une absence de définition |
Croire qu'un neurone porte toujours un nombre de | Avec , , ensemble non borné. Seule la sortie est dans |
Appliquer composante par composante | Chaque coordonnée dépend de toutes les autres par le dénominateur. Proposition 5 |
Confondre , et | Exemple, couche, composante. Aucun des trois n'est une puissance |
Prouver la proposition 3 par le rang de | Toute matrice de est de rang . L'argument ne restreint rien ; c'est la double inclusion qui démontre |
Croire que le plafond du modèle linéaire vient d'un mauvais entraînement | Il vient de la famille : les régions sont convexes pour tout . Proposition 2 |
Faire de l'arithmétique sur les étiquettes | est un code. ne veut rien dire, et c'est pourquoi existe |
Annoncer régions | C'est un majorant du nombre de morceaux, pas un compte. Le nombre de régions non vides dépend de et est bien plus petit |
Calculer directement | déborde. On retranche d'abord, ce qui ne change rien au résultat par l'invariance de la proposition 5 |
Prendre le biais pour le seuil | . Un neurone qui exige a un biais de |
Croire qu'ajouter des paramètres agrandit la famille | avec paramètres de plus. C'est la non-linéarité qui agrandit, pas le compte |
Croire que a coordonnées | Il en a . L'indice est sa dimension : la contrainte de somme retire un degré de liberté |
Utiliser comme s'il était partout défini | Il ne l'est pas en cas d'ex æquo. L'ensemble des ex æquo est d'épaisseur nulle dans le simplexe, ce qui justifie de l'ignorer, pas de l'oublier |
Les treize vérifications de ce chapitre
Les vérifications sont numérotées en continu sur tout le parcours, de à au chapitre 1 et de à ici. Les numéros ne suivent pas l'ordre des pages, et ils ne sont jamais réattribués.
| N° | Page | Section | Ce qu'elle demande |
|---|---|---|---|
8 | 2 | Ce que le jeu contient | Le compte des , et pourquoi le seuil est celui du |
9 | 3 | L'aplatissement | Le rang de , celui du pixel au-dessus, et l'écart justifié par la formule |
10 | 5 | Le détecteur de bord | Classer quatre entrées par score, en justifiant par la décomposition par signe |
11 | 4 | Le gabarit | Ce que vaut si l'encre tombe sur les poids négatifs, et pourquoi le minimum du est au centre |
12 | 6 | Une sortie complète | La classe prédite, la confiance du second choix, et l'effet d'une translation des scores |
13 | 6 | Le compte | , et pour classes et entrées, puis instanciés |
14 | 7 | Le corollaire | Ce qu'on conclut de deux images et d'un milieu classés différemment |
15 | 9 | La sigmoïde | , le débordement de , et l'écriture qui l'évite |
16 | 8 | La proposition 3 | Sa généralisation à trois couches, et la réfutation de l'argument du rang |
17 | 9 | ReLU | La dérivée en préactivation négative, et ce qu'on en déduit |
18 | 9 | Le biais | Le biais d'un neurone de seuil , et le signe justifié par le calcul |
19 | 10 | Le compte général | pour , et la part de la première matrice |
20 | 11 | Les quatre modèles | Lequel des deux changements produit l'écart, en citant les deux nombres |
Ce réseau, et les autres
Le réseau construit ici porte un nom : on l'appelle entièrement connecté, parce que chaque étape de calcul relie tous les nombres qui entrent à tous les nombres qui sortent, sans que rien d'autre s'y ajoute.
Ce n'est pas le meilleur outil pour lire des chiffres manuscrits, et le chapitre l'a mesuré, puisqu'un modèle bien plus simple atteint déjà . Des réseaux faits exprès pour les images dépassent , chiffre qui vient de la littérature et que ce cours n'a pas mesuré lui-même.
Il a ici deux qualités qui comptent davantage : il est assez petit pour se comprendre entièrement, jusqu'au dernier coefficient, et il s'entraîne en quelques minutes sur une machine ordinaire.
| Variante | Ce qu'elle ajoute | Où elle est traitée |
|---|---|---|
Réseaux convolutifs | Des poids partagés sur des voisinages de pixels, ce qui rend de nouveau visible la géométrie que la page 3 avait rendue invisible | Chapitre dédié, après les chapitres 2 à 5 |
Réseaux récurrents | Un état qui persiste d'une entrée à la suivante, pour des séquences de longueur variable | Parcours Séries temporelles |
Transformeurs | Un mécanisme qui pondère les positions les unes par les autres, sans récurrence | Parcours Focus avancé |
La suite du parcours
Chaque mesure de ce chapitre a été faite sur un modèle déjà entraîné, et d'où venaient ses nombres n'a jamais été dit. Les régler à la main demanderait heures à raison d'un par seconde, et il faudrait encore savoir quelle valeur donner à chacun.
La page 11 vient de montrer que personne ne le sait : même en les regardant après coup, on n'y reconnaît rien.
C'est l'objet du chapitre 3 : choisir ces nombres par la descente de gradient, sans qu'aucun humain n'en fixe un seul. Il y faudra le pas, l'initialisation, et la perte non convexe laissée en dette à la page 9.