Le cadre du cours
Ce que le chapitre règle : d'où viennent les nombres que le chapitre 2 utilisait sans le dire.
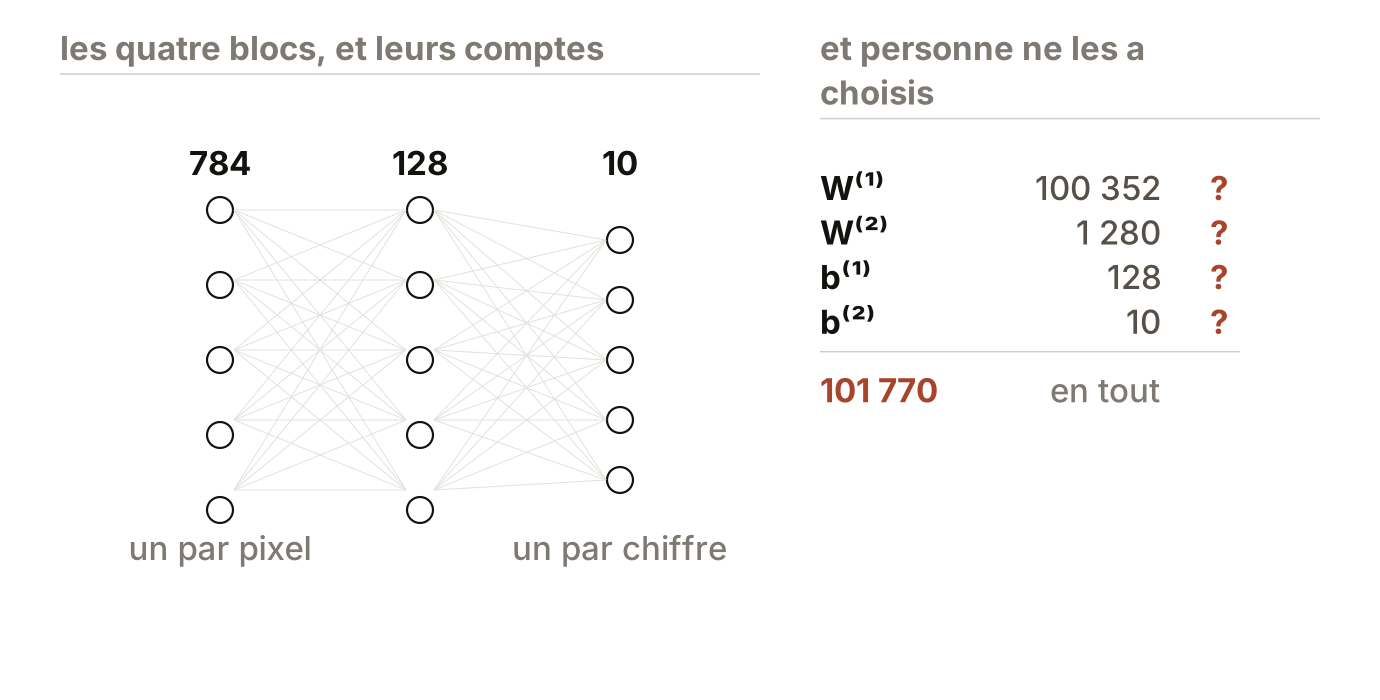
Un réseau qui lit un chiffre manuscrit contient plus de cent mille nombres. Qui les a choisis ?
Ce que ce chapitre établit
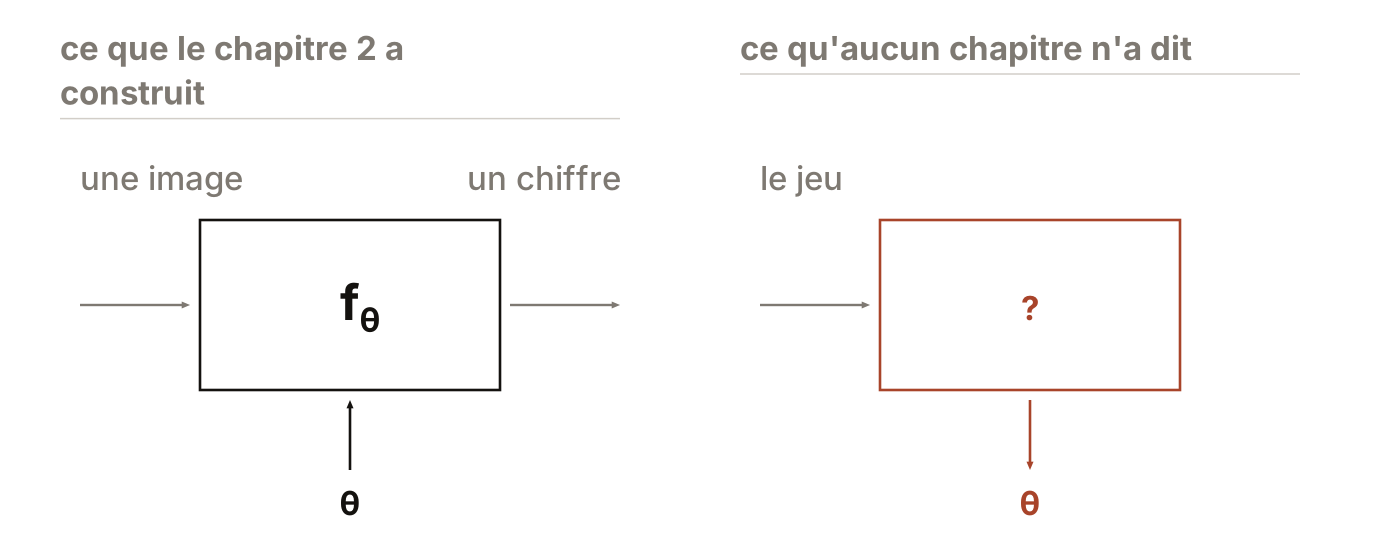
Le chapitre 2 a construit une fonction et a cité les valeurs de ses paramètres sans dire d'où elles venaient ; ce chapitre le dit, en établissant ce qu'on cherche, une valeur de qui minimise une fonction de coût, puis par quel procédé on la cherche, la descente de gradient.
Une chose reste dehors, et il vaut mieux le savoir en entrant : le calcul efficace du gradient. Ce chapitre obtient le sien par un procédé qui ne demande que des propagations avant, s'en sert pour toutes ses mesures, puis chiffre pourquoi ce procédé serait impraticable pour entraîner, et c'est ce chiffre qui ouvre le chapitre 4.
Prérequis
- 01
Les objets du chapitre 2 : l'entrée , les matrices , les biais , le quadruplet qu'ils forment, , , le simplexe , la perte et le compte .
- 02
Les objets du chapitre 1 : la perte sur un exemple, la fonction qu'on y annonce comme celle à minimiser, le pas et le compteur d'itérations .
- 03
La dérivée d'une fonction d'une variable, et sa lecture comme pente locale : signifie que croît au voisinage de .
- 04
Le développement au premier ordre d'une fonction dérivable, , où désigne une quantité dont le rapport à tend vers .
- 05
L'exponentielle et le logarithme népérien, et le fait que est strictement croissant sur .
- 06
La notion de partie convexe de , rappelée au chapitre 2 page 7.
Objectifs
- 01
Écrire le problème d'apprentissage comme la recherche d'un élément de , en disant précisément ce que cet ensemble contient.
- 02
Distinguer la perte d'un exemple du coût sur un jeu, et dire pourquoi ils ne prennent pas les mêmes arguments.
- 03
Démontrer que le taux d'erreur ne peut pas servir de coût, et en déduire la raison des activations continues.
- 04
Démontrer que le signe moins fait décroître le coût, et dire ce que cette démonstration ne donne pas.
- 05
Définir dérivée partielle, gradient et dérivée directionnelle, et typer chacun.
- 06
Démontrer que le gradient d'un mini-lot est sans biais, et que sa qualité croît comme la racine de la taille du lot.
- 07
Lire un gradient : le signe d'une composante, et sa taille relative.
- 08
Démontrer qu'un réseau à couche cachée a autant de jeux de paramètres de même coût qu'il y a de façons d'ordonner ses neurones cachés, et les construire explicitement.
- 09
Chiffrer le coût d'un gradient par différences finies, et dire pourquoi il faut autre chose.
Plan
- 01
Rappeler ce que le chapitre 2 a construit, et ce qui y manquait
- 02
Dire ce qu'apprendre veut dire : écrire l'algorithme qui règle, pas celui qui reconnaît
- 03
Mesurer ce que vaut un réseau au départ
- 04
Choisir la fonction qui juge une réponse, et trancher entre deux candidates par une mesure
- 05
Passer de la perte d'un exemple au coût sur tout le jeu
- 06
Descendre, en dimension un, et démontrer qu'on ne peut pas minimiser ce qu'on veut vraiment
- 07
Descendre en dimension quelconque : le gradient, le taux d'apprentissage, et ce qu'il coûte
- 08
Comprendre pourquoi on n'utilise jamais tout le jeu d'un coup
- 09
Lire ce qu'un gradient encode : le signe, et la taille relative
- 10
Constater qu'il n'y a pas une bonne réponse, mais un nombre gigantesque
- 11
Synthèse, formulaire, tableau des objets, erreurs fréquentes
Ce que ce chapitre règle
Le chapitre 2 a nommé trois dettes envers celui-ci, et il a en outre employé trois réglages sans les justifier. Les six se règlent ici, à l'endroit que le tableau indique. Ses deux autres dettes, la forme de la sigmoïde et la géométrie de la grille, vont à d'autres cours, et ce chapitre ne les touche pas.
| Ce que le chapitre 2 a laissé | Réglé page | Comment |
|---|---|---|
Dette nommée : d'où viennent les paramètres cités page 4 | 4 | Par le procédé que ce chapitre construit ; la mesure du réseau au départ ouvre la démonstration |
Dette nommée : annoncé comme non justifié | 11 | Par une mesure : cinq largeurs, même protocole, précision et durée |
Dette nommée : la perte cesse d'être convexe en | 7 et 11 | Par la définition de la convexité page 7, puis la proposition 6 page 11 |
Réglage non justifié : , et sa conséquence | 10 | Par la lecture des composantes du gradient couche par couche |
Réglage non justifié : les mini-lots de | 9 | Par les propositions 4 et 5, et la mesure du cosinus pour cinq tailles |
Réglage non justifié : contre | 8 | Par un balayage de sept valeurs, et l'aveu que rien ici ne permet de prédire le bon réglage |
Ce que ce chapitre laisse ouvert
| Dette | D'où elle vient | Chapitre qui la rembourse |
|---|---|---|
La preuve que le gradient est la direction de plus forte croissance | Page 8 : la proposition 3 est énoncée et vérifiée numériquement, non démontrée | Optimisation · l'approximation au premier ordre et Cauchy-Schwarz |
Le seuil exact sur au-delà duquel la descente diverge | Page 7 : la proposition 2 dit « pour assez petit » sans quantifier | Optimisation |
Le cadre probabiliste de , et de l'indépendance | Page 9 : les trois sont posés au strict nécessaire pour les propositions 4 et 5 | Fondements probabilistes |
Le coût de test qui remonte alors que le coût d'entraînement descend | Page 8 : la mesure de la norme du gradient le fait apparaître sans le traiter | Évaluation · sur-apprentissage |