• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
25/59
Lecture4 min

Ce qu'on a construit, et ce qui manque

Le chapitre 2 en une page, et la question qu'il n'a jamais posée : qui choisit les paramètres ?

Le chapitre précédent a construit deux réseaux pour la même tâche, un petit et un grand. Qu'est-ce que le grand achète de plus, et à quel prix ?
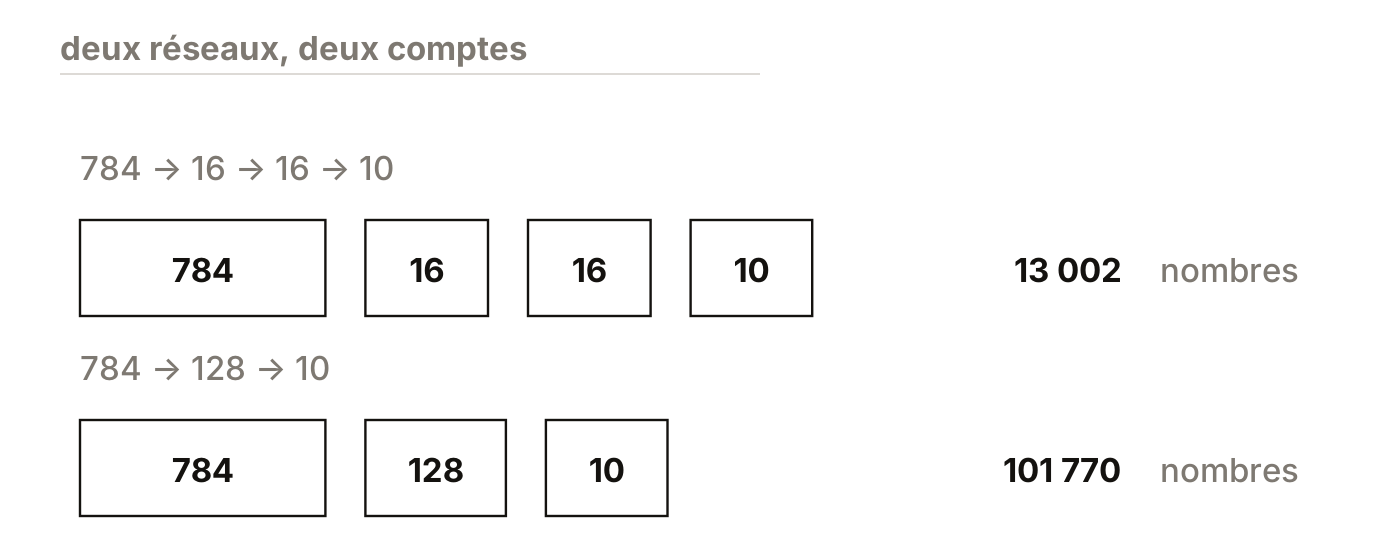
Deux rangées de rectangles. La rangée du haut porte quatre rectangles nommés 784, 16, 16 et 10, et se termine par le nombre treize mille deux. La rangée du bas porte trois rectangles nommés 784, 128 et 10, et se termine par le nombre cent un mille sept cent soixante-dix. La largeur de chaque rectangle suit le nombre de neurones de sa couche.
La seconde est celle que ce chapitre entraîne, avec le même protocole qu'au chapitre 2.

Ce que le chapitre 2 a construit

Une image de 28×2828\times 2828×28 pixels devient un vecteur x\mathbf{x}x de 784784784 nombres compris entre 000 et 111, sur lequel chaque neurone d'une couche calcule une somme pondérée des activations qui le précèdent, plus un biais, avant qu'une fonction non affine ne s'applique au résultat. La dernière couche compte dix neurones, un par chiffre, et softmax\mathrm{softmax}softmax transforme leurs dix scores en une loi de probabilité sur les dix classes : le plus actif des dix est la réponse du réseau. Sa valeur n'est pas une confiance, et le chapitre 2 l'a montré page 11.

Les deux architectures du chapitre 2, et leurs comptes

ArchitectureDétail du comptepppPrécision de test

784→16→16→10784\rightarrow 16\rightarrow 16\rightarrow 10784→16→16→10

16⋅784+16+16⋅16+16+10⋅16+1016{\cdot}784+16+16{\cdot}16+16+10{\cdot}16+1016⋅784+16+16⋅16+16+10⋅16+10

13 00213\,00213002

0,94370{,}94370,9437

784→128→10784\rightarrow 128\rightarrow 10784→128→10

128⋅784+128+10⋅128+10128{\cdot}784+128+10{\cdot}128+10128⋅784+128+10⋅128+10

101 770101\,770101770

0,98140{,}98140,9814

Chaque produit s'écrit sortie fois entrée, dans l'ordre des dimensions de la matrice : W[1]W^{[1]}W[1] du second réseau a 128128128 lignes et 784784784 colonnes. Les 88 76888\,76888768 paramètres de plus achètent 3,773{,}773,77 points de précision, et la page 11 mesure ce que coûterait le point suivant.

On appelle θ\boldsymbol{\theta}θ l'ensemble de ces 101 770101\,770101770 nombres, et il se range en quatre blocs : les deux matrices W[1]W^{[1]}W[1] et W[2]W^{[2]}W[2], les deux vecteurs de biais b[1]\mathbf{b}^{[1]}b[1] et b[2]\mathbf{b}^{[2]}b[2]. Les quatre ne pèsent pas le même poids, et la conséquence occupera la page 10 : corriger W[1]W^{[1]}W[1] et corriger b[2]\mathbf{b}^{[2]}b[2] ne sont pas deux gestes comparables.

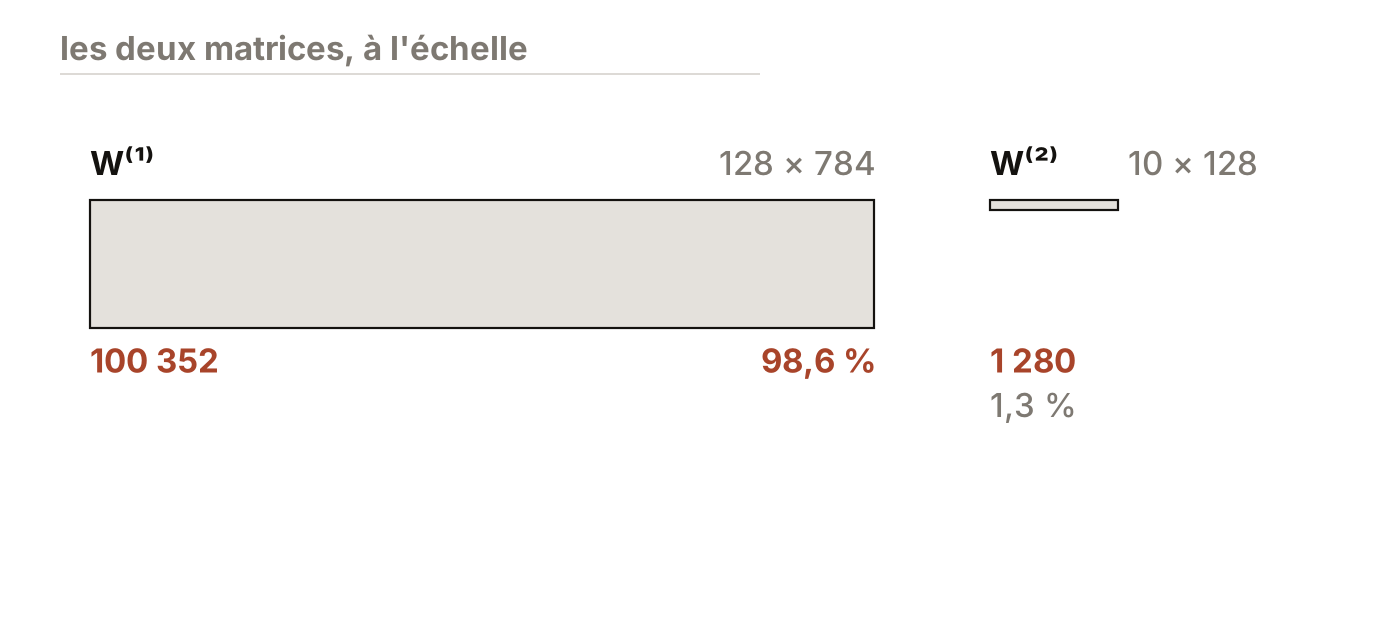
Deux rectangles gris dessinés à la même échelle, un coefficient par unité de longueur. Le premier, nommé W exposant un, est large et haut : cent vingt-huit sur sept cent quatre-vingt-quatre, soit cent mille trois cent cinquante-deux coefficients, et il porte la mention quatre-vingt-dix-huit virgule six pour cent. Le second, nommé W exposant deux, est une bande étroite de dix sur cent vingt-huit, soit mille deux cent quatre-vingts coefficients, et il porte la mention un virgule trois pour cent.
Les deux matrices sont dessinées à la même échelle : une unité de longueur pour un coefficient.
Le réseau, ses poids tirés à la graine 000, propage une image : la colonne des dix sorties s'allume, et aucune n'a encore de raison de l'emporter.

Le réseau occupe tout l'écran : à gauche une grille carrée de vingt-huit cases sur vingt-huit, puis trois colonnes de ronds vides reliées par deux nappes de traits très pâles, et à droite une colonne de dix ronds portant chacun son chiffre, de zéro à neuf. Les deux premières colonnes sont abrégées par des points de suspension, avec une accolade qui porte leur taille vraie, sept cent quatre-vingt-quatre et cent vingt-huit. La grille se remplit du dessin d'un chiffre manuscrit en niveaux de gris. Ses cases encrées se détachent alors une à une et filent vers la colonne d'entrée, dont les ronds se remplissent d'encre à mesure. Une vague de brique traverse ensuite la première nappe de traits, de gauche à droite, et la colonne du milieu se remplit derrière elle, très inégalement : certains ronds deviennent presque noirs, beaucoup restent vides. La même vague traverse la seconde nappe, et les dix ronds de sortie se remplissent à leur tour. Aucun ne s'impose : le plus foncé l'est quatre fois plus que le plus pâle, là où un réseau entraîné en noircirait un seul et laisserait les neuf autres presque vides. Le plus rempli d'entre eux voit enfin son contour passer à la brique, et ce n'est pas celui du chiffre dessiné dans la grille.

0:00 / 0:10

L'espoir des bords, et son démenti

Le chapitre 2 a bâti l'idée qu'un neurone caché pourrait détecter une boucle ou un trait, et que la hiérarchie pixels, bords, motifs, chiffres se lirait dans les poids. La mesure l'a écartée : la corrélation maximale entre un gabarit caché et un gabarit de classe vaut 0,48940{,}48940,4894, la moyenne 0,08530{,}08530,0853, et aucun couple ne dépasse 0,50{,}50,5. Le réseau atteint donc 98,14 %98{,}14\,\%98,14% sans que ce qu'il a trouvé ressemble à ce qu'on espérait qu'il trouve.

Ce qui manque

Chaque nombre cité au chapitre 2 sortait d'un réseau déjà entraîné : le gabarit du 000 dont le minimum tombe en (16,15)(16,15)(16,15), les 353535 neurones allumés sur l'image de test n°0, la précision de 0,98140{,}98140,9814, les 186186186 erreurs. Le chapitre l'a dit à chaque fois, et il n'a jamais dit comment ces 101 770101\,770101770 nombres avaient été obtenus.

Il n'a pas non plus dit d'où venaient la largeur h=128h=128h=128, le taux η=0,5\eta=0{,}5η=0,5 et les lots de 646464, ni ce que ReLU\mathrm{ReLU}ReLU fait perdre à la perte, ni ce que coûte le fait que σ′\sigma'σ′ ne dépasse jamais 1/41/41/4. Six questions en tout, et le tableau de la page 1 dit où chacune se règle.

Quatre notations d'indice, dont deux qui se ressemblent

ÉcritureCe qu'elle désigneCe qu'elle n'est pas

x(n)x^{(n)}x(n)

Le nnn-ième exemple du jeu

Une puissance

W[l]W^{[l]}W[l]

La couche lll du réseau

Ni une puissance, ni un exemple

θt\boldsymbol{\theta}_{t}θt​

La valeur de θ\boldsymbol{\theta}θ à l'itération ttt

Une composante de θ\boldsymbol{\theta}θ

θi\theta_{i}θi​

La iii-ième composante de θ\boldsymbol{\theta}θ

Une itération

Les deux derniers ne diffèrent que par la lettre mise en indice, et ils ne désignent pas la même chose. Dans tout ce chapitre, ttt est réservé aux itérations et iii aux composantes, sans exception, et le gras distingue le vecteur θt\boldsymbol{\theta}_{t}θt​ du scalaire θi\theta_{i}θi​.

Les objets du chapitre 2 sont donc en main, et le procédé qui choisit θ\boldsymbol{\theta}θ manque toujours. Avant de le construire, il faut dire ce qu'on lui demande.

Leçon suivante
PrécédenteLe cadre du coursSuivanteCe que veut dire apprendre