Ce que la couche cachée a appris
Les neurones cachés détectent-ils des bords, comme on aime le croire ? On va regarder.
On aime croire qu'un réseau qui a appris découpe le problème comme nous le ferions : d'abord des bords, puis des boucles, puis des chiffres. L'espoir est séduisant, et il est répandu. La seule façon de savoir s'il est vrai est d'aller regarder ce que les neurones cachés font réellement, et de le mesurer plutôt que de l'imaginer.
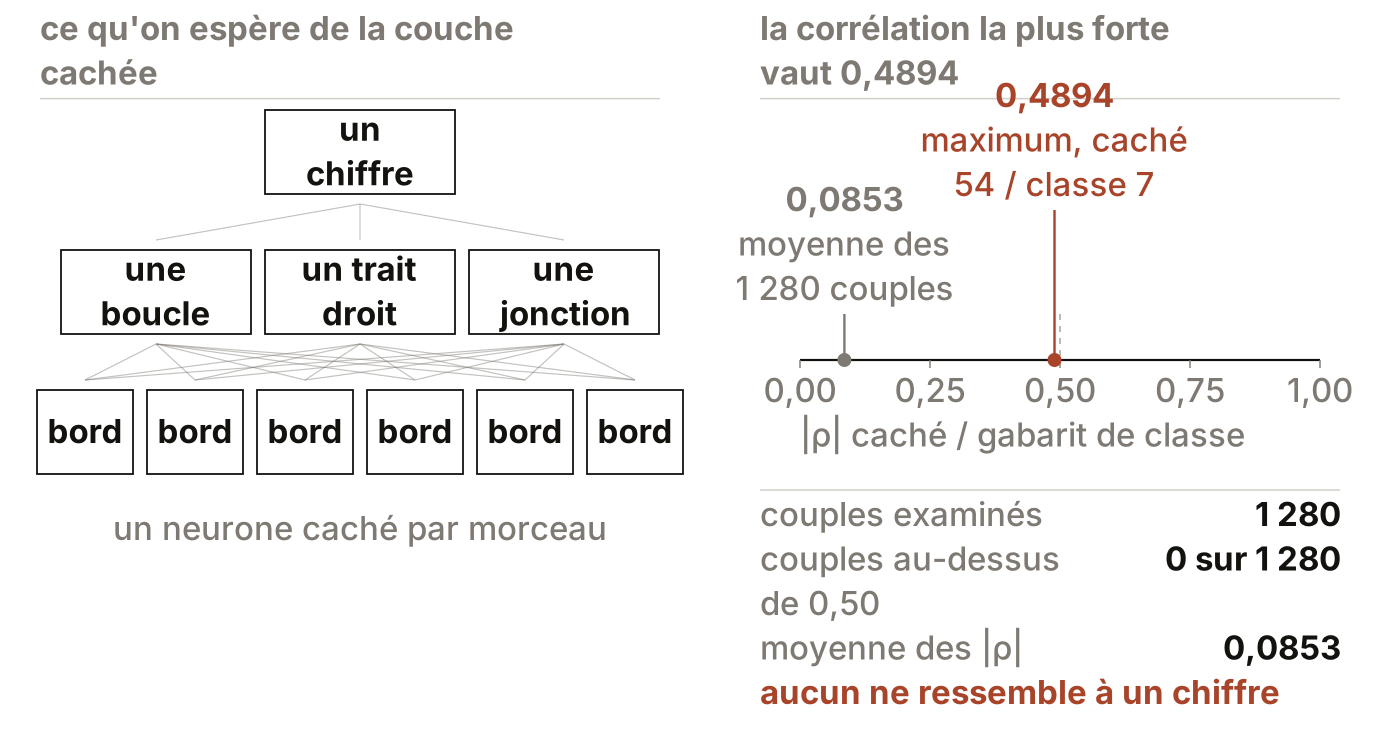
Ce qu'on peut espérer
Un chiffre manuscrit se décompose. Un est fait de deux boucles superposées ; un d'une boucle en haut et d'un trait vertical ; un de deux obliques et d'une barre. Ces morceaux reviennent d'un chiffre à l'autre : la même boucle sert au , au , au et au .
On peut donc espérer ceci, et c'est précis : que la couche cachée détecte ces morceaux. Qu'un neurone caché s'active sur une boucle en haut de l'image, un autre sur un trait vertical à droite, un autre sur une barre horizontale. La couche de sortie n'aurait alors qu'à combiner : un est une boucle en haut et un trait à droite, ce qui est exactement une somme pondérée de deux activations.
L'espoir, prolongé d'un cran
Une boucle n'est pas non plus un objet élémentaire : elle se décompose en petits bords orientés, et un trait long est un bord long. Une première couche détecterait donc des bords, une seconde des motifs faits de bords, et la sortie des chiffres faits de motifs. C'est la hiérarchie .
La hiérarchie espérée
| Niveau | Ce qui y serait détecté | Où |
|---|---|---|
Entrée | Des intensités, une par pixel | , coordonnées |
Premier niveau | Des bords orientés, courts et locaux | , coordonnées |
Deuxième niveau | Des motifs : boucles, barres, obliques | Une seconde couche cachée |
Sortie | Des chiffres, combinaisons de motifs | , coordonnées |
Deux raisons de plus rendent cet espoir raisonnable. D'abord, détecter des bords sert à d'autres tâches d'image que la lecture de chiffres, si bien qu'une couche qui les détecterait serait réutilisable, ce qui est le propre d'une bonne représentation.
Ensuite, le même découpage en niveaux s'observe ailleurs, la parole se décomposant en sons, puis en syllabes, puis en mots, et l'idée qu'un système d'apprentissage retrouve spontanément une telle hiérarchie a de quoi séduire.
Ce que la mesure dit
a lignes de coefficients. Chacune se replie en gabarit par , exactement comme à la page 4 : on peut donc regarder ce que chaque neurone caché cherche, au lieu de le supposer.
Quatre gabarits cachés · cours/lecon2/mesures.py, section 7
      j       max        position       min        position
      66       +0.5306   (10, 18)      -0.5128   ( 7, 17)
      5        +0.3662   (16, 12)      -0.4551   (20, 11)
      114      +0.3251   (12, 21)      -0.3449   (17, 15)
      81       +0.2671   (17, 14)      -0.5621   (19, 16)
Lecture
Les amplitudes sont nettement plus faibles que celles des gabarits de classe de la page 4, qui allaient de à : les quatre lignes affichées ne vont que de à , soit à peu près le tiers. Un neurone caché ne tranche pas, il pousse un peu.
Ces quatre lignes sont les quatre premières que le programme affiche, et non celles dont la mesure parlera plus bas.
Le maximum et le minimum sont souvent proches l'un de l'autre, trois lignes d'écart pour , ce qui ressemble localement à un contraste. C'est ce qui rend la question intéressante, et c'est pourquoi elle demande une mesure et non un coup d'œil.
Ressembler, mesuré
vaut pour deux images identiques à une échelle et un décalage près, et pour deux images sans rapport, mais une valeur intermédiaire comme ne veut rien dire tant qu'on n'a rien à quoi la comparer. Le programme fabrique donc la référence qui manque, en mesurant combien deux détecteurs de bord authentiques de la même famille se ressemblent entre eux.
L'espoir, tranché des deux côtés · cours/lecon2/mesures.py, section 7
      correlation maximale en valeur absolue   0.4894
      atteinte entre le gabarit cache j = 54 et le gabarit de classe 7
      moyenne des |rho| sur les 1 280 couples  0.0853
      couples au-dessus de 0,5                 0 sur 1 280

      famille de detecteurs de bord construits a la main   168
      correlation maximale gabarit cache / detecteur   0.4275
      atteinte par le gabarit cache j = 101
      moyenne des |rho| sur les 21504 couples        0.0593
      gabarits caches ayant un |rho| > 0,5 avec un detecteur   0 sur 128
      Pour reference, la correlation d'un detecteur de bord avec un
      detecteur voisin de la meme famille vaut :
        maximum entre deux detecteurs distincts       0.7864
Lecture
Contre les gabarits de chiffres. Le meilleur des couples atteint pour une moyenne de , et le programme compte combien dépassent , une demi-corrélation prise comme repère commode : il n'y en a aucun.
Contre les détecteurs de bord. Le programme construit détecteurs à la main sur le modèle de la page 5, à diverses positions de la grille et dans les deux orientations. Le meilleur des couples atteint pour une moyenne de , et aucun gabarit caché ne dépasse avec aucun détecteur.
La référence. Deux détecteurs distincts de cette même famille se corrèlent jusqu'à entre eux. C'est l'échelle : sur ce barème, un vrai détecteur de bord reconnaît ses voisins à , et le meilleur gabarit caché n'en reconnaît aucun au-delà de .
La réponse est non. Les neurones cachés ne détectent ni des chiffres, ni des bords au sens où la page 5 en a construit un.
Les quatre modèles
Le tableau complet · cours/lecon2/mesures.py, section 10
    modele                                 activation  parametres   acc_test   erreurs
    1  784 -> 10                           aucune           7850     0.9193       807
    2  784 -> 128 -> 10                    aucune         101770     0.9256       744
    3  784 -> 128 -> 10                    ReLU           101770     0.9814       186
    4  784 -> 16 -> 16 -> 10               ReLU            13002     0.9437       563

    de 1 a 2 : 807 -> 744 erreurs, pour 93920 parametres de plus
              soit +0.63 point
    de 2 a 3 : 744 -> 186 erreurs, a nombre de parametres IDENTIQUE
              soit +5.58 points, erreurs divisees par 4.0
Lecture
De 1 à 2 : paramètres de plus achètent erreurs de moins. La proposition 3 dit pourquoi : la famille est la même.
De 2 à 3 : à nombre de paramètres identique, une fonction qui n'en coûte aucun fait tomber les erreurs de à . Ce ne sont pas les paramètres qui achètent la performance, c'est la non-linéarité.
Le modèle 4, , atteint et fait erreurs avec paramètres, en regard de et erreurs pour les du modèle 3.
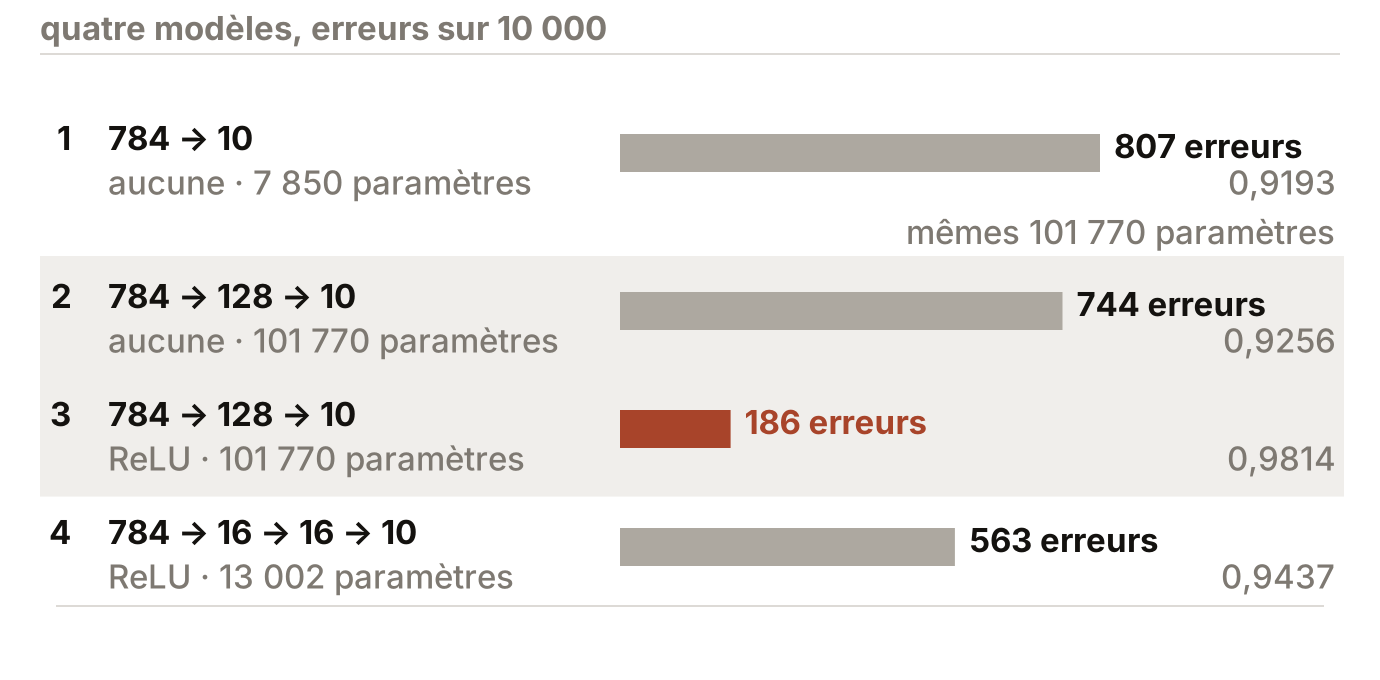
Le tableau constate la chute de à sans l'expliquer, et c'est la mesure de la page 7 qui l'éclaire. Sur paires dont les deux extrémités sont classées dans la même classe, le modèle sans activation classe le milieu ailleurs fois, quand le réseau à ReLU le fait fois sur .
Le premier n'a donc aucune liberté de décision entre deux images d'une même classe, et le second en a une. C'est cette liberté, et non les paramètres qui sont en nombre identique, qui sépare les deux modèles ; combien des erreurs évitées viennent d'elle, la mesure ne le dit pas.
Le tableau des quatre modèles se lit sans commentaire.
- a
Deux changements séparent le modèle 1 du modèle 3 : plus de paramètres, et une non-linéarité. Lequel des deux produit l'écart ?
- b
Citer les deux nombres qui le prouvent, et dire pourquoi ce sont ceux-là et pas d'autres.
- c
Le modèle 4 a moins de paramètres que le modèle 2 et fait moins d'erreurs. Cela contredit-il la lecture précédente ?
Aucune réponse à cliquer : il y a un calcul à faire.
Les erreurs, regardées
Ce que le réseau rate · cours/lecon2/mesures.py, section 7
      erreurs                                  186 sur 10 000
      erreurs avec probabilite > 0,99          30
      erreurs avec probabilite > 0,90          87
      probabilite mediane des erreurs          0.8755

      LES SIX ERREURS LES PLUS CONFIANTES
        indice   verite   predit   probabilite
          3520        6        4        1.0000
          1112        4        6        1.0000
           247        4        2        1.0000
          1226        7        2        0.9999
           445        6        0        0.9999
          4497        8        7        0.9999

      LES SIX CONFUSIONS LES PLUS FREQUENTES
        vrai 5 lu 3 : 8 fois
        vrai 7 lu 2 : 8 fois
        vrai 4 lu 9 : 8 fois
        vrai 7 lu 9 : 8 fois
        vrai 2 lu 8 : 7 fois
        vrai 3 lu 9 : 7 fois
Lecture
erreurs sur sont commises avec une probabilité supérieure à , la probabilité médiane d'une erreur valant : le réseau ne dit pas qu'il hésite, il se trompe en étant certain. La probabilité dont il s'agit est celle de la classe qu'il a prédite, la plus grande coordonnée de .
La sortie ressemble à une confiance et n'en est pas une. Rien dans ce chapitre n'a demandé qu'elle en soit une : ramène des scores à une somme de un sans rien promettre sur leur valeur, et rien n'oblige une sortie de à se tromper une fois sur cent.
Les confusions les plus fréquentes sont celles qu'un œil humain comprend : lu , lu , lu . Ce sont des chiffres dont les tracés se ressemblent, et non des erreurs arbitraires.