Le réseau écrit une fois pour toutes, et le compte des nombres que personne ne réglera à la main.
Le réseau à ReLU de la page 9 lit les chiffres bien mieux que tout ce qui précède, et il reste à l'écrire en entier une bonne fois. Jusqu'ici chaque modèle a été posé à la main, un cas à la fois, avec ses dimensions écrites en clair. Peut-on écrire une seule fois la formule d'un réseau quelconque, puis compter d'un coup combien de nombres il faudrait régler ?
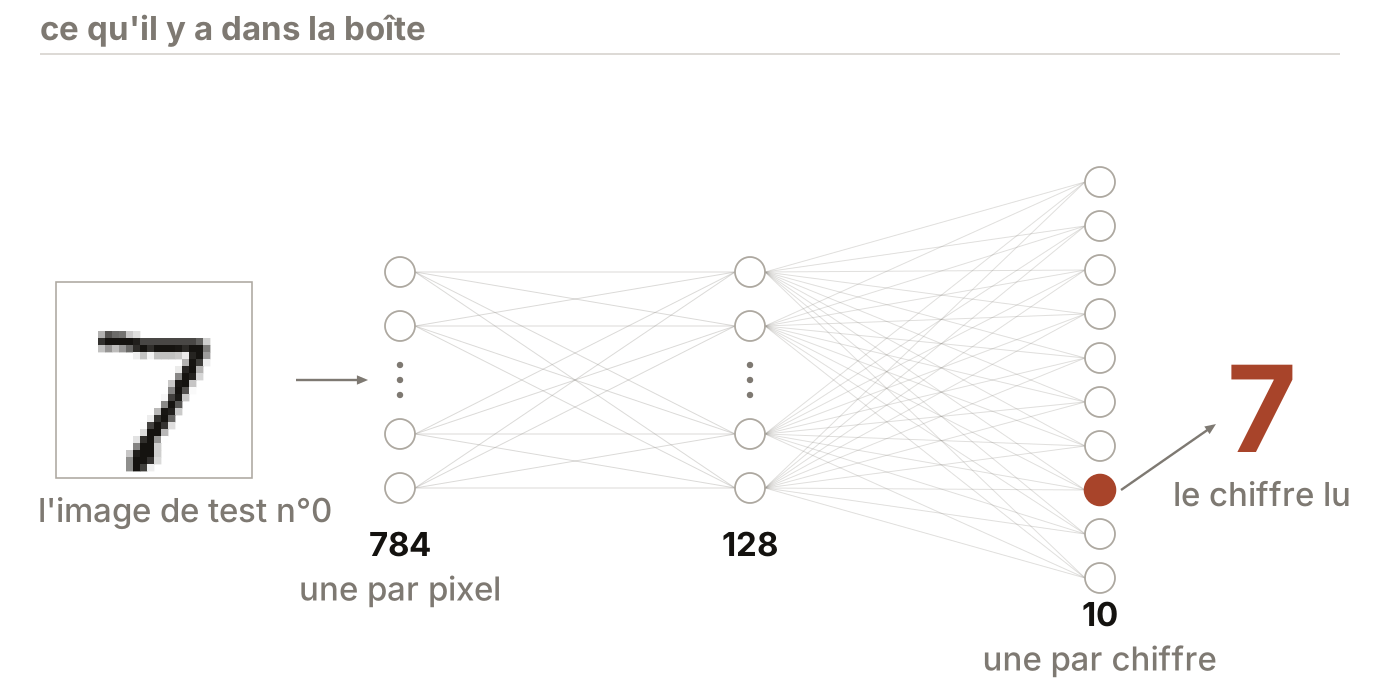
La même image qu'à la page 1. Cette page-ci nomme chacun de ses traits.
L'architecture générale
L∈N∗,L≥2,d0=784,dL=10,dl∈N∗ pour l∈[[1,L−1]]
(10.1)
L est le nombre d'étapes de calcul, l'entrée non comptée, et dl le nombre de neurones de l'étape l. Les étapes 1 à L−1 s'appellent les couches cachées, parce que rien n'entre ni ne sort du réseau chez elles.
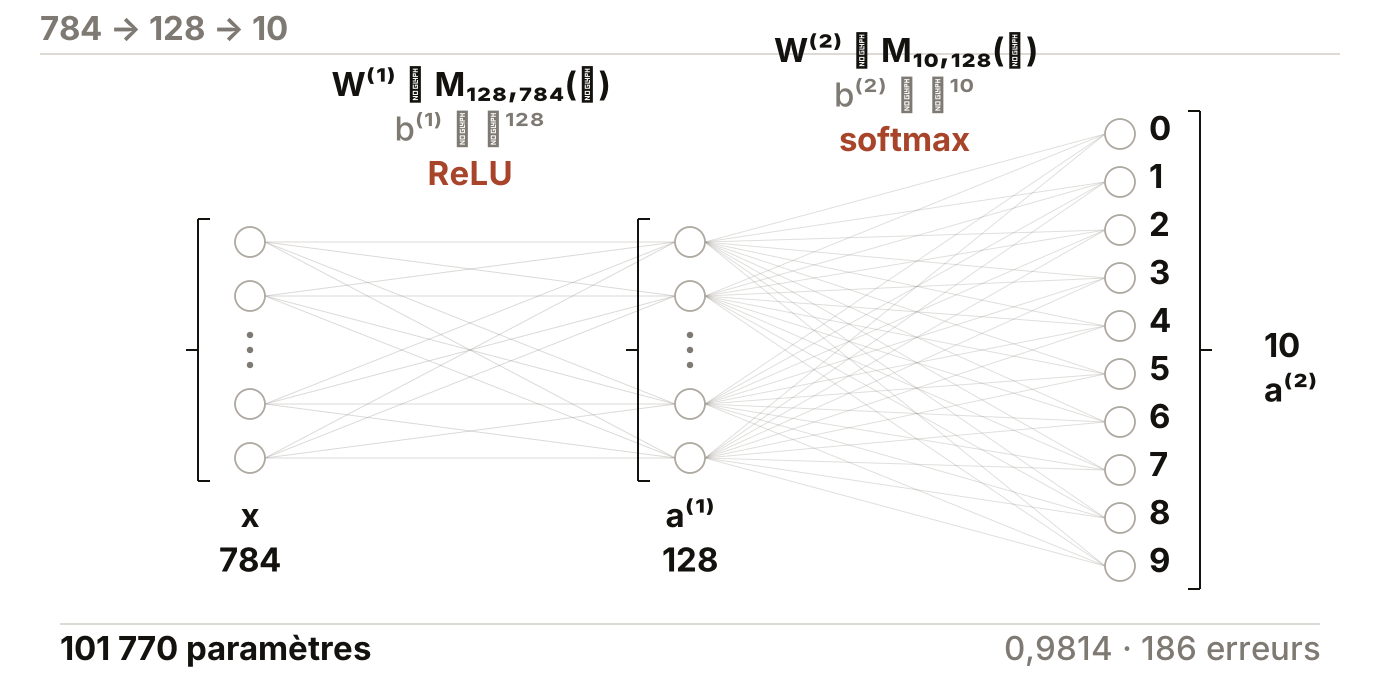
d0 et dL sont imposés par la tâche, 784 pixels en entrée et 10 classes en sortie, quand les dl intermédiaires sont choisis. Le réseau de la page 9 est le cas L=2 avec d1=h=128.
On demande L≥2 parce qu'il faut deux étapes pour qu'une activation ait un entre-deux où se glisser. Le modèle de la page 6 est le cas L=1, que (10.1) écarte pour cette raison. (10.2) le décrirait sans peine, la ligne ReLU y devenant vide, et le compte (10.3) s'y applique tel quel : le tableau plus bas l'instancie.
W[l]∈Mdl,dl−1(R) et b[l]∈Rdl. L'exposant entre crochets désigne une couche : ce n'est ni une puissance, ni un numéro d'exemple.Les deux couches ne diffèrent que par leurs dimensions et leur fonction d'activation.
Instancié en 784→128→10 avec ReLU, c'est le réseau de la page 9. Entraîné avec le même protocole que les précédents et un pas η=0,5, il atteint 0,9814 de précision de test, soit 186 erreurs sur 10000, et c'est le chiffre qui manquait depuis la page 7 : le plafond de 0,9193 n'était pas celui de la tâche, mais celui d'une famille de fonctions.
Les dimensions vérifiées, ligne à ligne, pour 784→128→10
Ligne
Produit
Résultat
z[1]=W[1]a[0]+b[1]
(128×784)(784×1)+(128×1)
128×1
a[1]=ReLU(z[1])
composante par composante, (9.2)
128×1
z[2]=W[2]a[1]+b[2]
(10×128)(128×1)+(10×1)
10×1
a[2]=softmax(z[2])
R10→Δ9∘, (6.3)
10×1
D'où vient l'écriture matricielle
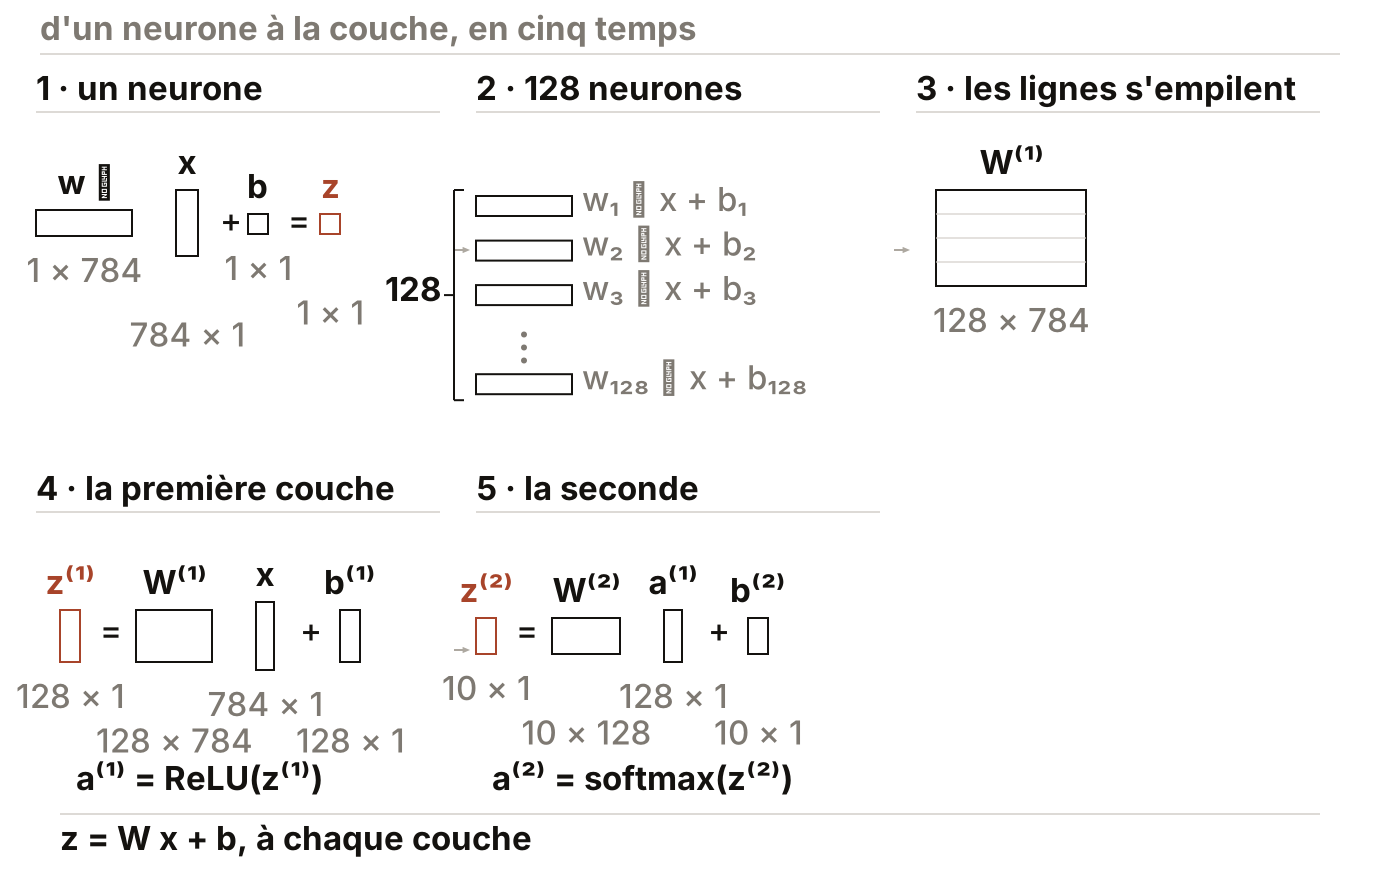
(10.2) tient en quatre lignes, mais elle n'est pas tombée d'un coup. Elle se construit en cinq temps à partir de (4.1), la préactivation d'un neurone, et chaque temps est un rangement, pas un calcul nouveau.
Les cinq temps
Temps
Ce qu'on range
Ce qu'on obtient
1
Les dl−1 activations de la couche précédente, empilées
a[l−1]∈Rdl−1, vecteur colonne
2
Les dl−1 poids du neurone j, mis en ligne
(wj[l])T, de dimension 1×dl−1
3
Les dl lignes empilées les unes sous les autres
W[l]∈Mdl,dl−1(R)
4
Le produit W[l]a[l−1]
(dl×dl−1)(dl−1×1)=dl×1 : les dl sommes pondérées, toutes ensemble
5
Les dl biais, puis l'activation
z[l]=W[l]a[l−1]+b[l], puis a[l]=ReLU(z[l])
Le temps 4 est le seul qui mérite un regard : la coordonnée j du produit est ∑kWjk[l]ak[l−1], c'est-à-dire exactement (4.1) écrite pour le neurone j.
Le produit final est exactement 128 fois la ligne (4.1), écrite une seule fois. L'exemple est écrit en colonne ; le calcul par lots les empile en lignes, et W passe à droite, transposée.
Cette écriture n'est pas seulement plus courte que 128 sommes écrites l'une après l'autre. Les bibliothèques de calcul et le matériel spécialisé sont optimisés pour une opération, le produit de matrices : une part de ce qu'on appelle une nouvelle architecture matérielle pour l'IA est un produit matriciel plus rapide. Écrire le réseau sous cette forme n'est donc pas un choix de notation, c'est le choix de l'opération qui sera effectivement exécutée.
Le compte des paramètres
p=l=1∑L(W[l]dldl−1+b[l]dl)
(10.3)
La formule vient de (10.1) et (10.2) seules : une matrice dl×dl−1 a dldl−1 coefficients, un vecteur de Rdl en a dl.
La formule instanciée quatre fois · cours/lecon2/mesures.py, section 9
    p = somme sur l de ( d_l * d_{l-1} + d_l )

    architecture                 detail                          p
    784 -> 10                    10x784+10                        7850
    784 -> 128 -> 10             128x784+128 + 10x128+10        101770
                                 part dans la premiere matrice    98.6 %
    784 -> 16 -> 16 -> 10        16x784+16 + 16x16+16 + 10x16+10    13002
                                 part dans la premiere matrice    96.5 %
    784 -> 32 -> 32 -> 32 -> 10  32x784+32 + 32x32+32 + 32x32+32 + 10x32+10    27562
                                 part dans la premiere matrice    91.0 %
Lecture
·
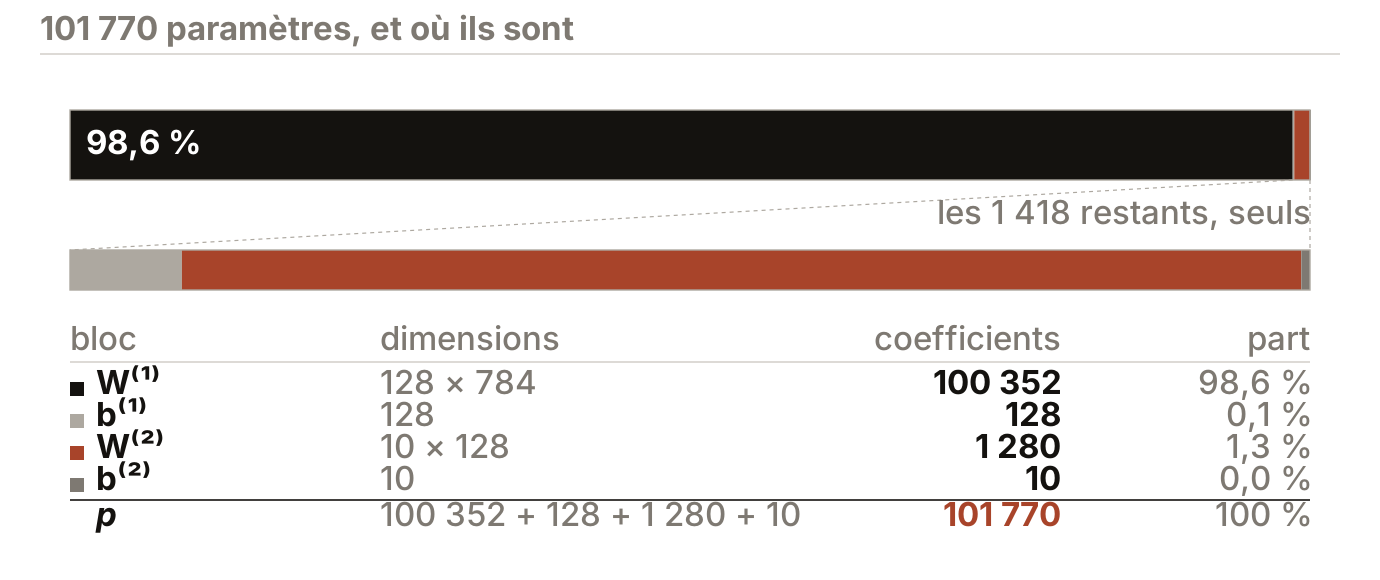
101770=100352+128+1280+10. Le programme recalcule ce total en parcourant θ, et le compare au compte écrit à la main : les deux concordent.
·
98,6% des paramètres sont dans W[1], la matrice qui touche les pixels. La couche de sortie, celle qui décide, en porte 1,3%.
·
784→16→16→10 donne 13002 : c'est l'architecture dont la page 11 mesure la précision.
·
La part de la première matrice descend le long du tableau, de 98,6% à 96,5% puis 91,0% : plus les couches suivantes portent de coefficients, moins celle qui touche les pixels pèse dans le total.
Un réseau se compte par ses matrices : les deux vecteurs de biais n'en font que 138.Vérification rapide n° 19
La formule générale s'applique sans énumérer les couches.
a
Donner p pour l'architecture 784→32→32→32→10, en appliquant (10.3).
b
Quelle part de ce total est dans la première matrice ?
c
Pour une architecture 784→d1→10, montrer que la première matrice porte plus de la moitié des paramètres quel que soit d1, et dire vers quelle part elle tend quand d1 grandit.
Aucune réponse à cliquer : il y a un calcul à faire.
Régler ces nombres à la main
La page 5 a construit un neurone entièrement à la main, avec ses 171 coefficients non nuls posés en trois lignes, quand le réseau complet en compte 101770. En décidant d'un nombre par seconde et sans jamais s'arrêter, il faudrait 28,3 heures pour tous les poser.
Encore faudrait-il savoir quelle valeur donner à chacun, ce que personne ne sait faire au-delà de quelques neurones dont on a dessiné le motif soi-même.
Que personne ne les ait écrits est aussi la raison de ne pas traiter le réseau comme une boîte noire : personne ne sait ce que ces 101770 nombres contiennent, et la seule façon de le savoir est de les regarder, comme la page 4 a regardé un gabarit. La page 11 le fait sur la couche cachée, et ce qu'elle trouve n'est pas ce qu'on attendait.
fθ:R784→Δ9∘,θ∈R101770
(10.4)
Tout ce chapitre n'a fait que décrire cette fonction : ses ensembles, sa forme, ses paramètres, et ce qu'elle peut ou ne peut pas séparer. Il n'a rien dit de la façon dont θ est choisi.