• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
20/59
Lecture18 min

Casser la ligne droite

La pièce qui manquait : la fonction d'activation, ReLU et la sigmoïde.

Empiler deux couches n'a rien changé, puisque mises bout à bout elles refont exactement ce qu'une seule faisait déjà, et il manque donc une pièce entre les deux. Cette pièce ne doit rien coûter en paramètres, sans quoi on ne saurait pas à quoi attribuer le gain. Que faut-il glisser là, de plus simple possible, pour que l'empilement se mette enfin à compter ?
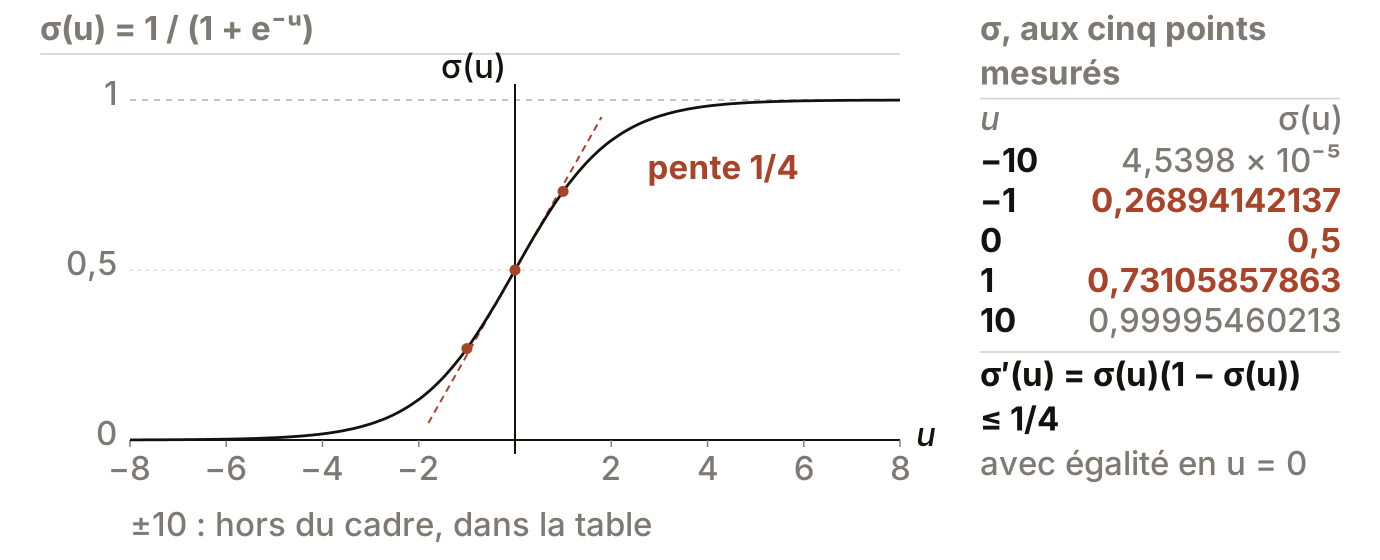
Un repère où u va de moins huit à plus huit et où l'ordonnée va de zéro à un. La courbe de sigma monte de gauche à droite en forme de S : elle colle à la ligne zéro à gauche, traverse la hauteur zéro virgule cinq en u égal zéro, et colle à la ligne un à droite. Les deux lignes zéro et un sont tracées en pointillé et ne sont jamais touchées. Une droite de brique en tirets touche la courbe en son centre, de pente un quart, et trois points de brique marquent la courbe en u égal moins un, zéro et un. À droite, une table donne les cinq valeurs mesurées : sigma de moins dix vaut quatre virgule cinq trois neuf huit fois dix puissance moins cinq, sigma de moins un vaut zéro virgule deux six huit neuf quatre un quatre deux un trois sept, sigma de zéro vaut zéro virgule cinq, sigma de un vaut zéro virgule sept trois un zéro cinq huit cinq sept huit six trois, et sigma de dix vaut zéro virgule neuf neuf neuf neuf cinq quatre six zéro deux un trois. Sous la table, la dérivée de sigma en u vaut sigma de u fois un moins sigma de u, et ne dépasse jamais un quart, avec égalité en zéro.
σ\sigmaσ ne touche jamais ses deux bornes : elle s'en approche.

La substitution de la page 8 tenait à un point précis : le vecteur z[1]=W[1]x+b[1]\mathbf{z}^{[1]}=W^{[1]}\mathbf{x}+\mathbf{b}^{[1]}z[1]=W[1]x+b[1] entrait linéairement dans la couche suivante, ce qui permettait au produit W[2]W[1]W^{[2]}W^{[1]}W[2]W[1] de remplacer les deux matrices. Il suffit qu'une fonction non affine s'interpose pour que ce produit ne se forme plus.

Une fonction d'activation est cette fonction-là : une fonction d'une seule variable réelle, appliquée séparément à chacune des coordonnées d'une préactivation, et posée entre deux étapes de calcul. Le softmax\mathrm{softmax}softmax de la page 6 n'en est pas une, puisqu'il mêle les dix coordonnées ; il se pose tout au bout, et non entre deux étapes.

On note a[1]\mathbf{a}^{[1]}a[1] ce que la première couche rend une fois l'activation appliquée, et d1=128d_{1}=128d1​=128 le nombre de ses neurones.

Ce qu'on demande à une activation

  1. 01

    Définie sur R\mathbb{R}R tout entier. Aucun intervalle ne contient toutes les préactivations que la famille peut produire : sur une image donnée, wTx+b\mathbf{w}^{\mathsf{T}}\mathbf{x}+bwTx+b prend n'importe quelle valeur réelle selon les poids et le biais qu'on y met.

  2. 02

    Non affine. Si φ(u)=αu+β\varphi(u)=\alpha u+\betaφ(u)=αu+β, la démonstration de la page 8 se refait mot pour mot et la famille ne grandit pas.

  3. 03

    Dérivable sauf en un nombre fini de points. Le chapitre 3 se servira de sa dérivée, et il lui suffit qu'elle existe partout sauf en quelques points isolés.

  4. 04

    Calculable. Elle est évaluée une fois par neurone caché et par image, soit 128×60 000128\times 60\,000128×60000 fois par époque ici, et son coût entre donc dans le temps d'entraînement.

ReLU

Unité de rectification linéairerectified linear unit, ReLU

La fonction ReLU:R→R≥0\mathrm{ReLU}:\mathbb{R}\rightarrow\mathbb{R}_{\geq 0}ReLU:R→R≥0​, u↦max⁡(u,0)u\mapsto\max(u,0)u↦max(u,0). Elle laisse passer les valeurs positives inchangées et renvoie zéro pour les négatives.

ReLU:R→R≥0,ReLU(u)=max⁡(u,0)={usi u>00si u≤0\mathrm{ReLU}:\mathbb{R}\rightarrow\mathbb{R}_{\geq 0},\qquad \mathrm{ReLU}(u)=\max(u,0)=\begin{cases}u & \text{si } u>0\\ 0 & \text{si } u\leq 0\end{cases}ReLU:R→R≥0​,ReLU(u)=max(u,0)={u0​si u>0si u≤0​
(9.1)
ReLU′(u)=1{u>0}pour u≠0\mathrm{ReLU}'(u)=\mathbb{1}\{u>0\}\quad\text{pour } u\neq 0ReLU′(u)=1{u>0}pour u=0
En u=0u=0u=0 la fonction n'est pas dérivable : la pente à gauche vaut 000, celle à droite vaut 111. On pose par convention ReLU′(0)=0\mathrm{ReLU}'(0)=0ReLU′(0)=0. Le choix est libre et sans conséquence mesurable, parce qu'une préactivation exactement nulle ne s'obtient pas en virgule flottante.
Sur cette image, 939393 des 128128128 neurones cachés renvoient exactement zéro, si bien que 353535 colonnes seulement de W[2]W^{[2]}W[2] servent encore à quelque chose. Une autre image en laisserait d'autres.

Un réseau occupe toute la largeur de l'écran : à gauche une grille carrée où un sept manuscrit se forme case par case, puis trois colonnes de ronds reliées par une nappe de fils très pâles. Les cases encrées de la grille s'envolent une à une vers la première colonne, qui se remplit d'encre du haut vers le bas. Une vague parcourt alors la nappe et atteint la colonne du milieu : là, un rond sur trois environ se remplit d'encre, plus ou moins fort, et tous les autres restent des cercles vides, gris. Sur la droite, quatre valeurs s'inscrivent l'une après l'autre, chacune à la hauteur du rond qu'elle désigne : plus trois virgule six mille quatre cent cinquante-quatre pour le cinquième rond, plus quatre virgule quatre mille sept cent trente-huit pour le soixante-sixième, puis, en gris, moins six virgule sept mille huit cent quatre-vingt-quatorze pour le quatre-vingt-unième, et plus trois virgule quatre mille cinq cent quatre-vingt-trois pour le cent-quatorzième. Le compte s'inscrit en bas à droite : trente-cinq allumés, quatre-vingt-treize éteints. Tous les ronds restés gris s'effacent alors, la valeur grise disparaît avec eux, et les fils qui partaient d'eux s'en vont : la nappe se vide et il ne reste qu'un peigne clairsemé, celui des ronds encrés. Une dernière vague le parcourt jusqu'à la colonne de droite, où un seul rond s'allume.

0:00 / 0:22

Les quatre conditions, vérifiées pour ReLU

ConditionVérification

Définie sur R\mathbb{R}R

max⁡(u,0)\max(u,0)max(u,0) existe pour tout réel uuu. Ensemble d'arrivée R≥0\mathbb{R}_{\geq 0}R≥0​.

Non affine

ReLU(−1)=0\mathrm{ReLU}(-1)=0ReLU(−1)=0, ReLU(0)=0\mathrm{ReLU}(0)=0ReLU(0)=0, ReLU(1)=1\mathrm{ReLU}(1)=1ReLU(1)=1. Une fonction affine passant par (−1,0)(-1,0)(−1,0) et (0,0)(0,0)(0,0) est nulle, et vaudrait 000 en 111.

Dérivable sauf en un nombre fini de points

Dérivable sur R∗\mathbb{R}^{*}R∗, non dérivable au seul point u=0u=0u=0.

Calculable

Une comparaison et une sélection, sans exponentielle ni division.

Comment une fonction d'une variable s'applique à un vecteur

φ:R→R, u∈Rm ⟹ φ(u)=(φ(u1), …, φ(um))T∈Rm\varphi:\mathbb{R}\rightarrow\mathbb{R},\ \mathbf{u}\in\mathbb{R}^{m}\ \Longrightarrow\ \varphi(\mathbf{u})=\big(\varphi(u_{1}),\ \ldots,\ \varphi(u_{m})\big)^{\mathsf{T}}\in\mathbb{R}^{m}φ:R→R, u∈Rm ⟹ φ(u)=(φ(u1​), …, φ(um​))T∈Rm
(9.2)
Convention posée ici, à sa première occurrence. La coordonnée kkk du résultat ne dépend que de la coordonnée kkk de l'antécédent.

softmax\mathrm{softmax}softmax n'obéit pas à cette convention, et cela se lit sur son écriture : sa coordonnée kkk vaut ezk/∑jezje^{z_{k}}/\sum_{j}e^{z_{j}}ezk​/∑j​ezj​, et le dénominateur porte toutes les coordonnées de z\mathbf{z}z. Modifier z3z_{3}z3​ seul change donc les dix coordonnées de softmax(z)\mathrm{softmax}(\mathbf{z})softmax(z). C'est le point (i) de la proposition 5, démontré à la page 6.

Ce que ReLU achète

DérivationAvec ReLU, le réseau est affine par morceaux, et le nombre de morceaux est majoré (proposition 4)
1

Hypothèses

  • ·

    Le réseau est z[1]=W[1]x+b[1]\mathbf{z}^{[1]}=W^{[1]}\mathbf{x}+\mathbf{b}^{[1]}z[1]=W[1]x+b[1], a[1]=ReLU(z[1])\mathbf{a}^{[1]}=\mathrm{ReLU}(\mathbf{z}^{[1]})a[1]=ReLU(z[1]), z[2]=W[2]a[1]+b[2]\mathbf{z}^{[2]}=W^{[2]}\mathbf{a}^{[1]}+\mathbf{b}^{[2]}z[2]=W[2]a[1]+b[2].

  • ·

    W[1]∈M128,784(R)W^{[1]}\in\mathcal{M}_{128,784}(\mathbb{R})W[1]∈M128,784​(R), W[2]∈M10,128(R)W^{[2]}\in\mathcal{M}_{10,128}(\mathbb{R})W[2]∈M10,128​(R).

  • ·

    ReLU\mathrm{ReLU}ReLU est appliquée composante par composante, au sens de (9.2)(9.2)(9.2).

2

Chaîne de dépendances

\mathbf{x} \rightarrow \mathbf{z}^{[1]} \rightarrow \text{signe de chaque } z^{[1]}_{j} \rightarrow \text{une matrice diagonale} \rightarrow \mathbf{z}^{[2]} \text{ affine}

3

Propriétés utilisées

  • ·

    Un demi-espace {x:αTx+β>0}\{\mathbf{x}:\boldsymbol{\alpha}^{\mathsf{T}}\mathbf{x}+\beta>0\}{x:αTx+β>0} est convexe

  • ·

    Une intersection quelconque de parties convexes est convexe

  • ·

    Une partie de [ ⁣[1,128] ⁣][\![1,128]\!][[1,128]] se choisit de 21282^{128}2128 façons

4

Étapes

  1. Pour une partie S⊆[ ⁣[1,128] ⁣]S\subseteq[\![1,128]\!]S⊆[[1,128]], on note RSR_{S}RS​ l'ensemble des entrées pour lesquelles ce sont exactement les neurones de SSS qui sont allumés. Malgré la lettre commune, ces régions n'ont rien à voir avec les RkR_{k}Rk​ de la page 7 : celles-ci découpaient l'entrée par la classe prédite, celles-là la découpent par les neurones cachés qui s'allument.

  2. RS={x∈R784 : zj[1](x)>0 pour j∈S,  et zj[1](x)≤0 sinon}R_{S}=\big\{\mathbf{x}\in\mathbb{R}^{784}\ :\ z^{[1]}_{j}(\mathbf{x})>0 \text{ pour } j\in S,\ \text{ et } z^{[1]}_{j}(\mathbf{x})\leq 0 \text{ sinon}\big\}RS​={x∈R784 : zj[1]​(x)>0 pour j∈S,  et zj[1]​(x)≤0 sinon}

    Chaque zj[1]z^{[1]}_{j}zj[1]​ est une forme affine de x\mathbf{x}x : chaque condition est un demi-espace.

  3. RSR_{S}RS​ est donc une intersection de 128128128 demi-espaces : c'est un polyèdre convexe. Les 21282^{128}2128 parties SSS possibles donnent des RSR_{S}RS​ deux à deux disjoints dont la réunion est R784\mathbb{R}^{784}R784 tout entier : les RSR_{S}RS​ non vides forment une partition.

    Chaque x\mathbf{x}x détermine sans ambiguïté l'ensemble des jjj tels que zj[1](x)>0z^{[1]}_{j}(\mathbf{x})>0zj[1]​(x)>0.

  4. Sur RSR_{S}RS​, l'action de ReLU\mathrm{ReLU}ReLU se réduit à une multiplication par une matrice constante : ReLU(z[1])=DS z[1]\mathrm{ReLU}(\mathbf{z}^{[1]})=D_{S}\,\mathbf{z}^{[1]}ReLU(z[1])=DS​z[1], où DS∈M128(R)D_{S}\in\mathcal{M}_{128}(\mathbb{R})DS​∈M128​(R) est diagonale, de coefficient (DS)jj=1(D_{S})_{jj}=1(DS​)jj​=1 si j∈Sj\in Sj∈S et 000 sinon.

  5. ∀ x∈RS,z[2](x)=W[2]DS(W[1]x+b[1])+b[2]=(W[2]DSW[1])⏟∈ M10,784(R)x+(W[2]DSb[1]+b[2])⏟∈ R10\forall\,\mathbf{x}\in R_{S},\quad \mathbf{z}^{[2]}(\mathbf{x})=W^{[2]}D_{S}\big(W^{[1]}\mathbf{x}+\mathbf{b}^{[1]}\big)+\mathbf{b}^{[2]}=\underbrace{\big(W^{[2]}D_{S}W^{[1]}\big)}_{\in\,\mathcal{M}_{10,784}(\mathbb{R})}\mathbf{x}+\underbrace{\big(W^{[2]}D_{S}\mathbf{b}^{[1]}+\mathbf{b}^{[2]}\big)}_{\in\,\mathbb{R}^{10}}∀x∈RS​,z[2](x)=W[2]DS​(W[1]x+b[1])+b[2]=∈M10,784​(R)(W[2]DS​W[1])​​x+∈R10(W[2]DS​b[1]+b[2])​​

    Vérification des dimensions : (10×128)(128×128)(128×784)=10×784(10\times 128)(128\times 128)(128\times 784)=10\times 784(10×128)(128×128)(128×784)=10×784.

  6. L'expression est affine en x\mathbf{x}x sur chaque RSR_{S}RS​, et ses coefficients dépendent de SSS : deux régions voisines n'ont pas la même matrice. Le réseau est affine par morceaux.

5

Résultat

#{morceaux} ≤ # P([ ⁣[1,128] ⁣])=2128≈3,4⋅1038\#\{\text{morceaux}\}\ \leq\ \#\,\mathcal{P}\big([\![1,128]\!]\big)=2^{128}\approx 3{,}4\cdot 10^{38}#{morceaux} ≤ #P([[1,128]])=2128≈3,4⋅1038
6

Interprétation

Le majorant est immédiat : chaque morceau est repéré par la partie SSS des neurones allumés, et il y a 21282^{128}2128 parties possibles. C'est de là que vient la puissance d'expression du réseau, et non du nombre de paramètres, puisque la proposition 3 vient de montrer que 101 770101\,770101770 paramètres sans rien entre les deux couches n'en achètent aucune.

Ce sont les mêmes 101 770101\,770101770 nombres, avec une fonction qui n'en coûte pas un seul, et la famille atteignable cesse d'être affine pour devenir affine par morceaux.

Ce que ce résultat ne dit pas

  • ·

    C'est un majorant, pas un compte. Le nombre de régions effectivement non vides est bien plus petit, et il dépend de W[1]W^{[1]}W[1].

  • ·

    La proposition 2 ne s'applique plus : les régions de décision du réseau à ReLU ne sont plus convexes. La mesure de la page 7 le vérifie sur les deux modèles.

  • ·

    Il ne dit pas non plus que ReLU\mathrm{ReLU}ReLU soit gratuite : la perte n'est plus une fonction convexe de θ\boldsymbol{\theta}θ, et le rappel en fin de page dit à qui cette perte-là est imputable.

Combien de neurones s'allument sur une image · modèle 3, image de test n°0

      composantes de a^[1] non nulles         35 sur 128
      composantes nulles                      93
      part moyenne sur les 10 000 images      35,07 %
      neurones éteints sur TOUTES les images  0 sur 128

Lecture

  • ·

    Sur cette image, 93 des 128 neurones cachés renvoient exactement zéro, leur préactivation étant négative et ReLU\mathrm{ReLU}ReLU les coupant, si bien qu'ils ne contribuent en rien au calcul de z[2]\mathbf{z}^{[2]}z[2]. Les 35 qui restent font 27 %27\,\%27% des 128, ce qui place cette image au-dessous de la ligne suivante, où 35,07 %35{,}07\,\%35,07% est la part moyenne d'allumés sur les 10 000 images. Les deux nombres commencent par les mêmes chiffres sans mesurer la même chose.

  • ·

    La partie SSS de la proposition 4 est donc, pour cette image précise, un ensemble de 35 indices. Une autre image donne une autre partie, et donc une autre matrice affine.

  • ·

    Aucun neurone n'est éteint sur les 10 000 images à la fois : la couche n'a pas de neurone mort, et ses 128 lignes servent toutes à quelque chose.

Vérification rapide n° 17

Un neurone caché a une préactivation strictement négative sur une image donnée.

  1. a

    Que vaut la dérivée de ReLU\mathrm{ReLU}ReLU en ce point ?

  2. b

    Qu'en déduit-on sur la contribution de ce neurone à z[2]\mathbf{z}^{[2]}z[2] pour cette image ?

  3. c

    Ce neurone est-il pour autant inutile ? Justifier avec les deux dernières lignes de la mesure ci-dessus.

Aucune réponse à cliquer : il y a un calcul à faire.

Un neurone ne porte plus un nombre de $[0,1]$

Quatre notations servent ici et à la page 10, qui les construit : LLL est le nombre d'étapes de calcul, dld_{l}dl​ le nombre de neurones de l'étape lll, z[l]\mathbf{z}^{[l]}z[l] ses préactivations et a[l]\mathbf{a}^{[l]}a[l] ce qu'elle rend une fois l'activation appliquée. Pour le réseau de cette page, L=2L=2L=2, d1=128d_{1}=128d1​=128 et d2=10d_{2}=10d2​=10.

L'exposé dont ce chapitre suit l'ordre décrit un neurone comme portant un nombre entre 000 et 111, partout dans le réseau, et avec ReLU\mathrm{ReLU}ReLU ce n'est plus vrai, puisque a[l]\mathbf{a}^{[l]}a[l] vit dans R≥0dl\mathbb{R}_{\geq 0}^{d_{l}}R≥0dl​​ pour l<Ll<Ll<L, un ensemble non borné. Sur le modèle mesuré par cours/lecon2/mesures.py, section 7, la plus grande activation cachée observée sur les 10 00010\,00010000 images vaut 12,126112{,}126112,1261 et la moyenne des activations non nulles vaut 1,64381{,}64381,6438, donc les deux dépassent 111.

Seule la couche de sortie reste dans un ensemble borné, a[L]∈ΔK−1∘⊂[0,1]K\mathbf{a}^{[L]}\in\Delta^{\circ}_{K-1}\subset[0,1]^{K}a[L]∈ΔK−1∘​⊂[0,1]K, et elle le reste parce que c'est softmax\mathrm{softmax}softmax qui la produit, non l'activation cachée.

Les ensembles exacts, couche par couche

ObjetEnsembleBorné ?

a[0]=x\mathbf{a}^{[0]}=\mathbf{x}a[0]=x

[0,1]784[0,1]^{784}[0,1]784

oui, par la normalisation

z[l]\mathbf{z}^{[l]}z[l], 1≤l≤L1\leq l\leq L1≤l≤L

Rdl\mathbb{R}^{d_{l}}Rdl​

non

a[l]\mathbf{a}^{[l]}a[l] avec ReLU, l<Ll<Ll<L

R≥0dl\mathbb{R}_{\geq 0}^{d_{l}}R≥0dl​​

non

a[l]\mathbf{a}^{[l]}a[l] avec σ\sigmaσ, l<Ll<Ll<L

(0,1)dl(0,1)^{d_{l}}(0,1)dl​

oui

a[L]\mathbf{a}^{[L]}a[L]

ΔK−1∘\Delta^{\circ}_{K-1}ΔK−1∘​

oui, et de somme 111

La sigmoïde

L'autre choix courant écrase R\mathbb{R}R dans l'intervalle ouvert (0,1)(0,1)(0,1). On lui demande les quatre conditions déjà posées, plus une cinquième propre à cet usage : que son ensemble d'arrivée soit (0,1)(0,1)(0,1), de sorte que ce qu'un neurone rend se lise comme un degré d'activation compris entre rien du tout et tout à fait.

σ:R→(0,1),σ(u)=11+e−u\sigma:\mathbb{R}\rightarrow(0,1),\qquad \sigma(u)=\frac{1}{1+e^{-u}}σ:R→(0,1),σ(u)=1+e−u1​
(9.3)

Les conditions, vérifiées pour la sigmoïde

ConditionVérification

Définie sur R\mathbb{R}R

e−u>0e^{-u}>0e−u>0 pour tout uuu, donc 1+e−u>1>01+e^{-u}>1>01+e−u>1>0 : le quotient existe partout.

À valeurs dans (0,1)(0,1)(0,1)

1+e−u>11+e^{-u}>11+e−u>1 donne σ(u)<1\sigma(u)<1σ(u)<1 ; 1+e−u<+∞1+e^{-u}<+\infty1+e−u<+∞ donne σ(u)>0\sigma(u)>0σ(u)>0. Les deux bornes sont exclues : σ\sigmaσ ne vaut jamais ni 000 ni 111.

Non affine

σ\sigmaσ est bornée et non constante ; une fonction affine non constante ne l'est pas.

Dérivable

Composée de fonctions dérivables à dénominateur ne s'annulant pas : dérivable sur R\mathbb{R}R tout entier, sans exception.

Calculable

Une exponentielle et une division. Plus cher que ReLU\mathrm{ReLU}ReLU, et c'est mesurable sur le temps d'entraînement.

DérivationLa dérivée de la sigmoïde, et son majorant
1

Hypothèses

  • ·

    σ\sigmaσ est définie par (9.3)(9.3)(9.3), et u∈Ru\in\mathbb{R}u∈R.

2

Point de départ

σ(u)=(1+e−u)−1\sigma(u)=\big(1+e^{-u}\big)^{-1}σ(u)=(1+e−u)−1
3

Propriétés utilisées

  • ·

    Dérivée d'une puissance composée : (v−1)′=−v′v−2(v^{-1})'=-v'v^{-2}(v−1)′=−v′v−2

  • ·

    (e−u)′=−e−u(e^{-u})'=-e^{-u}(e−u)′=−e−u

4

Étapes

  1. σ′(u)=−(−e−u)(1+e−u)−2=e−u(1+e−u)2\sigma'(u)=-\big(-e^{-u}\big)\big(1+e^{-u}\big)^{-2}=\frac{e^{-u}}{\big(1+e^{-u}\big)^{2}}σ′(u)=−(−e−u)(1+e−u)−2=(1+e−u)2e−u​

    Dérivation de la composée.

  2. e−u(1+e−u)2=11+e−u⋅e−u1+e−u=11+e−u⋅(1−11+e−u)\frac{e^{-u}}{\big(1+e^{-u}\big)^{2}}=\frac{1}{1+e^{-u}}\cdot\frac{e^{-u}}{1+e^{-u}}=\frac{1}{1+e^{-u}}\cdot\left(1-\frac{1}{1+e^{-u}}\right)(1+e−u)2e−u​=1+e−u1​⋅1+e−ue−u​=1+e−u1​⋅(1−1+e−u1​)

    Le numérateur e−ue^{-u}e−u s'écrit (1+e−u)−1(1+e^{-u})-1(1+e−u)−1, ce qui fait apparaître σ(u)\sigma(u)σ(u) dans les deux facteurs.

  3. σ′(u)=σ(u)(1−σ(u))\sigma'(u)=\sigma(u)\big(1-\sigma(u)\big)σ′(u)=σ(u)(1−σ(u))
  4. Posons t=σ(u)∈(0,1)t=\sigma(u)\in(0,1)t=σ(u)∈(0,1). Le majorant de σ′\sigma'σ′ est celui de t↦t(1−t)t\mapsto t(1-t)t↦t(1−t) sur (0,1)(0,1)(0,1) : ce trinôme atteint son maximum en t=1/2t=1/2t=1/2, où il vaut 1/41/41/4.

    t(1−t)=1/4−(t−1/2)2t(1-t)=1/4-(t-1/2)^{2}t(1−t)=1/4−(t−1/2)2, écriture canonique qui donne directement le maximum et le point où il est atteint.

5

Résultat

σ′(u)=σ(u)(1−σ(u)) ≤ 14,avec eˊgaliteˊ en u=0\sigma'(u)=\sigma(u)\big(1-\sigma(u)\big)\ \leq\ \tfrac{1}{4},\qquad \text{avec égalité en } u=0σ′(u)=σ(u)(1−σ(u)) ≤ 41​,avec eˊgaliteˊ en u=0
6

Interprétation

La dérivée s'exprime à partir de la valeur de σ\sigmaσ, pas de son argument : une fois σ(u)\sigma(u)σ(u) calculé, sa dérivée ne coûte rien de plus. Et elle ne dépasse jamais 1/41/41/4 : ce majorant d'un quart pèsera sur l'entraînement des réseaux profonds.

Ce que ce résultat ne dit pas

  • ·

    Ce majorant est la source d'une difficulté d'entraînement que ce chapitre ne traite pas. Dette, chapitre 3.

  • ·

    La forme de σ\sigmaσ n'est pas dérivée ici : les cinq conditions sont vérifiées, elles ne la déterminent pas. Dette, Fondements probabilistes.

Vérification rapide n° 15

La sigmoïde se calcule aussi là où l'exponentielle déborde.

  1. a

    Que vaut σ(−1000)\sigma(-1000)σ(−1000) à la précision d'un flottant de 64 bits, et cette valeur est-elle la valeur exacte ?

  2. b

    Pourquoi le calcul direct de e1000e^{1000}e1000 déborde-t-il, alors que σ(1000)\sigma(1000)σ(1000) est parfaitement défini ?

  3. c

    Proposer une écriture de σ\sigmaσ qui ne déborde jamais, quel que soit le signe de uuu.

Aucune réponse à cliquer : il y a un calcul à faire.

Le biais est l'opposé d'un seuil

La figure qui clôt cette section pose son seuil à 23,423{,}423,4, la valeur du 777 lui-même : ce point tombe donc exactement sur la barre, et l'inégalité stricte le laisse éteint. Le seuil sépare ce qui est au-dessus, pas ce qui l'atteint.

Dans toute cette section, et dans cette figure, wTx\mathbf{w}^{\mathsf{T}}\mathbf{x}wTx désigne la somme pondérée seule, sans le biais : c'est elle qu'on compare à un seuil, et le biais est précisément ce qu'on va mettre à la place de ce seuil.

Le biais a été posé page 4 comme un paramètre de plus, sans raison donnée. La raison arrive ici, et elle se calcule. On veut qu'un neurone reste muet tant que la somme pondérée n'a pas franchi un seuil sss, et qu'il parle au-delà.

DérivationLe biais dérivé du besoin de seuil
1

Hypothèses

  • ·

    On dispose de w∈R784\mathbf{w}\in\mathbb{R}^{784}w∈R784 et d'un seuil s∈Rs\in\mathbb{R}s∈R.

  • ·

    On veut que le neurone s'active si et seulement si wTx>s\mathbf{w}^{\mathsf{T}}\mathbf{x}>swTx>s.

2

Point de départ

wTx>s\mathbf{w}^{\mathsf{T}}\mathbf{x}>swTx>s
3

Étapes

  1. wTx−s>0\mathbf{w}^{\mathsf{T}}\mathbf{x}-s>0wTx−s>0

    On retranche sss aux deux membres.

  2. wTx+b>0en posantb=−s\mathbf{w}^{\mathsf{T}}\mathbf{x}+b>0\quad\text{en posant}\quad b=-swTx+b>0en posantb=−s

    La condition retrouve exactement la forme z>0z>0z>0 déjà employée, sans qu'aucun objet nouveau soit introduit.

  3. Le neurone s'active donc si et seulement si ReLU(z)>0\mathrm{ReLU}(z)>0ReLU(z)>0, c'est-à-dire si z>0z>0z>0. Le seuil n'a pas disparu : il a changé de place et de signe.

4

Résultat

b=−sb=-sb=−s
5

Interprétation

Un biais négatif correspond à un seuil positif : le neurone exige de l'encre avant de parler. Un biais positif correspond à un seuil négatif : le neurone parle par défaut, et il faut des poids négatifs pour le faire taire. Le biais n'est pas un réglage de confort, c'est le seuil du neurone, écrit du côté où il se calcule.
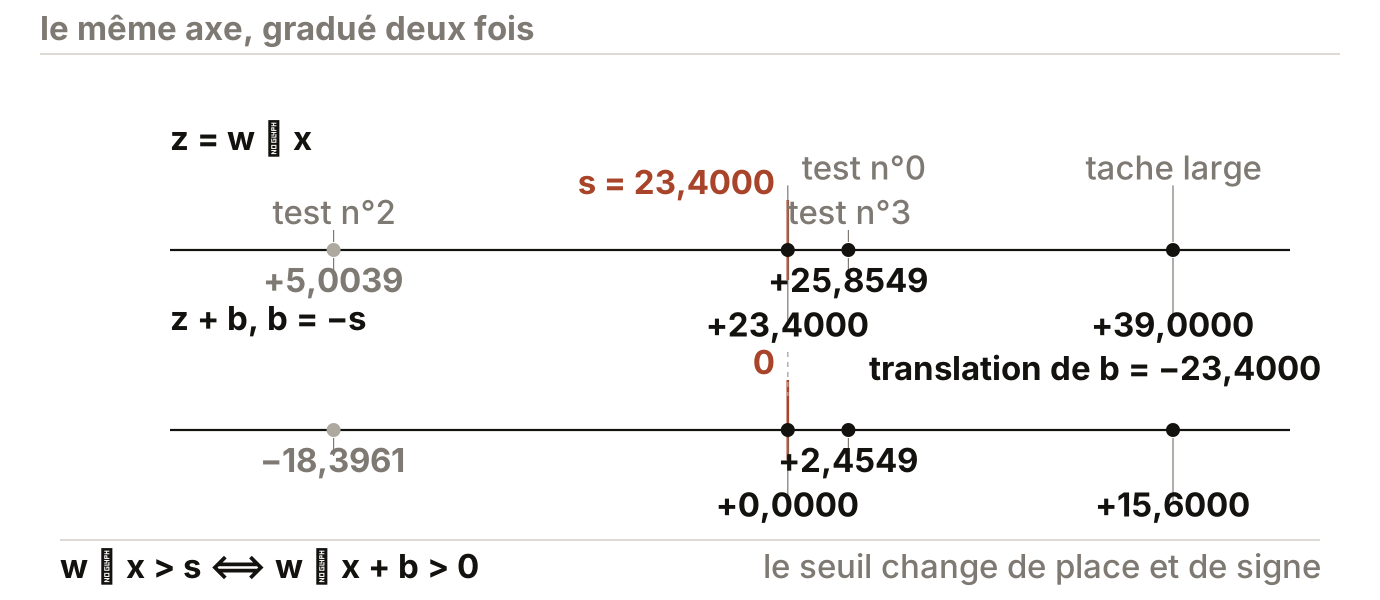
Deux axes horizontaux superposés, gradués à la même échelle. Sur celui du haut, coté z égale w transposée x, quatre points portent les scores mesurés du détecteur au premier temps : l'image de test numéro deux à plus cinq virgule zéro zéro trois neuf, l'image de test numéro zéro à plus vingt-trois virgule quatre, l'image de test numéro trois à plus vingt-cinq virgule huit cinq quatre neuf, et la tache large à plus trente-neuf. Une barre verticale de brique, cotée s égale vingt-trois virgule quatre, tombe exactement sur le point de l'image numéro zéro ; les deux points situés à sa droite sont pleins, celui de gauche est grisé. Sur l'axe du bas, coté z plus b avec b égal à moins s, les quatre points occupent exactement les mêmes places, mais leurs valeurs sont devenues moins dix-huit virgule trois neuf six un, zéro, plus deux virgule quatre cinq quatre neuf et plus quinze virgule six ; la barre de brique n'a pas bougé et vaut maintenant zéro. Entre les deux axes, la mention translation de b égale moins vingt-trois virgule quatre. En pied : w transposée x plus grand que s équivaut à w transposée x plus b plus grand que zéro, avec b égal à moins s.
Ce n'est pas le neurone qui change, c'est l'origine de son axe.
Vérification rapide n° 18

Un neurone doit rester muet tant que sa somme pondérée ne dépasse pas 777.

  1. a

    Quelle valeur donner à son biais ?

  2. b

    Pourquoi ce signe, et non l'autre ? Justifier par le calcul, pas par la mémoire.

  3. c

    Que devient ce neurone si l'on remplace ReLU\mathrm{ReLU}ReLU par σ\sigmaσ : à partir de quelle valeur de zzz son activation dépasse-t-elle 1/21/21/2 ?

Aucune réponse à cliquer : il y a un calcul à faire.

Ce que ReLU coûte, et qui le paiera

Pour le modèle à une seule couche de la page 6, celui de paramètre θ=(W,b)\boldsymbol{\theta}=(W,\mathbf{b})θ=(W,b), la perte moyenne est une fonction convexe de θ\boldsymbol{\theta}θ, ce qui garantit qu'aucun minimum local n'est plus haut qu'un autre et fait de sa minimisation un problème résolu.

Dès qu'on empile, cette garantie tombe, et ReLU\mathrm{ReLU}ReLU n'y est pour rien : deux matrices qui se multiplient suffisent à la faire tomber. Cette page ne le démontre pas, elle le pose comme une dette, et le chapitre 3 dira comment on minimise sans cette garantie.

Leçon suivante
PrécédenteEmpiler ne suffit pasSuivanteLe réseau complet, et son compte