Empiler ne suffit pas
Empiler une couche de plus n'achète rien tant qu'il manque une pièce entre les deux.
Le plafond du modèle précédent tient à sa famille de fonctions, pas à son réglage. Le réflexe naturel est donc d'agrandir cette famille, et le premier moyen qui vient à l'esprit est d'empiler une couche de calcul de plus. Reste à savoir si ce réflexe achète quoi que ce soit.
On intercale une couche de neurones entre l'entrée et la sortie, étant un entier qu'on choisit. Une telle couche est dite cachée, parce que rien n'entre ni ne sort du réseau chez elle.
Le calcul se fait alors en deux temps : on pose , puis on donne ce résultat au second temps, , et rien n'est posé entre les deux. Le crochet en exposant numérote l'étape de calcul, comme la page 2 l'avait annoncé.
Hypothèses
et sont définies par .
est la matrice identité.
Propriétés utilisées
Associativité du produit matriciel
Distributivité du produit sur la somme
Règle des dimensions :
Étapes
Première inclusion, . On développe l'expression de :
Distributivité, puis associativité.
Les dimensions donnent , donc ; et , donc . La fonction obtenue est donc bien un élément de .
Seconde inclusion, . C'est celle qui donne l'égalité, et elle demande une construction. Soient et quelconques. On pose :
empile et lignes nulles ; sélectionne les dix premières coordonnées et jette les autres.
Produit par blocs.
La fonction de de paramètres est donc atteinte dans . Les deux inclusions donnent l'égalité.
Résultat
Interprétation
Les paramètres ne décrivent pas une famille plus large : ils décrivent exactement la même, avec un paramétrage redondant. Chaque fonction de y est atteinte par une infinité de valeurs de . La proposition 2 s'applique donc encore, mot pour mot, et le plafond de la page 7 tient : les régions de décision restent convexes, et le corollaire reste vrai.
Ce que ce résultat ne dit pas
L'égalité vaut pour toute taille de couche intermédiaire , y compris : la démonstration ne s'est servie de la valeur nulle part, seulement de . En dessous de , la construction de la seconde inclusion ne se fait plus.
Elle vaut aussi pour trois couches, et pour couches, par la même récurrence.
Elle cesse de valoir dès qu'une fonction non affine s'insère entre deux couches : c'est le sujet de la page 9.
À gauche de l'écran, un sept manuscrit est dessiné case par case dans un carré quadrillé. À sa droite, trois colonnes de petits ronds sont reliées par deux nappes de traits très fins ; entre la colonne du milieu et la dernière, une case carrée vide, bordée de pointillés, marque un emplacement laissé libre. Les cases encrées du sept s'envolent une à une vers la première colonne, qui se remplit ; les traits s'illuminent en une vague qui va de la gauche vers la droite, la colonne du milieu s'assombrit, puis la dernière, et un cadre se referme sur le huitième de ses dix ronds. Dix nombres s'inscrivent alors dans la bande libre de droite, un par ligne, chacun en face du rond auquel il répond : un virgule zéro quatre trois deux tout en haut, treize virgule zéro six sept deux en face du rond encadré, et huit autres entre eux, dont trois négatifs. Les mots « deux couches » les coiffent. La colonne du milieu disparaît alors en rétrécissant, la case vide avec elle, et les deux nappes de traits n'en font plus qu'une, qui va tout droit de la première colonne à la dernière. Les dix nombres, eux, ne bougent pas. Le sept repasse dans ce réseau raccourci : ses cases s'envolent de nouveau, la première colonne se remplit, la vague traverse, la dernière s'allume. Dix nombres s'écrivent à côté des premiers, coiffés des mots « une seule ». Chiffre pour chiffre, les deux colonnes sont identiques.
Ce que paramètres de plus achètent
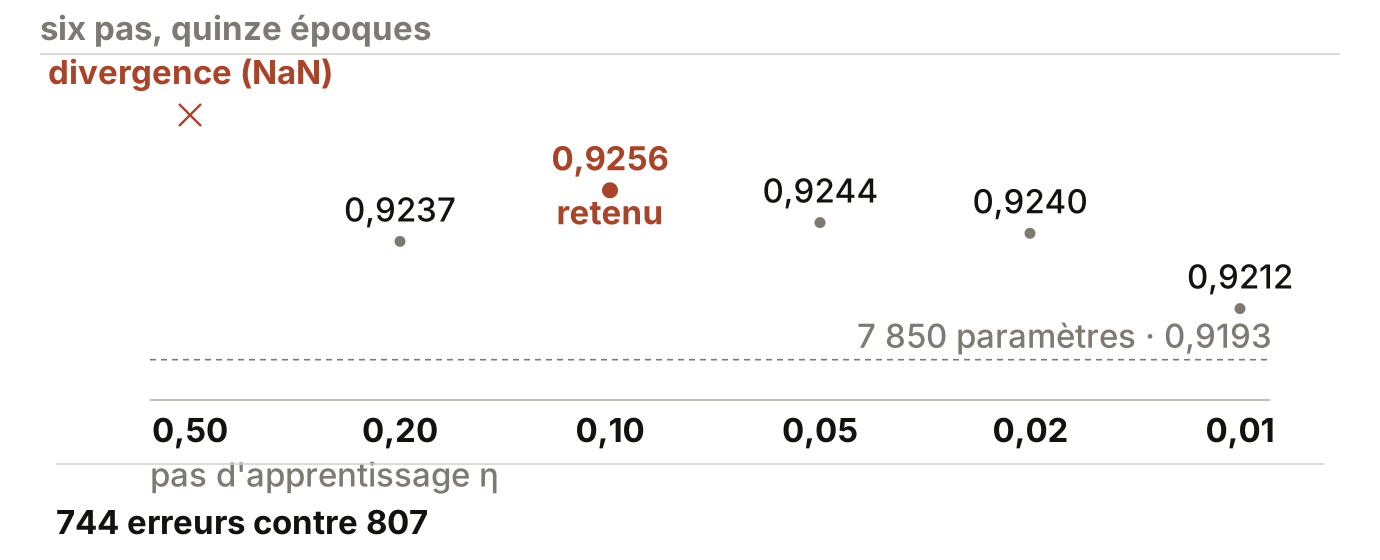
La démonstration ne dit pas qu'un modèle à deux couches fera moins bien : elle dit qu'il ne pourra rien calculer qu'une seule couche ne calculait déjà. Reste à voir ce que l'entraînement en tire, et cela demande de lui donner sa meilleure chance, puisque le juger avec le pas d'un autre modèle ne prouverait rien. On balaie donc six valeurs du pas sur époques, et on retient la meilleure.
Un pas trop grand fait diverger l'entraînement : les paramètres grandissent d'une correction à l'autre au lieu de se stabiliser, jusqu'à dépasser ce qu'un nombre flottant peut représenter, et le calcul rend alors , la marque d'un résultat qui n'est plus un nombre.
Le balayage du pas, puis le résultat · cours/lecon2/mesures.py, section 6
         eta    acc_test   remarque
        0.50       ---     divergence (NaN)
        0.20    0.9237     converge
        0.10    0.9256     converge
        0.05    0.9244     converge
        0.02    0.9240     converge
        0.01    0.9212     converge

    RETENU : eta = 0.1

    p                                       101770 parametres
    PRECISION DE TEST                       0.9256
    ERREURS                                 744 sur 10 000

    rang de W2 @ W1                         10
Lecture
À , le modèle diverge dès la première époque, alors que ce même pas conviendra au réseau de la page 10. Un pas ne se transporte donc pas d'un modèle à l'autre, et c'est bien pourquoi on le balaie.
Au meilleur réglage : et erreurs, contre et pour paramètres. paramètres de plus achètent point, soit erreurs sur .
Les deux chiffres ne sortent pas du même protocole, celui de la page 6 étant pris à sa dernière époque et celui-ci au meilleur de six pas : l'écart est donc un majorant de ce que la couche achète, et il est déjà minuscule.
Cet écart ne réfute pas la proposition 3, qui dit ce que la famille peut atteindre et non ce qu'un entraînement atteint. Les deux modèles partent d'un point différent et se corrigent sur des nombres différents, si bien qu'ils ne s'arrêtent pas au même endroit de la même famille.
La dernière ligne note le produit , et son rang vaut : le nombre annoncé par l'argument fautif est bien là, et il ne démontre toujours rien.
La proposition 3 se généralise, et l'argument fautif se réfute.
- a
Écrire ce que devient la proposition 3 pour trois couches sans rien entre elles, , et donner les deux inclusions.
- b
Dire précisément pourquoi l'argument du rang ne prouve rien.
- c
La construction de la seconde inclusion demande-t-elle ? Que se passerait-il pour ?
Aucune réponse à cliquer : il y a un calcul à faire.