Pourquoi on n'utilise pas tout le jeu
Pourquoi chaque pas se calcule sur un petit paquet d'images plutôt que sur les soixante mille.
Faire un pas demande le gradient, et le gradient demande les soixante mille images. Faut-il vraiment les regarder toutes pour avancer une fois ?
La règle demande , donc une passe sur le jeu entier à chaque pas, et un entraînement de pas en demanderait .
Un pas de la règle demande , et est une moyenne sur exemples : chaque pas coûte donc une passe complète sur le jeu. Trente époques de descente à jeu complet feraient trente pas. Le chapitre 2 en a fait dans le même temps, en évaluant à chaque fois sur images seulement, et il ne l'a jamais justifié.
Le lot, et ce qu'on en attend
- Mini-lotmini-batch
Une partie de cardinal , tirée uniformément au hasard sans remise. Le coût sur ce lot est , de dans , la même forme que sur moins d'exemples.
Quatre notions de probabilité suffisent ici, et elles sont posées au strict nécessaire. La probabilité d'un événement est la part des tirages où il se produit. L'espérance d'un vecteur aléatoire est le vecteur des espérances de ses coordonnées, et elle est linéaire. La variance d'un vecteur aléatoire autour de sa moyenne est , un scalaire positif ; un vecteur aléatoire est dit centré quand son espérance est nulle. Le cadre général, espace probabilisé, indépendance, existence des moments, appartient au chapitre de probabilités, et la proposition 5 emprunte à ce cadre une propriété que ce chapitre ne démontre pas : la variance d'une moyenne de vecteurs indépendants de même variance vaut .
Un lot se trompe, mais il ne triche pas
Soixante-quatre images ne donnent évidemment pas le gradient des soixante mille. La question n'est pas de savoir si le lot se trompe, c'est de savoir s'il se trompe toujours du même côté. Un écart qui se répète s'accumule sur des milliers de pas ; un écart qui change de sens à chaque tirage se compense.
Une quantité tirée au hasard est dite sans biais pour une cible quand sa moyenne sur tous les tirages possibles vaut exactement cette cible. Le mot n'a rien à voir avec les biais du réseau : il dit seulement qu'un tirage se trompe sans pencher.
Hypothèses
est de cardinal , tiré uniformément sans remise dans .
est le gradient de la perte du seul exemple .
est fixé : l'aléa ne porte que sur le tirage du lot.
Propriétés utilisées
Linéarité de l'espérance
Symétrie du tirage uniforme : chaque indice a la même probabilité d'appartenir à
Étapes
Le gradient est linéaire en la fonction qu'il dérive, et est une moyenne. Donc :
La seconde écriture fait porter tout l'aléa sur les indicatrices, et les deviennent des constantes.
Le tirage est uniforme sans remise : les parties de cardinal sont équiprobables, et d'entre elles contiennent un indice donné.
Linéarité de l'espérance, puis simplification de , puis reconnaissance de la moyenne des .
Résultat
Interprétation
Un lot ne donne pas le bon gradient, il en donne un autre, et la page le mesure. Mais il ne se trompe pas systématiquement : en moyenne sur les tirages, il vise juste. C'est cela qui autorise à l'employer, puisque les erreurs de direction se compensent d'un pas au suivant au lieu de s'accumuler.
Ce que ce résultat ne dit pas
La proposition ne dit rien de l'écart d'un tirage au gradient complet. C'est l'objet de la proposition 5.
Elle suppose fixé. Au cours d'un entraînement, change à chaque pas et dépend des lots précédents : l'énoncé s'applique à chaque pas pris isolément, pas à la trajectoire entière.
Ce qu'un lot deux fois plus grand achète
Viser juste en moyenne ne dit pas de combien on se trompe à chaque tirage, et c'est pourtant ce qui décide de la taille du lot. Il reste donc à relier l'écart typique à .
Hypothèses
, et le gradient d'un lot de taille .
Hypothèse de travail : les du lot sont tirés indépendamment, de variance finie .
, un nombre sans dimension qui ne dépend que du point et du jeu.
Propriétés utilisées
La variance d'une moyenne de variables indépendantes de même variance vaut
Décomposition orthogonale : , dont le second terme est centré
Étapes
est la moyenne de termes indépendants d'espérance , par la proposition 4.
Écrivons , où est le bruit du tirage. Par la proposition 4 il est centré, donc : en moyenne le bruit est orthogonal au signal. Il vient alors deux identités en espérance :
La première vient de la linéarité et de ; la seconde développe et prend l'espérance, le terme croisé s'annulant.
C'est ici qu'est l'approximation, et c'est la seule. est le quotient , et l'on remplace l'espérance de ce quotient par le quotient des espérances calculées ci-dessus. Les deux ne sont égales que si la dispersion est petite, et la mesure de montrera ce qu'il advient quand elle ne l'est pas.
Inversion de la relation précédente. Le membre de gauche porte et non : la table de mesure substituera le carré du cosinus moyen, et dira ce que cette substitution coûte.
Résultat
Interprétation
Pour grand, : l'écart au bon gradient décroît comme , donc l'angle comme . Multiplier la taille du lot par quatre divise l'angle par deux, et c'est un rendement décroissant, puisque le passage de à gagne bien plus que celui de à . C'est cet arbitrage qui décide de la taille employée.
Ce que ce résultat ne dit pas
L'hypothèse d'indépendance est fausse pour un tirage sans remise ; elle est acceptable ici parce que .
L'approximation de l'espérance du quotient est nommée et non justifiée : elle appartient au chapitre de probabilités.
La proposition parle du cosinus moyen. Elle ne dit rien de sa dispersion, et la mesure ci-dessous montre que cette dispersion décide de la validité de la lecture.
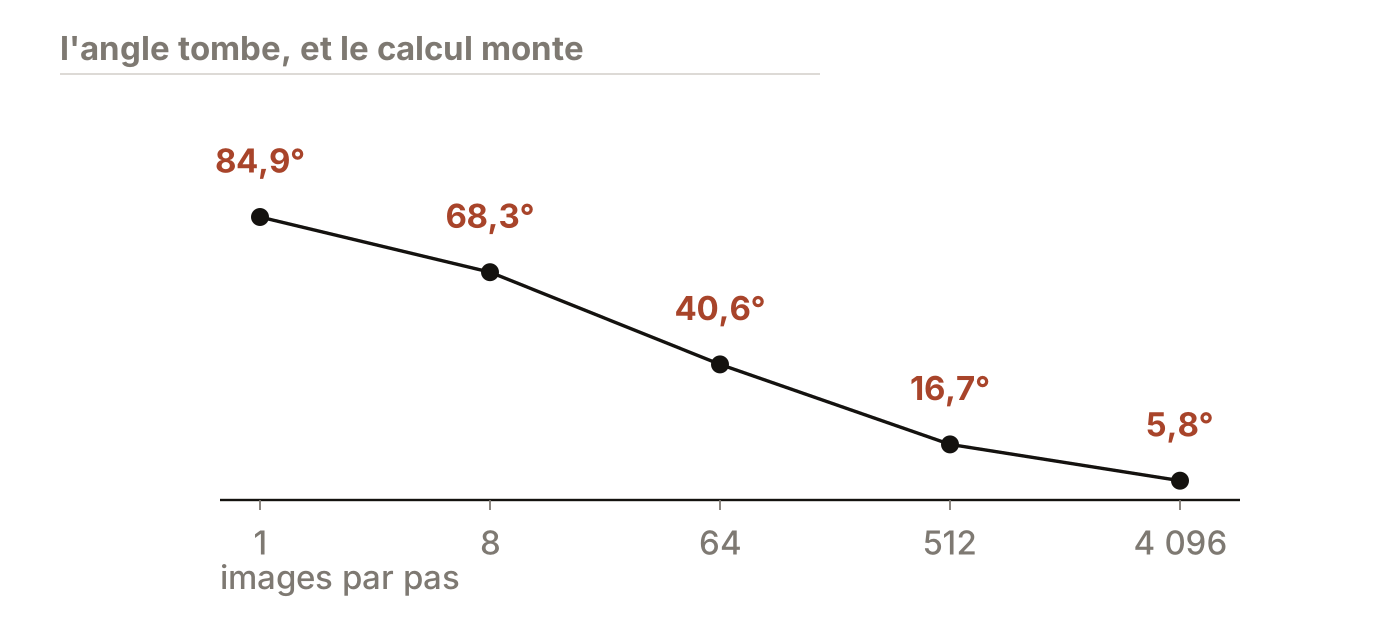
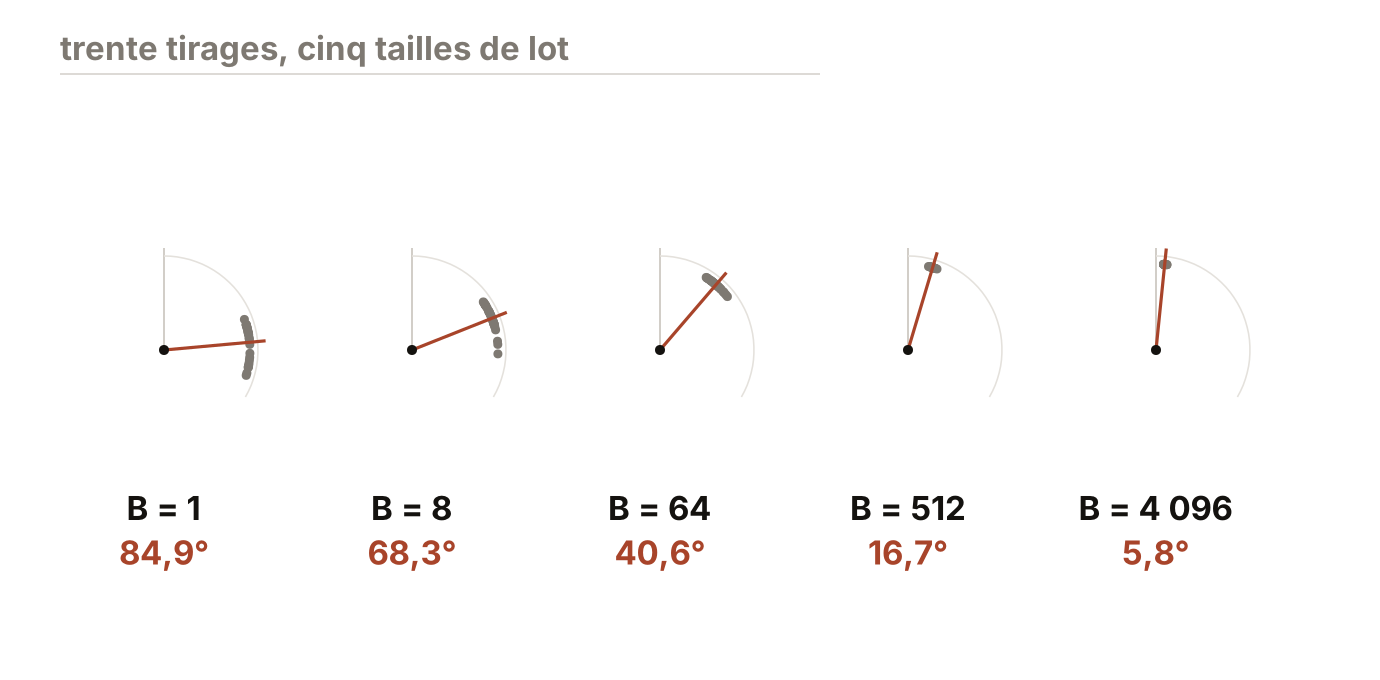
Cinq tailles de lot, 30 tirages chacune · cours/lecon3/mesures.py, mesure 5
    gradient complet sur les 60000 exemples, norme 1.355255

         B    cos moyen   écart-type   B(1/cos²-1)
         1      0.0898       0.1992          123.1
         8      0.3699       0.1434           50.5
        64      0.7587       0.0594           47.2
       512      0.9580       0.0067           45.9
      4096      0.9949       0.0012           42.0

         B    angle (degrés)
         1       84.9
         8       68.3
        64       40.6
       512       16.7
      4096        5.8
Lecture
La dernière colonne est celle que la proposition 5 prédit constante, à une substitution près qu'il faut dire. La proposition porte sur ; le programme, lui, calcule à partir du cosinus moyen. Les deux coïncident quand la dispersion est petite devant la moyenne, et se séparent sinon.
De à la colonne vaut entre et , soit une variation de pendant que est multiplié par : la loi tient là où la substitution est légitime.
À elle vaut , et c'est la substitution qui casse, pas la loi. L'écart-type, , dépasse le double de la moyenne, ; or vaut la moyenne au carré plus la variance, soit , et la colonne recalculée sur cette valeur donne au lieu de . À , la direction d'un tirage n'a plus de valeur typique, et aucune des deux quantités ne renseigne.
Un lot de pointe à du bon gradient, soit un angle de degrés. Chaque pas de l'entraînement du chapitre 2 partait donc franchement de travers, et le réseau a atteint . C'est le fait à retenir de cette page.
Le rendement décroît vite : passer de à fait tomber l'angle de à degrés pour huit fois plus de calcul, et passer de à le fait tomber de à degrés pour huit fois plus encore. La règle « quatre fois plus d'images, deux fois moins d'angle » ne se lit d'ailleurs proprement qu'en bas de table, là où les angles sont petits : de à l'angle est divisé par pour un facteur , ce qu'annonce , alors que de à il ne l'est que par .
Un vecteur d'encre part du bas de l'écran et monte vers la droite en pente raide, occupant presque toute la hauteur du cadre ; son nom s'inscrit à sa pointe : gradient complet. C'est la direction calculée sur la totalité des images, et il ne bougera plus de toute la scène. Un second vecteur, de brique et de même longueur, part du même point, mais dans une direction tout autre : il file vers la gauche en montant à peine, à peu près perpendiculaire au premier. Un arc mince relie les deux flèches près de leur origine, et deux mentions s'inscrivent à droite : lot de un, et quatre-vingt-quatre virgule neuf degrés. La mention change alors pour lot de huit, et le vecteur de brique pivote vers celui d'encre, l'arc se referme : soixante-huit virgule trois degrés. Le mouvement se répète trois fois. Lot de soixante-quatre : quarante virgule six degrés, le vecteur de brique s'est redressé et monte maintenant du même côté que celui d'encre. Lot de cinq cent douze : seize virgule sept degrés, l'arc n'est plus qu'un fragment. Lot de quatre mille quatre-vingt-seize : cinq virgule huit degrés, et les deux vecteurs sont presque confondus, l'arc réduit à un trait. Le vecteur de brique n'a jamais rejoint exactement celui d'encre.
Un lot de pointe à du gradient complet.
- a
À quel angle cela correspond-il ?
- b
Pourquoi la descente fonctionne-t-elle malgré un écart pareil à chaque pas ?
- c
Que se passerait-il si l'écart était systématiquement du même côté au lieu d'être tiré au hasard ? Répondre en citant la proposition 4.
Aucune réponse à cliquer : il y a un calcul à faire.
La proposition 5 se vérifie en interpolant une valeur qui n'a pas été mesurée.
- a
D'après la proposition 5 et la valeur de lue dans la table, quel cosinus attendrait-on pour un lot de ?
- b
Comparer à la valeur mesurée pour et dire si l'ordre de grandeur est cohérent.
- c
À quelle taille de lot faudrait-il aller pour descendre sous degré ? Le calcul est-il raisonnable ?
Aucune réponse à cliquer : il y a un calcul à faire.