Ce que le gradient encode
Ce qu'un gradient contient quand on le regarde, au lieu de simplement l'appliquer.
Le même pas s'applique aux cent mille paramètres à la fois. Reçoivent-ils tous la même correction ?
La règle se contente de soustraire le gradient et ne dit jamais ce qu'il dit. Il y a pourtant trois choses à lire dans une composante, et la troisième est celle qui décide de la suite.
et vivent dans le même espace et ont la même taille : à chaque paramètre correspond exactement une composante du gradient. La mise à jour se lit alors coordonnée par coordonnée, , et chaque ne concerne que son propre paramètre.
Ce que porte une composante
| Ce qu'on lit | Ce que cela dit | Ce que cela ne dit pas |
|---|---|---|
Le signe de | Dans quel sens pousser : fait diminuer , le fait augmenter | De combien : le signe ne porte aucune amplitude |
La valeur absolue de | De combien change quand bouge d'un peu, donc l'importance de ce paramètre ici et maintenant | Si ce paramètre est important en général : la valeur change à chaque pas |
exactement | Que ne dépend pas de au premier ordre : ce paramètre n'est pas modifié à ce pas | Que soit inutile : il peut redevenir non nul au pas suivant |
Les composantes, mesurées
La distribution des composantes · cours/lecon3/mesures.py, mesure 4
    graine 0, AVANT tout apprentissage, sur 2048 exemples
    p                                       101770 composantes
    plus grande valeur absolue              1.0084e-01
    médiane des valeurs absolues            2.4935e-04
    rapport de la plus grande à la médiane  404
    norme du gradient                       1.398869

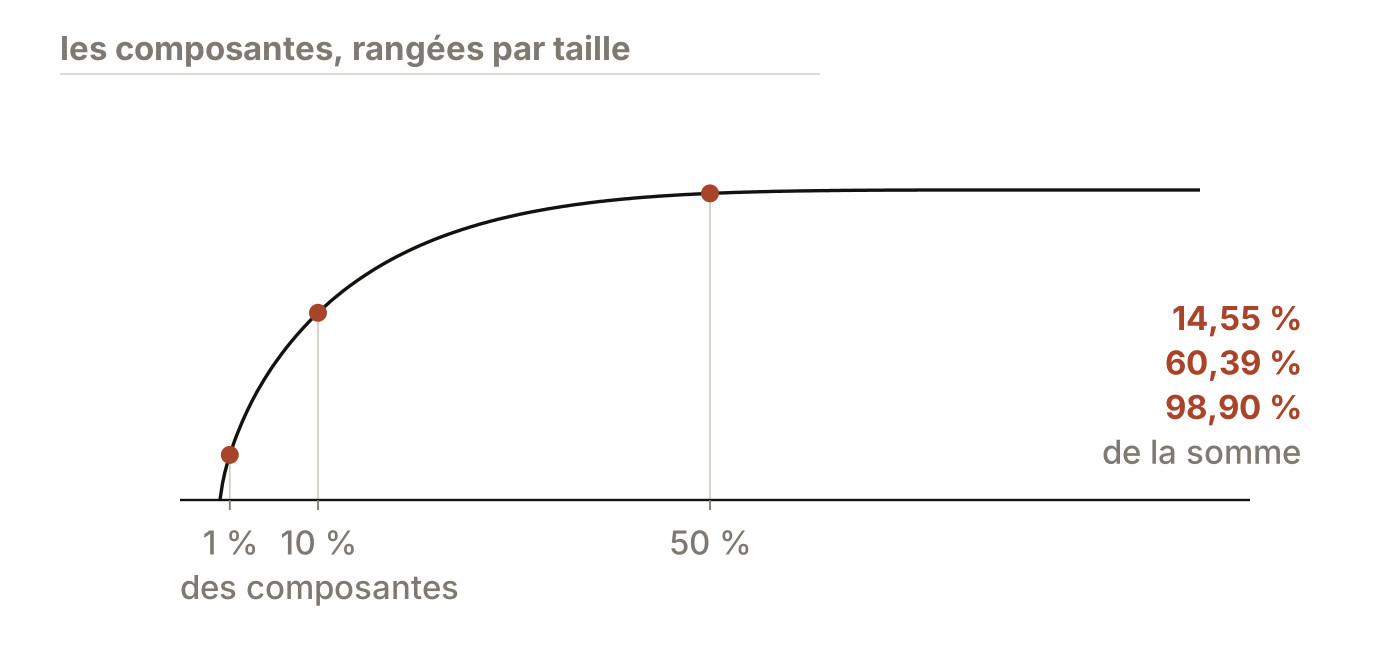
    les     1 % plus grandes portent  14.55 % de la somme des |g_i|
    les    10 % plus grandes portent  60.39 % de la somme des |g_i|
    les    50 % plus grandes portent  98.90 % de la somme des |g_i|

    composantes exactement nulles           23882, soit 23.5 %
Lecture
La composante la plus importante pèse fois la composante médiane. Ce n'est pas une queue de distribution un peu longue : deux ordres de grandeur et demi séparent deux composantes d'un même vecteur, prises au même instant.
La moitié la plus faible des cent mille paramètres ne porte que du total, et un dixième des composantes en porte . Le gradient encode donc bien une importance relative : il dit où le rendement d'une correction est le meilleur.
Une conséquence immédiate pour la règle : est le même pour toutes les composantes, mais le pas effectif ne l'est pas. Un même déplace beaucoup les paramètres importants et presque pas les autres, si bien que c'est le gradient, et non le réglage, qui répartit l'effort.
Près d'un quart des composantes sont exactement nulles, et elles sont toutes dans , dont elles occupent des coefficients. Ce n'est pas un arrondi, et la mesure suivante dit d'où elles viennent.
Un socle horizontal se dessine au milieu de l'écran, et une cote s'inscrit dessous : cent un mille sept cent soixante-dix composantes. C'est la taille du vecteur gradient. Une barre large monte alors depuis ce socle et ne s'arrête qu'en haut du cadre ; sa valeur s'inscrit au-dessus, zéro virgule un zéro zéro huit quatre : c'est la plus grande des cent un mille composantes. Une seconde barre monte juste à côté, à la même échelle, et elle s'arrête si bas qu'on la prendrait pour un épaississement du socle : c'est la composante médiane, la valeur qui partage le vecteur en deux moitiés égales. Sa valeur ne peut pas s'inscrire au-dessus d'elle, il n'y a pas la place : elle s'inscrit haut au-dessus, zéro virgule zéro zéro zéro deux quatre neuf trois cinq, reliée à sa barre par un mince trait d'appel qui descend jusqu'au socle. Une accolade de brique court enfin le long de la grande barre, du socle jusqu'à son sommet, et porte un seul nombre : quatre cent quatre. C'est par là qu'il faut multiplier la seconde barre pour obtenir la première, et la moitié des composantes du gradient sont plus petites encore que la seconde.
D'où viennent les zéros
Le coefficient qui relie le pixel au neurone caché ne compte, pour une image donnée, que par le produit de deux quantités : l'encre du pixel sur cette image, et ce que le neurone renvoie vers l'arrière. Un pixel blanc annule le premier facteur ; un neurone éteint, c'est-à-dire un neurone que a coupé parce que sa préactivation était négative, annule le second. La composante du gradient étant la somme de ces produits sur les images de l'échantillon, elle est nulle quand, pour chaque image, l'un des deux facteurs l'est. Le chapitre 4 écrira ce produit ; ici il suffit de savoir qu'il en est un.
Deux cas extrêmes s'en déduisent, pixel blanc sur toutes les images et neurone éteint sur toutes les images, et il en reste un troisième, entre les deux, qu'il a fallu mesurer.
La décomposition des zéros · cours/lecon3/mesures.py, mesure 10
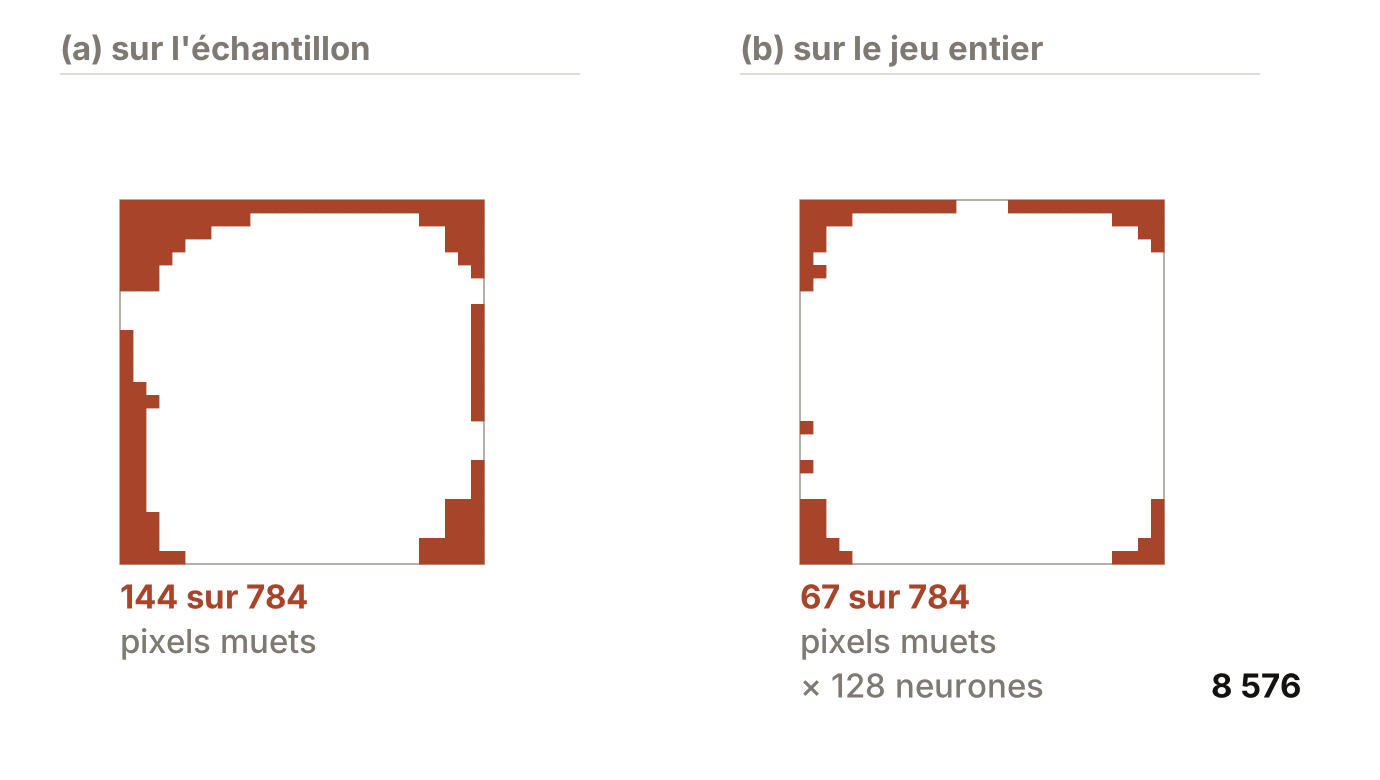
    pixels jamais encrés sur les 2048 exemples      144 sur 784
    pixels jamais encrés sur les 60000 images    67 sur 784
      terme intrinsèque au jeu dans W^[1]   67 x 128 = 8576
    neurones cachés éteints sur les 2048       0 sur 128

    zéros dans W^[1]                        23882
      dont colonnes de pixels muets         18432   (144 x 128)
      dont lignes de neurones éteints       0   (0 x 784)
      comptés deux fois (intersection)      -0
      total expliqué                        18432
      reste inexpliqué par les deux causes  5450
        ces zeros portent sur des pixels encres par
        mediane 3 image(s) sur 2048,   maximum 663
        pixels concernes                    295 sur 784
    zéros dans b^[1]                        0   (les neurones éteints)
    zéros dans W^[2]                        0
    zéros dans b^[2]                        0
Lecture
Premier terme, zéros. Sur l'échantillon de images, pixels ne portent jamais d'encre, et leur colonne dans est nulle en entier, soit coefficients.
Les deux comptes de pixels muets ne disent pas la même chose. Sur les images du jeu entier, seuls pixels sont muets, et c'est le terme intrinsèque au jeu, , celui qui subsisterait quel que soit l'échantillon. Les de l'échantillon comprennent ces plus pixels qui sont encrés quelque part dans le jeu, mais pas dans ces images-là.
Le deuxième terme est nul. Aucun neurone caché n'est éteint sur les images à la fois : la couche n'a pas de neurone mort au départ, et n'a donc aucune composante nulle.
Troisième terme, zéros, et il ne se devinait pas. Ils portent sur pixels encrés par une poignée d'images, la médiane étant de images sur . Il suffit que ces trois images-là aient ce neurone-là éteint pour que le produit soit nul sur toute la somme. Ce n'est ni un pixel mort ni un neurone mort : c'est une rencontre entre les deux.
et n'ont aucun zéro : la couche de sortie voit toujours quelque chose.
La composante la plus grande du gradient vaut fois la médiane.
- a
Qu'est-ce que cela dit sur l'effet d'un même pas appliqué à tous les poids ?
- b
Si l'on voulait que tous les paramètres bougent autant les uns que les autres, que faudrait-il changer dans la règle ? Et que perdrait-on en le faisant ?
- c
Un paramètre dont la composante est nulle à ce pas est-il inutile ? Répondre en citant la décomposition des zéros.
Aucune réponse à cliquer : il y a un calcul à faire.
Trois étages, et aucun ne vit où vit le précédent
| Objet | Départ | Arrivée | Ce qui y varie |
|---|---|---|---|
Le réseau | Une image ; est fixé | ||
Le coût | Les paramètres ; est fixé | ||
Le gradient | Les paramètres ; il rend un vecteur, pas un nombre |