Il n'y a pas une bonne réponse
Trois entraînements, trois solutions sans rapport : il n'y a pas un seul bon jeu de réglages.
Deux entraînements qui ne diffèrent que par leur tirage de départ arrivent-ils au même endroit ?
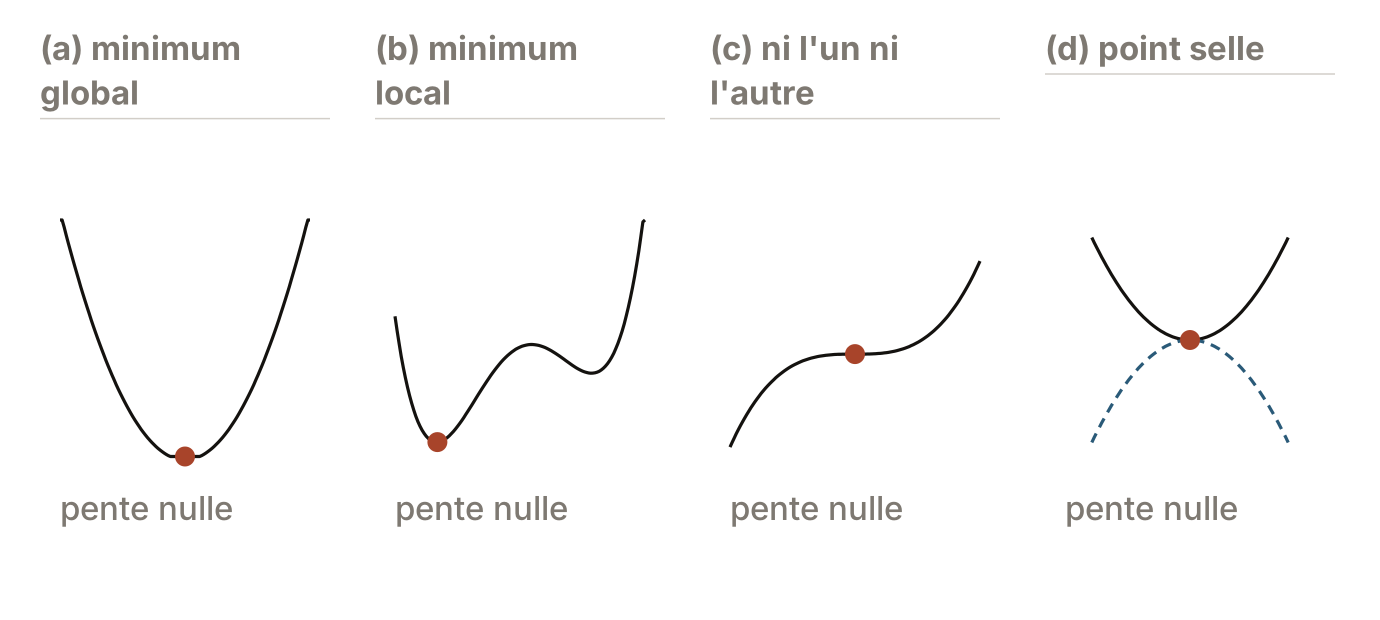
L'énoncé de la page 3 demande un élément de , et il faut donc savoir ce que cet ensemble contient avant de savoir ce que la descente y attrape. Les quatre noms que porte la figure se définissent dans l'ordre, et la page s'en sert ensuite sans y revenir.
Un mot de mesure, aussi, parce que toute la page en vivra. Comparer deux jeux de paramètres et par ne dirait rien, faute d'échelle : on rapporte donc l'écart à la taille de ce qu'on compare, et la distance relative est . Pour deux vecteurs de même norme, elle vaut exactement quand ils sont orthogonaux, plus quand l'angle dépasse l'angle droit, moins quand il reste en deçà.
Quatre points remarquables, distingués
- Minimum locallocal minimum
Un point tel qu'il existe un voisinage de sur lequel pour tout . La comparaison ne porte que sur le voisinage : ailleurs, peut être bien plus basse.
- Minimum globalglobal minimum
Un point tel que pour tout de l'espace. est exactement l'ensemble des minima globaux.
- Point critiquecritical point, stationary point
Un point où . C'est exactement l'ensemble des points où la descente s'arrête, puisque la mise à jour y devient l'identité.
- Point sellesaddle point
Un point critique qui n'est ni un minimum local ni un maximum local : y croît dans certaines directions et y décroît dans d'autres. En dimension , c'est la forme d'un col de montagne, ou d'une selle de cheval.
Un exemple de chacun
| Point | Exemple | ? |
|---|---|---|
Minimum global | sur : le point , et lui seul | oui |
Minimum local non global | : le creux de gauche est local, celui de droite est plus bas | oui |
Point critique qui n'est pas un minimum | en : la dérivée s'annule, mais décroît de part et d'autre | oui |
Point selle | en : minimum le long de , maximum le long de | oui |
Le coût prend la même valeur en un nombre gigantesque de points
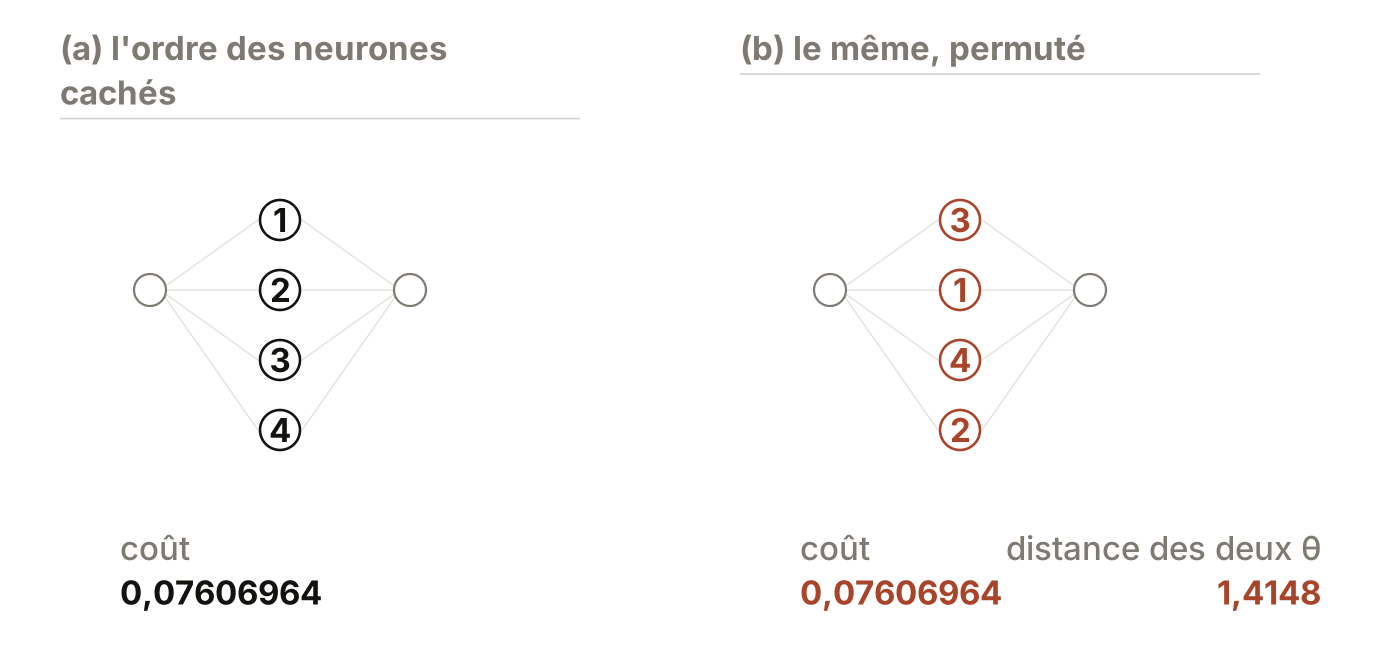
Hypothèses
avec et .
est une permutation de , c'est-à-dire une façon de réordonner les neurones cachés. Sa matrice est définie par : elle range en -ième position la coordonnée que y envoie.
s'applique composante par composante, au sens de la convention du chapitre 2.
Propriétés utilisées
pour toute matrice de permutation
: une fonction appliquée coordonnée par coordonnée commute avec une permutation des coordonnées
Étapes
On pose le paramètre permuté :
Pourquoi à gauche d'un côté et à droite de l'autre. Multiplier à gauche par permute ses lignes, donc les neurones cachés, ce qui est bien ce qu'on veut faire. Il faut alors que la couche de sortie aille rechercher chaque neurone à sa nouvelle place, c'est-à-dire défaire la permutation : c'est , et c'est le seul facteur qui se simplifie à l'étape suivante. ne bouge pas, puisqu'il porte les dix classes et non les neurones. Les dimensions suivent : et .
Substitution directe des quatre blocs permutés.
par linéarité, puis commute avec : permuter les coordonnées puis appliquer à chacune, ou l'appliquer puis permuter, donne le même vecteur.
.
L'égalité vaut pour tout , donc comme fonctions, donc quel que soit le jeu.
Résultat
Interprétation
À partir d'un point, la famille des a autant de membres qu'il y a de façons d'ordonner neurones, soit , et tous ont un coût rigoureusement identique, sans qu'on ait rien calculé. Si est un minimiseur, tous le sont : l'ensemble , s'il n'est pas vide, n'est donc jamais réduit à un point. Et dépasse de très loin le nombre d'atomes de l'univers observable. Chercher « le » minimum n'a pas de sens.
Ce que ce résultat ne dit pas
La proposition ne dit pas que ces points sont les seuls : elle en construit une famille, elle n'en fait pas l'inventaire.
Elle ne dit pas non plus qu'ils sont tous distincts. Deux permutations donnent le même dès que deux neurones cachés portent exactement les mêmes poids et le même biais, ce qui n'arrive pas sur un réseau tiré au hasard mais reste une possibilité. Le compte est donc un majorant du nombre de permutations, et le nombre de points distincts lui est au plus égal.
Elle vaut pour toute largeur et pour toute activation appliquée composante par composante, aussi bien que .
Elle ne dit rien de la qualité de ces points : ils ont tous exactement le même coût, quel qu'il soit.
La proposition 6, vérifiée numériquement · cours/lecon3/mesures.py, mesure 6
      coût de theta                          0.076069643927
      coût de theta permuté (une permutation) 0.076069643927
      écart                                  1.388e-17
      distance relative entre les deux theta  1.4148
      nombre de permutations de 128 elements  128! ~ 3,86e215
Lecture
Les deux coûts coïncident sur les douze décimales affichées, et l'écart mesuré, , est de l'ordre de la précision d'un flottant de 64 bits. Ce n'est pas « presque égal » : c'est égal, à l'arrondi de la machine près.
Et pourtant les deux sont à distance relative , c'est-à-dire presque orthogonaux. Deux points sans aucun rapport dans , et exactement le même coût.
Une seule permutation suffit à le montrer, et il y en a .
Trois entraînements, trois solutions sans rapport
La proposition 6 construit des minimiseurs par symétrie, et il reste à savoir ce que la descente atteint en pratique quand on ne change que le point de départ. Trois entraînements, même protocole, seule la graine diffère.
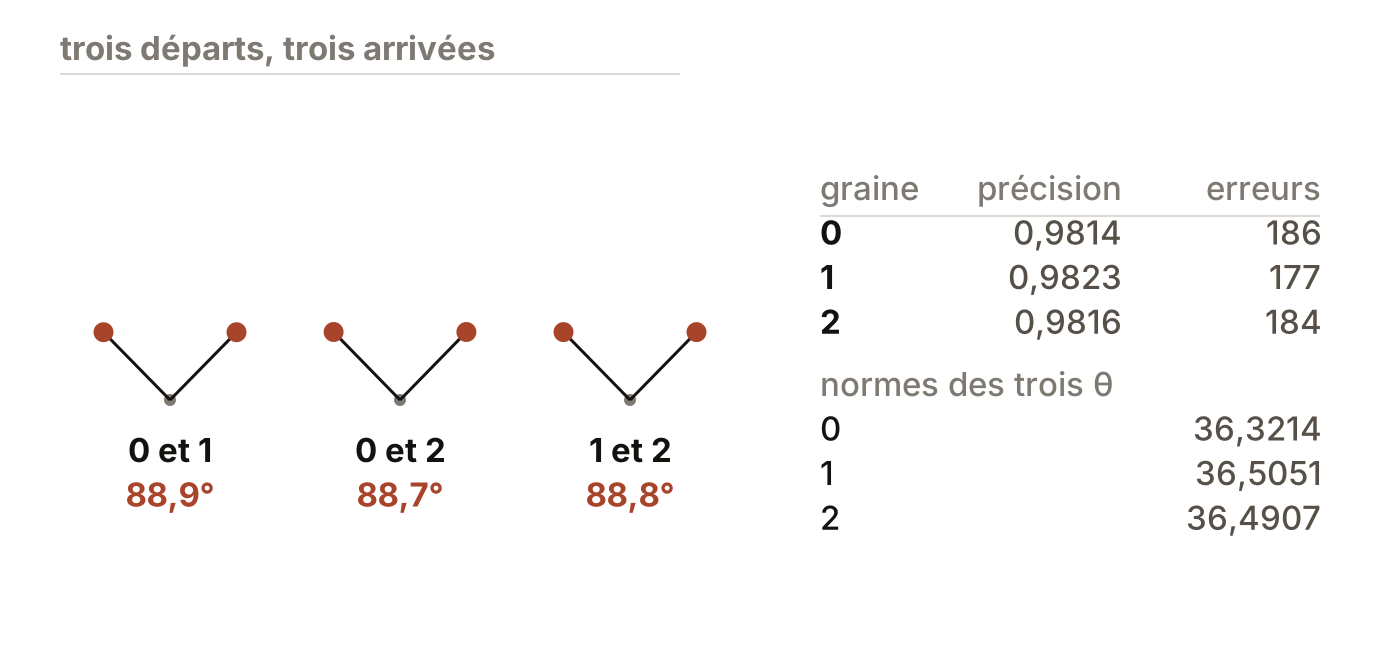
Trois graines, 30 époques · cours/lecon3/mesures.py, mesure 6
    graine 0 : précision test 0.9814   186 erreurs
    graine 1 : précision test 0.9823   177 erreurs
    graine 2 : précision test 0.9816   184 erreurs

      norme de chaque theta : 36.3214   36.5051   36.4907

      couple      ||a - b|| / ||a||     cos(a, b)
      0 et 1          1.4036             +0.0199
      0 et 2          1.4010             +0.0232
      1 et 2          1.3991             +0.0209

      pour reference : deux vecteurs de meme norme et orthogonaux
      sont a distance relative racine de 2 = 1.4142
Lecture
Les trois précisions sont pratiquement identiques, , et , soit un écart de erreurs sur . Les trois solutions sont aussi bonnes l'une que l'autre.
Les trois distances relatives valent entre et , et . Deux vecteurs de même norme et orthogonaux sont exactement à distance relative , donc les trois solutions sont quasiment orthogonales deux à deux.
La colonne des cosinus le dit directement, , et , soit environ : trois points essentiellement sans rapport dans .
Les trois normes sont voisines, , et , donc ce ne sont pas trois solutions de tailles différentes, ce sont trois directions différentes.
Il n'y a donc pas une bonne réponse que la descente chercherait et qu'elle trouverait plus ou moins bien. Il y en a une infinité, la proposition 6 en construit d'un coup, et la mesure montre que trois points de départ suffisent à en atteindre trois sans rapport entre eux. Le point de départ décide seul de celle qu'on obtient, et la question utile n'est pas laquelle on atteint, mais si elle est bonne.
Un repère occupe l'écran, l'axe horizontal nommé « un paramètre », l'axe vertical « le coût ». Une courbe épaisse s'y trace, ondulante : trois creux séparés par deux bosses arrondies, et les trois creux sont sensiblement à la même hauteur, celui de droite à peine plus bas que celui du milieu, lui-même à peine plus bas que celui de gauche. Trois points pleins de brique se posent alors sur la courbe, à trois endroits éloignés les uns des autres. Ils se mettent à descendre tous les trois en même temps, chacun glissant vers le bas de la pente sous lui, d'abord vite puis de plus en plus lentement. Aucun ne rejoint les autres : chacun s'immobilise au fond du creux au-dessus duquel il se trouvait au départ. Sous chaque point s'inscrivent alors le nom de sa graine et la précision qu'elle a mesurée : graine zéro, zéro virgule neuf huit un quatre ; graine deux, zéro virgule neuf huit un six ; graine un, zéro virgule neuf huit deux trois. Les trois se ressemblent au quatrième chiffre. La courbe s'efface ensuite, et les trois solutions reparaissent comme trois points formant un triangle presque équilatéral, dont les trois côtés portent leur longueur mesurée : un virgule quatre zéro trois six, un virgule quatre zéro un zéro, un virgule trois neuf neuf un. Sous le triangle, un segment pointillé de même facture porte un virgule quatre un quatre deux, la valeur qu'aurait chaque côté si les trois solutions étaient exactement orthogonales : les trois côtés mesurés sont juste en dessous.
La proposition 6 se compte, et le compte dépend de la largeur.
- a
Combien de jeux de paramètres distincts donnent exactement le même coût qu'un donné, pour ?
- b
Et pour ?
- c
Ces deux nombres sont-ils du même ordre ? Que vaut le rapport, en ordre de grandeur ?
Aucune réponse à cliquer : il y a un calcul à faire.
Deux entraînements donnent des finaux à distance relative , pour des normes presque égales.
- a
Que vaut le cosinus de l'angle entre eux ? Retrouver l'ordre de grandeur à partir de la distance seule.
- b
Qu'en conclure sur la relation entre les deux solutions ?
- c
Si les deux entraînements avaient convergé vers le même minimum, qu'aurait-on mesuré à la place ?
Aucune réponse à cliquer : il y a un calcul à faire.
Ce qui se lit avant le trajet, et ce qui n’existe qu’après
Si le point atteint dépend du seul tirage de départ, alors une partie des nombres de ce chapitre n'est pas reproductible, et une autre l'est. La ligne de partage est nette, et elle se lit à la nature de la quantité.
La ligne de partage
| Ce qui ne dépend pas de la trajectoire | Ce qui en dépend |
|---|---|
Le rapport de la plus grande composante du gradient à la médiane : | Le coût du réseau au départ : pour la graine |
Les composantes exactement nulles, soit | La décroissance de la norme du gradient : divisée par en trente époques |
Les percentiles de la somme des : , et | Les précisions des trois graines : , , |
Les cosinus par taille de lot, de à | Les , et erreurs correspondantes |
La colonne , entre et | Le point atteint, et donc tout ce qui s'en déduit |
Deux équipes implémentent séparément le protocole de ce chapitre, sans se concerter sur autre chose que l'architecture, les données, la perte, , et le nombre d'époques. Elles ne partagent ni la graine ni l'ordre d'accumulation des sommes.
- a
Parmi ces cinq quantités, dire lesquelles les deux équipes devraient trouver identiques : le nombre de composantes nulles du gradient au point initial ; la précision de test finale ; la colonne ; la norme de après trente époques ; le seuil de du chapitre 2.
- b
Justifier chaque réponse par la nature de la quantité, d'où elle est calculée et à quel moment, et non par la table ci-dessus.
- c
Une sixième quantité, le cosinus moyen d'un lot de , est mesurée au point initial dans ce chapitre. Que deviendrait la réponse si on la mesurait après vingt époques ?
Aucune réponse à cliquer : il y a un calcul à faire.
Ce que la largeur achète
Le chapitre 2 a posé en annonçant que rien ne le justifiait. On ne le justifiera pas davantage ici par un raisonnement : on le mesure. Cinq largeurs, même protocole, même graine.
Cinq largeurs de couche cachée · cours/lecon3/mesures.py, mesure 11
    même protocole pour les cinq : graine 0, eta 0,5, 30 époques

         h          p    acc_test   erreurs    secondes
        32      25450     0.9622       378          21
        64      50890     0.9774       226          27
       128     101770     0.9814       186          33
       256     203530     0.9829       171         101
       512     407050     0.9842       158         177
Lecture
La précision monte avec , sur toute la plage mesurée, et fait mieux que avec erreurs contre . Rien dans cette table ne désigne comme un optimum.
Le rendement décroît nettement. De à les erreurs tombent de à , soit de gagnées pour paramètres ; de à elles tombent de à , soit de gagnées pour paramètres, autrement dit huit fois plus de paramètres pour douze fois moins de gain.
La durée, elle, suit la taille : secondes pour , pour , soit un facteur pour un facteur sur . C'est ce coût-là qu'on paie pour les erreurs gagnées entre et .
Ce que la mesure ne dit pas, et le texte s'arrête là : elle ne dit pas où s'arrêter, et elle ne mesure ni le sur-apprentissage, qui relève du chapitre d'évaluation, ni le coût mémoire, ni ce que donnerait .
est donc un choix, situé dans la zone où le rendement commence à décroître. C'est tout ce que la mesure permet d'en dire, et c'est déjà plus que ce que le chapitre 2 en disait.