Synthèse, formulaire et erreurs fréquentes
L'entraînement en un paragraphe, le formulaire, et les erreurs fréquentes.
Le coût partait à deux virgule quatre, au-dessus de ce que paierait une réponse tirée au sort. Où est-il arrivé ?
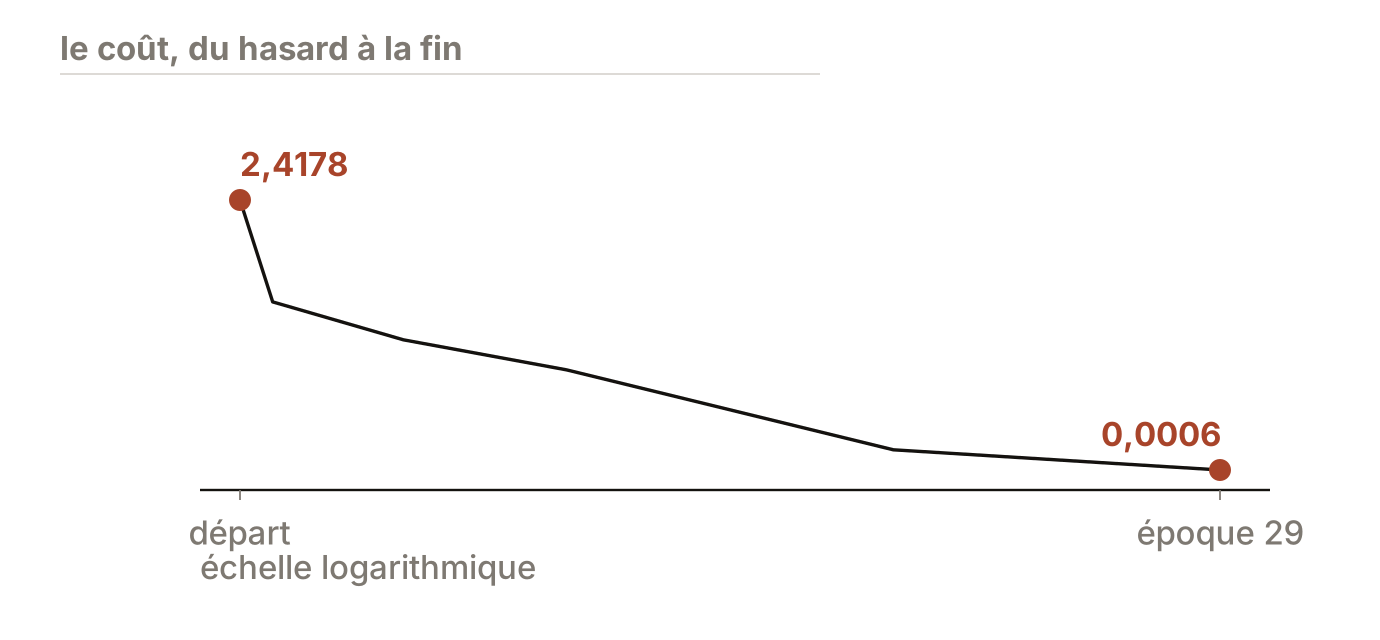
Le trajet
Ce qu'on écrit
Apprendre, c'est écrire non pas l'algorithme qui reconnaît un chiffre, mais celui qui règle ses nombres.
Le point de départ
Au départ ces nombres sont tirés au hasard, et le réseau fait légèrement pire que le hasard, contre , parce qu'il a des préférences arbitraires et se trompe donc parfois avec confiance.
Le coût
On lui donne un coût, l'entropie croisée plutôt que la somme des carrés, parce que sur une sortie confiante et fausse la seconde produit une correction fois plus faible. Moyenné sur le jeu, ce coût devient , dont les entrées sont les paramètres et non les images.
Ce qu'on ne peut pas minimiser
On ne peut pas minimiser le taux d'erreur, dont la dérivée est nulle partout où elle existe, et c'est pour que le coût soit lisse, et pour aucune autre raison, que les activations d'un neurone varient continûment.
La descente, et le pas
On descend donc : le gradient donne la direction de plus forte croissance, son opposé celle de plus forte descente, et décide de la longueur du pas. À la descente ne descend rien, à elle n'a pas fini en cinq époques, et est le meilleur des sept réglages mesurés.
Les lots
On n'évalue pas le coût sur les images pour faire un pas : un lot de pointe à degrés du bon gradient, mais il vise juste en moyenne, et cela suffit.
Ce que le gradient encode
Le vecteur obtenu est très inégal d'une composante à l'autre, la plus grande valant fois la médiane, si bien que le même déplace beaucoup certains paramètres et presque pas les autres. Sa longueur, elle, rétrécit d'un facteur au fil des époques, et les pas se raccourcissent donc tout seuls.
Et il n'y a pas une bonne réponse
Enfin jeux de paramètres donnent exactement le même coût, et trois graines suffisent à obtenir trois solutions quasiment orthogonales, à , et de précision.
Formulaire
| Objet | Formule | Page |
|---|---|---|
Le problème | trouver | 3 |
Perte quadratique | 5 | |
Entropie croisée | 5 | |
Sensibilité de l'entropie croisée | 5 | |
Coût sur le jeu | 6 | |
Taux d'erreur | , à valeurs dans | 7 |
Fonction convexe | 7 | |
Décroissance à l'ordre 1 | 7 | |
Dérivée partielle | 8 | |
Gradient | 8 | |
Dérivée directionnelle | 8 | |
Proposition 3, admise | pour | 8 |
Mise à jour | 8 | |
Différence finie centrée | 8 | |
Coût sur un lot | 9 | |
Cosinus | 9 | |
Proposition 4 | 9 | |
Proposition 5 | , indépendant de | 9 |
Proposition 6 | , même coût | 11 |
Tous les objets du chapitre
La colonne de droite donne la page où l'objet est défini, c'est-à-dire la page qui dit ce qu'il est. La page 1 en nomme plusieurs avant cela, dans ses objectifs et ses tableaux de dettes, mais aucun n'y est employé dans un calcul : c'est le propre d'une page de cadre que d'annoncer ce qu'elle ne fait pas encore.
Fonctions, avec départ et arrivée
| Fonction | Départ | Arrivée | Définie page |
|---|---|---|---|
2, du chapitre 2 | |||
5 | |||
5 | |||
6 | |||
9 | |||
, taux d'erreur | 7 | ||
8 | |||
8 | |||
9 | |||
vecteurs aléatoires de | 9 | ||
vecteurs aléatoires de | 9 | ||
événements | 9 | ||
fonctions | parties de | 3 |
Symboles, ensembles et dimensions
| Symbole | Signification | Ensemble | Dimension | Nature |
|---|---|---|---|---|
Tous les paramètres, rangés | Paramètre appris | |||
Sa valeur à l'itération | Calculé | |||
Sa -ième composante | Paramètre appris | |||
Nombre de paramètres | Constante : | |||
Indice d'itération | – | Indice | ||
Indice de composante | – | Indice | ||
Indice d'exemple | – | Indice | ||
Taille du jeu d'entraînement | Constante : | |||
, | Les deux jeux | – | Paramètre de la définition, jamais variable | |
Un mini-lot | , | – | Tiré au hasard | |
Taille du lot | Réglage : | |||
Taux d'apprentissage | Réglage : | |||
, | Gradient complet, gradient d'un lot | Calculés | ||
Composante du gradient | Calculée | |||
Gradient de la perte du seul exemple | Calculé | |||
Variance des autour de | Mesurée | |||
, sans dimension | Mesuré : entre et | |||
Pas de la différence finie | Réglage : | |||
Direction unitaire | Choisie | |||
-ième vecteur de la base canonique | Constante | |||
Largeur de la couche cachée | Réglage : | |||
Matrice de permutation des neurones | Construite | |||
Fonctions dérivables sur , de dérivée continue | ensembles de fonctions | – | Ensembles | |
Un minimiseur | Cherché |
L'algorithme complet
ENTREE D_train N couples (x, c), fixes eta dans R_{>0} B taille de lot, dans N* T nombre d'epoquesSORTIE theta un vecteur de R^p 1. theta <- tirage au hasard dans R^p2. pour t de 1 a T :3. ordre <- une permutation de [1, N]4. pour chaque tranche B_k de B indices consecutifs de ordre :5. g <- grad_theta C_{B_k}(theta) un vecteur de R^p6. theta <- theta - eta * g p soustractions7. rendre theta COUT ligne 5, par differences finies 2p propagations avant ligne 5, par l'algorithme du ch. 4 1 propagation avantUn trait vertical se pose à gauche de l'écran : c'est l'origine commune de cinq flèches horizontales, empilées les unes sous les autres. La première pousse vers la droite et traverse presque toute la largeur du cadre ; à sa gauche s'inscrit « époque zéro », à sa droite sa longueur mesurée, zéro virgule zéro huit sept huit sept huit — c'est la norme du gradient au début de l'entraînement. La deuxième flèche pousse en dessous et s'arrête nettement plus tôt, à zéro virgule zéro cinq huit cinq trois trois, pour l'époque quatre. La troisième, celle de l'époque neuf, pousse à son tour et dépasse la deuxième : elle vaut zéro virgule zéro six cinq sept deux zéro, donc le gradient a repris de l'ampleur au lieu de continuer à décroître. Les deux dernières sont d'un autre ordre : celle de l'époque dix-neuf n'est plus qu'un trait court, zéro virgule zéro zéro deux cinq trois cinq, et celle de l'époque vingt-neuf est à peine visible à côté de l'origine, zéro virgule zéro zéro zéro huit trois trois. Une accolade de brique court enfin le long de la première flèche et porte un seul nombre, cent cinq : c'est par là que la norme du gradient a été divisée entre la première et la dernière époque mesurée.
Erreurs fréquentes
| L'erreur | Ce qui est vrai |
|---|---|
Confondre et | prend une sortie et une étiquette, prend des paramètres. Ils ne vivent pas dans le même espace, et on ne minimise que le second |
Écrire | est fixé et n'est jamais dérivé : c'est un paramètre de la définition, que l'indice en bas note |
Confondre et | est une itération, une composante. Dans ce chapitre les deux lettres sont réservées, sans exception |
Croire qu'on minimise le taux d'erreur | Son gradient est nul partout où il existe : on minimise en espérant que suive, et rien ne le garantit |
Croire que le signe moins est une convention | C'est le seul signe qui rende le terme dominant négatif dans les deux cas de figure |
Croire que la proposition 2 donne un seuil sur | Elle dit « pour assez petit » sans quantifier. Le seuil se cherche par balayage, et son calcul est ailleurs |
Croire qu'un trop grand fait juste converger plus lentement | et échouent pour des raisons opposées : le premier ne descend rien, le second n'a pas fini |
Croire qu'un mini-lot donne le bon gradient | Il donne un gradient à degrés du bon, à . Il est seulement sans biais : juste en moyenne, jamais sur un tirage |
Croire que doubler divise l'erreur par deux | L'écart décroît comme et l'angle comme : quadrupler divise l'angle par deux |
Croire que le gradient est une pente, donc un nombre | C'est un vecteur de , de même dimension que . C'est sa norme qui est un nombre, et elle mesure la raideur |
Croire qu'un même déplace tous les paramètres d'autant | Le pas effectif est , et varie d'un facteur entre la plus grande composante et la médiane |
Chercher « le » minimum | contient au moins points, et trois graines donnent trois solutions quasiment orthogonales, toutes bonnes |
Croire que la descente peut sortir d'un creux | Arrivée en un point critique, elle est immobile pour toujours : la mise à jour y devient l'identité. C'est là que l'image de la bille trompe |
Croire que les différences finies sont fausses | Elles sont correctes, puisqu'elles ont produit toutes les vérifications de ce chapitre, et inutilisables pour entraîner : propagations avant par gradient |
Les quatorze vérifications de ce chapitre
La numérotation est continue sur tout le parcours : les numéros à sont au chapitre 2, et ceux-ci vont de à .
| N° | Page | Section | Ce qu'elle demande |
|---|---|---|---|
21 | 3 | Le problème, écrit | Les ensembles de et de , et pourquoi ils diffèrent |
22 | 4 | Comment fait-on pire que le hasard | Comment un réseau non entraîné dépasse |
23 | 5 | Deux candidates | Classer quatre sorties par coût, avec chacune des deux pertes |
24 | 6 | Le jeu n'est pas une variable | Le statut de , justifié par ce qu'on dérive |
25 | 7 | Proposition 1 | Les valeurs du taux d'erreur, et le gradient nul qui s'en déduit |
26 | 7 | Proposition 2 | La suite pour et |
27 | 8 | Le gradient | Sa dimension pour deux architectures, et si elle dépend de |
28 | 8 | Le taux d'apprentissage | Si les échecs à et sont de même nature |
29 | 9 | Proposition 5 | L'angle correspondant à , et pourquoi ça marche |
30 | 9 | Proposition 5 | Le cosinus attendu pour , par interpolation |
31 | 10 | La distribution | Ce que le rapport dit d'un même pas appliqué à tous les poids |
32 | 11 | Proposition 6 | Le compte des minimiseurs pour puis |
33 | 11 | Trois graines | Le cosinus déduit d'une distance relative de |
34 | 11 | La ligne de partage | Quelles quantités deux implémentations indépendantes doivent trouver identiques |
La suite du parcours
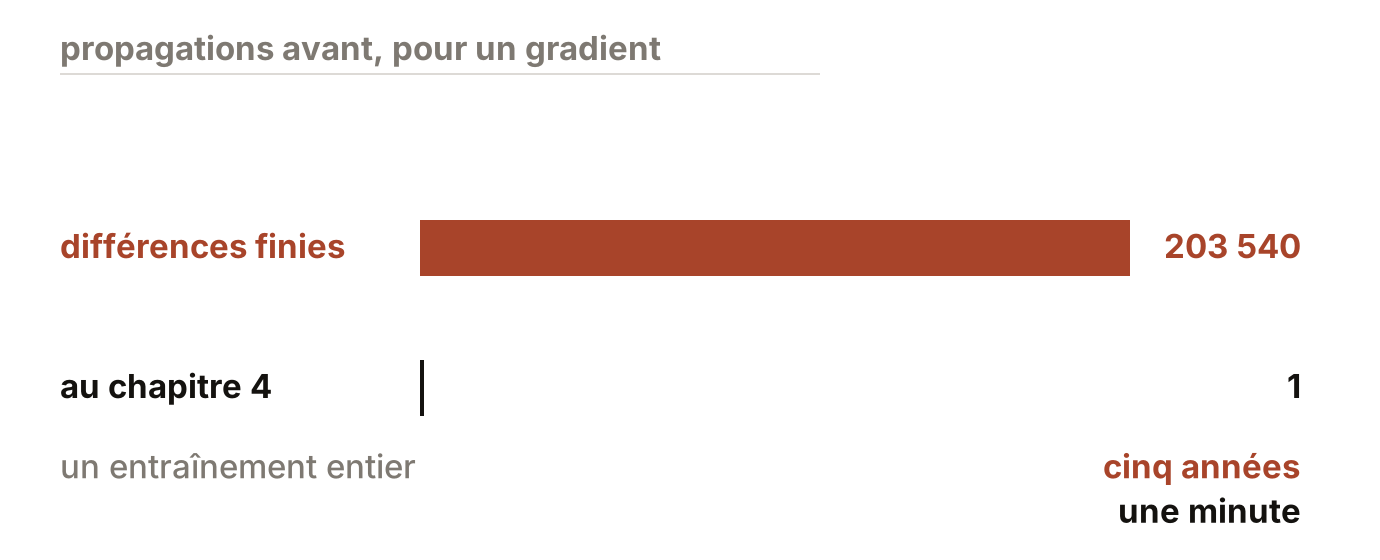
Tout ce chapitre repose sur la ligne de l'algorithme, et c'est par différences finies qu'il l'a vérifiée : propagations avant par gradient, une heure et demie par pas sur ce poste, et environ cinq années pour un entraînement de mises à jour, quand le même entraînement mené autrement prend une minute.
C'est précisément cet écart qui rend la suite nécessaire. Il existe un algorithme qui obtient les composantes en une propagation avant et une passe en sens inverse, exactement et non approximativement, et il porte un nom : la rétropropagation. Ce chapitre l'a utilisé sans le nommer, puisque c'est lui qui a entraîné tous les réseaux dont les mesures sortent, et les différences finies n'ont servi qu'à le contrôler. Le chapitre 4 dit ce qu'il fait, avant tout calcul ; le chapitre 5 le calcule.