Le cadre du cours
Ce que le chapitre règle : comment obtenir le gradient sans le calculer composante par composante.
Une image traverse le réseau, dix nombres en sortent, et l'étiquette dit lequel des dix aurait dû l'emporter. Il faut maintenant corriger les coefficients du réseau pour que ce soit le cas la prochaine fois, et il y en a plus de cent mille. Par où commence-t-on ?
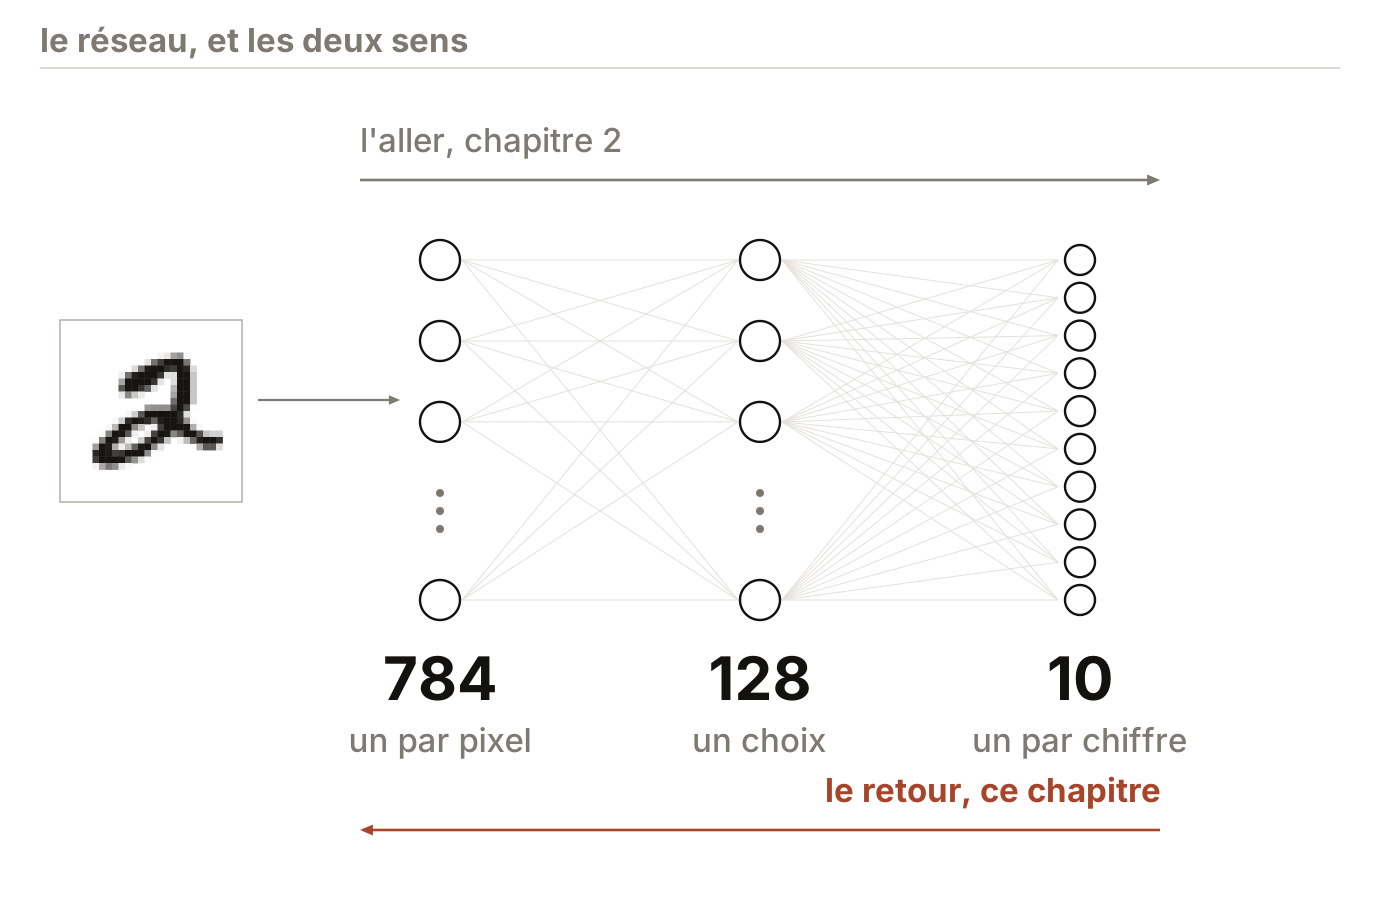
La colonne de gauche porte un rond par pixel de l'image, soit , celle de droite en porte dix, un par chiffre possible, et celle du milieu en porte , la largeur que le chapitre 3 a justifiée par la mesure.
La flèche grise est le calcul du chapitre 2, qui part de l'image et rend dix nombres. La flèche de brique va dans l'autre sens.
Le chapitre 3 a établi ce qu'on cherche, une valeur de qui minimise , et par quel procédé on la cherche : faire un pas dans la direction , puis recommencer. Il n'a obtenu ce vecteur que par différences finies centrées, à un coût qui interdit d'entraîner.
Prérequis
- 01
Le softmax et la perte d'un exemple, définis au chapitre 2, page 6, avec l'encodage ; le nom d'entropie croisée est posé au chapitre 3, page 5.
- 02
La dérivée partielle et le gradient, définis au chapitre 3, page 8, avec leurs types : un scalaire pour la première, un vecteur colonne de pour le second.
- 03
Les différences finies centrées , employées au chapitre 3 comme procédé de contrôle, et leur coût.
- 04
Le produit matriciel et sa règle de dimensions : , le nombre de colonnes du premier facteur devant égaler le nombre de lignes du second.
- 05
L'architecture du chapitre 2 : , sur la couche cachée, en sortie.
Objectifs
- 01
Lire sur les dix nombres que le réseau vient de rendre dans quel sens chacun doit bouger, et sur quelle quantité cette lecture porte.
- 02
Démontrer qu'un seul des dix doit monter, et que sa correction pèse autant que celles des neuf autres réunies.
- 03
Démontrer que la dérivée de la perte par rapport à un biais de la dernière couche ne dépend d'aucune activation.
- 04
Démontrer que la dérivée par rapport à un poids est exactement proportionnelle à l'activation d'où ce poids part, et écrire les dérivées d'un coup.
- 05
Lire sur le signe d'un poids le sens dans lequel l'activation d'avant doit varier.
- 06
Démontrer que les dix termes portés sur une même activation cachée s'additionnent, et que cette somme s'écrit avec la matrice transposée.
- 07
Écrire le passage d'une couche à l'autre, et dire ce que laisse passer au retour.
- 08
Démontrer que la moyenne des corrections d'exemples est le gradient du coût, sans facteur ni approximation.
- 09
Vérifier l'algorithme entier par différences finies, et chiffrer ce qu'il économise.
Plan
- 01
Poser ce qu'on cherche, et le chiffre qui interdit de l'obtenir par différences finies
- 02
Lire, sur un seul exemple, dans quel sens chacune des dix sorties doit bouger
- 03
Suivre la première voie : le biais
- 04
Suivre la deuxième voie : les poids
- 05
Rapprocher la mise à jour de la théorie de Hebb, et dire où l'analogie casse
- 06
Suivre la troisième voie : les activations de la couche d'avant
- 07
Additionner les dix termes portés sur une même activation cachée
- 08
Descendre d'une couche, et traverser
- 09
Passer d'un exemple à tous les exemples
- 10
Écrire l'algorithme, et le vérifier
- 11
Synthèse, formulaire, tableau des objets, erreurs fréquentes
Ce que ce chapitre règle
Le chapitre 3 se termine sur un chiffre, et c'est la question qu'il laisse à celui-ci.
| Dette ouverte au chapitre 3 | Réglée page | Comment |
|---|---|---|
Un gradient par différences finies centrées coûte propagations avant, et il en faut un à chaque pas | 3 à 11 | Par l'algorithme construit aux pages 3 à 9, puis chronométré page 11 : µs contre s sur la même machine |
Ce que ce chapitre laisse ouvert
| Dette | D'où elle vient | Chapitre qui la rembourse |
|---|---|---|
La preuve de la règle de la chaîne, dans ses deux formes | Page 3 : les deux énoncés sont admis et vérifiés numériquement, non démontrés | Bloc de mathématiques : l'approximation au premier ordre |
La dérivée de la perte d'entropie croisée composée avec le softmax, | Page 3 : le chapitre 2 pose le softmax et la perte, mais n'y dérive aucun gradient | Bloc de mathématiques, avec la règle de la chaîne dont elle est un cas |
La forme générale à couches, et le traitement d'une fonction d'activation quelconque | Page 9 : le passage d'une couche à l'autre est écrit une fois, pour et pour deux couches | Chapitre 5 : la règle de la chaîne multivariée sous forme jacobienne |