• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
37/59
Lecture5 min

Ce qu'on cherche, et ce qu'on ne sait pas encore calculer

Pourquoi la méthode du chapitre précédent est exacte, et pourtant inutilisable pour entraîner.

Le chapitre 3 sait quoi faire d'un gradient, et il ne sait pas en fabriquer un. Le procédé qui lui servait à mesurer coûte deux cent mille traversées du réseau pour une seule image, et un entraînement en fait des dizaines de milliers. Que manque-t-il exactement à la chaîne, et combien coûte le seul moyen connu de le fabriquer ?
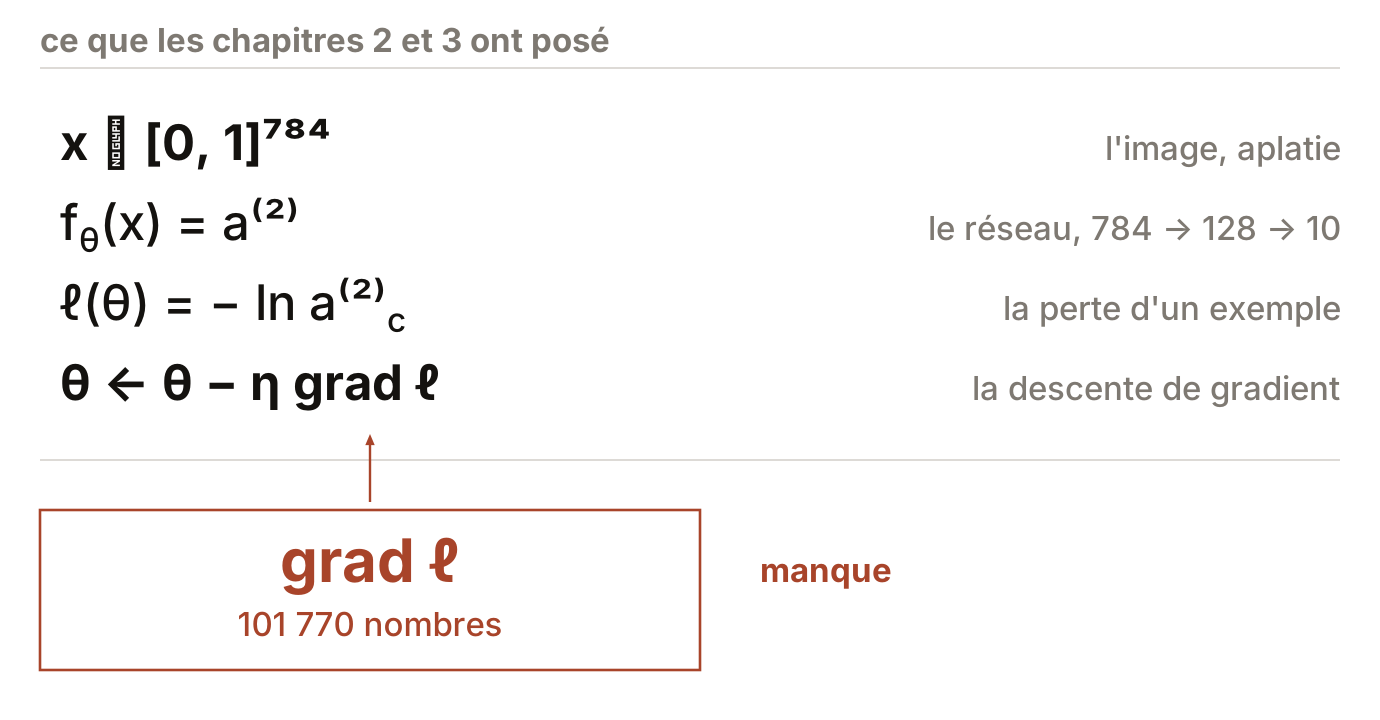
Quatre lignes, chacune portant à gauche une écriture mathématique et à droite ce qu'elle désigne. La première donne l'entrée, un vecteur de sept cent quatre-vingt-quatre valeurs entre zéro et un, et la mention l'image, aplatie. La deuxième donne le réseau appliqué à l'image, qui rend les activations de la couche deux, avec la mention le réseau, sept cent quatre-vingt-quatre vers cent vingt-huit vers dix. La troisième donne la perte, moins le logarithme de l'activation de la classe vraie, avec la mention la perte d'un exemple. La quatrième donne la règle de mise à jour, thêta reçoit thêta moins êta fois le gradient de la perte, avec la mention la descente de gradient. Sous un trait, un cadre de brique porte le gradient de la perte et ses cent un mille sept cent soixante-dix nombres ; une flèche de brique remonte de ce cadre vers la ligne de la descente, et le mot manque est écrit à côté.
La descente sait quoi faire d'un gradient ; elle ne sait pas le calculer.

Les quatre premières lignes sont acquises et rien n'y sera repris : l'image, le réseau et la perte viennent du chapitre 2, la règle de mise à jour du chapitre 3. Le cadre du bas, lui, n'a encore aucun moyen d'être rempli, et la flèche dit qui en a besoin.

Ce qui est déjà posé

  • ·

    L'architecture. z[1]=W[1]x+b[1]\mathbf{z}^{[1]}=W^{[1]}\mathbf{x}+\mathbf{b}^{[1]}z[1]=W[1]x+b[1], a[1]=ReLU(z[1])\mathbf{a}^{[1]}=\mathrm{ReLU}(\mathbf{z}^{[1]})a[1]=ReLU(z[1]), z[2]=W[2]a[1]+b[2]\mathbf{z}^{[2]}=W^{[2]}\mathbf{a}^{[1]}+\mathbf{b}^{[2]}z[2]=W[2]a[1]+b[2], a[2]=softmax(z[2])\mathbf{a}^{[2]}=\mathrm{softmax}(\mathbf{z}^{[2]})a[2]=softmax(z[2]). Chapitre 2, pages 6 et 10.

  • ·

    Le coût. CD(θ)=1N∑nℓn(θ)C_{\mathcal{D}}(\boldsymbol{\theta})=\frac{1}{N}\sum_{n}\ell_{n}(\boldsymbol{\theta})CD​(θ)=N1​∑n​ℓn​(θ), moyenne des pertes d'entropie croisée. Chapitre 3, page 6.

  • ·

    Le procédé. θt+1=θt−η gradθ CD(θt)\boldsymbol{\theta}_{t+1}=\boldsymbol{\theta}_{t}-\eta\,\mathrm{grad}_{\boldsymbol{\theta}}\,C_{\mathcal{D}}(\boldsymbol{\theta}_{t})θt+1​=θt​−ηgradθ​CD​(θt​). Chapitre 3, page 8.

Le coût n'est pas celui de la source

La source expose la rétropropagation sur une somme de carrés, alors que ce cours emploie l'entropie croisée depuis le chapitre 2, et que le chapitre 3 a départagé les deux candidates par une mesure : un rapport de 450450450 entre les deux gradients de départ, page 5. Le changement se voit en un seul endroit, le point de départ du calcul, δ[2]=a[2]−y\boldsymbol{\delta}^{[2]}=\mathbf{a}^{[2]}-\mathbf{y}δ[2]=a[2]−y, qui est plus simple avec l'entropie croisée qu'avec le carré. Tout ce qui suit ce point de départ est identique.

Ce qui manque, et ce que ça coûte

Les 101 770101\,770101770 dérivées partielles existent et se calculent, puisque le chapitre 3 les a obtenues par différences finies centrées et s'en est servi pour toutes ses mesures. Le procédé est exact au terme d'erreur près et n'emploie que des propagations avant, et il est pourtant inutilisable pour entraîner.

∂ℓ∂θi≈ℓ(θ+εei)−ℓ(θ−εei)2ε⟹2p=2×101 770=203 540 propagations avant\frac{\partial \ell}{\partial\theta_{i}}\approx\frac{\ell(\boldsymbol{\theta}+\varepsilon\mathbf{e}_{i})-\ell(\boldsymbol{\theta}-\varepsilon\mathbf{e}_{i})}{2\varepsilon}\quad\Longrightarrow\quad 2p=2\times 101\,770=203\,540\ \text{propagations avant}∂θi​∂ℓ​≈2εℓ(θ+εei​)−ℓ(θ−εei​)​⟹2p=2×101770=203540 propagations avant
(4.1)
Deux propagations par coefficient, 101 770101\,770101770 coefficients, pour un seul exemple. Chapitre 3, page 8, mesure 9.

Le chapitre 3 a mesuré ce que cela donne à l'échelle d'un entraînement, sur 60 00060\,00060000 exemples et des dizaines de milliers de mises à jour : le procédé ne tient pas, et ce n'est pas une question de machine plus rapide. Il faut un algorithme dont le coût soit celui d'une propagation, et non de 203 540203\,540203540.

Ce que ce vecteur contient, et pourquoi on ne le voit pas

gradθ ℓ\mathrm{grad}_{\boldsymbol{\theta}}\,\ellgradθ​ℓ vit dans R101 770\mathbb{R}^{101\,770}R101770, et se le représenter comme une flèche pointant dans une direction ne mène nulle part, puisque personne ne voit une direction dans un espace de cent mille dimensions. Ce qu'on lit d'un gradient, ce sont ses composantes, une par une.

Ce qu'on lit sur ∂ℓ/∂θi\partial\ell/\partial\theta_{i}∂ℓ/∂θi​Ce que ça dit

Son signe

Le sens dans lequel pousser θi\theta_{i}θi​ pour faire baisser la perte, qui est l'opposé de ce signe

Sa taille, comparée aux autres

Combien la perte est sensible à ce coefficient-là, relativement au reste du réseau

La sensibilité a déjà été mesurée

Le chapitre 3, page 10, mesure 4, donne le rapport entre la plus grande composante du gradient et sa médiane sur ce réseau : 404404404. Ce cours emploie ce nombre plutôt qu'un exemple inventé, et ne refait pas la mesure ici.

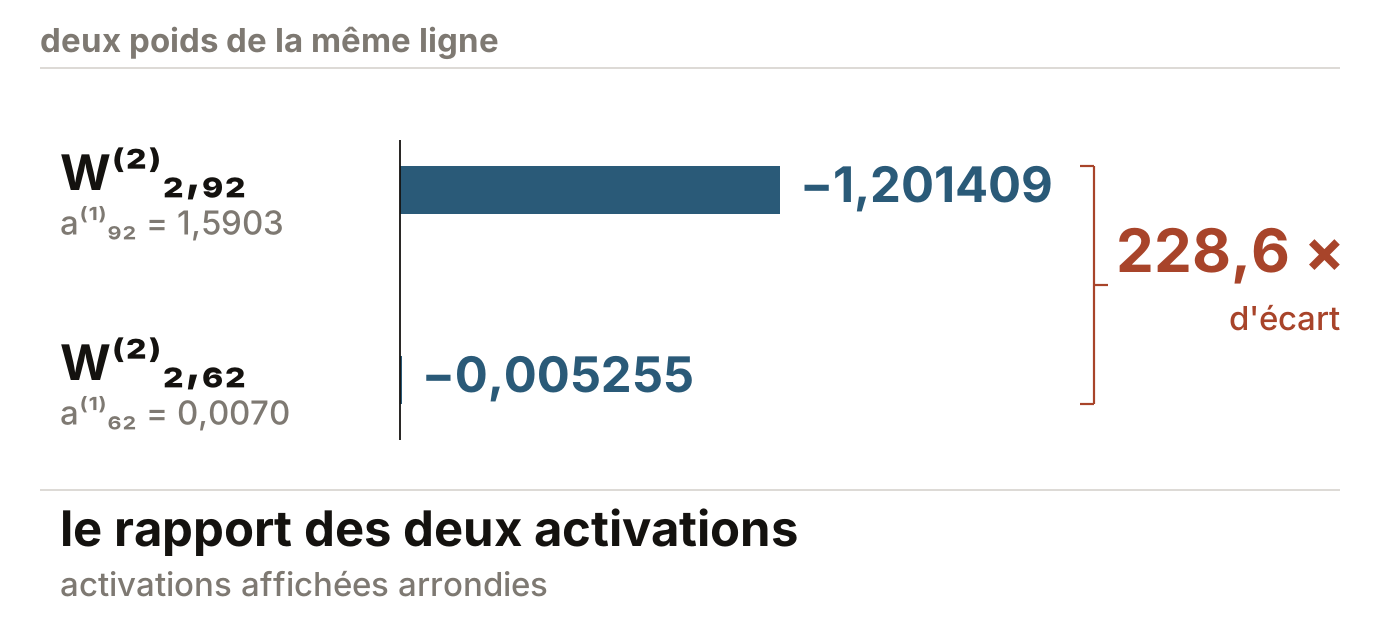
Deux barres horizontales d'ardoise, de longueurs très inégales, partant d'un même axe vertical. La première porte le poids reliant le quatre-vingt-douzième neurone caché au neurone de sortie de la classe deux, dont l'activation vaut un virgule cinq neuf zéro trois ; sa dérivée vaut moins un virgule deux cent un mille quatre cent neuf. La seconde porte le poids venant du soixante-deuxième neurone, d'activation zéro virgule zéro zéro sept zéro ; sa dérivée vaut moins zéro virgule zéro zéro cinq mille deux cent cinquante-cinq, et sa barre se réduit à un trait. Une accolade de brique embrasse les deux et porte la cote deux cent vingt-huit virgule six fois d'écart. En pied, le rapport des deux activations, un virgule cinq neuf zéro trois divisé par zéro virgule zéro zéro sept zéro, vaut deux cent vingt-huit virgule six.
Un gradient n'est pas une liste de nombres du même ordre.

Ce que la rétropropagation est

Rétropropagationbackpropagation

L'algorithme qui calcule gradθ ℓ\mathrm{grad}_{\boldsymbol{\theta}}\,\ellgradθ​ℓ en une propagation avant et une propagation arrière, quel que soit le nombre de coefficients. Ce n'est ni une approximation ni une heuristique : c'est la règle de la chaîne, organisée de façon à ne calculer chaque quantité qu'une fois.

Leçon suivante
PrécédenteLe cadre du coursSuivanteUn seul exemple, et ce que sa sortie réclame