Un seul exemple, et ce que sa sortie réclame
On suit une seule image, et on lit sur des nombres ce que sa sortie réclame.
Tout ce qui suit se joue sur une seule image, et il faut la choisir sans tricher. Le réseau ne l'a jamais vue et il n'a rien appris de personne, mais il va tout de même rendre ses dix nombres. Que lit-on sur ces dix nombres, et sur lesquels peut-on agir ?
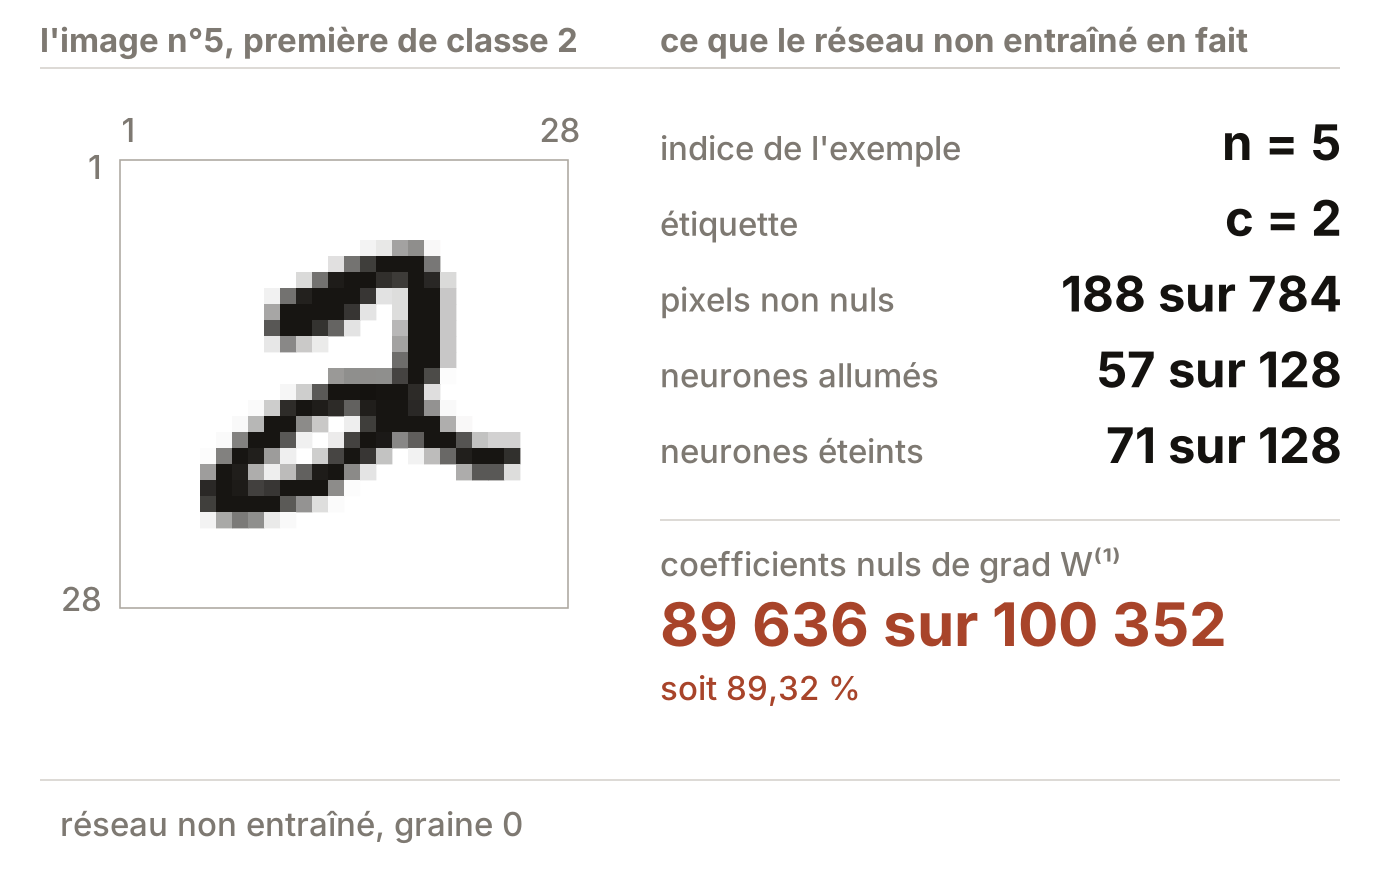
C'est la première image de classe du jeu d'entraînement, celle d'indice , et le réseau qui la reçoit porte les poids de son initialisation, graine .
Le dernier chiffre du relevé se laisse déjà lire comme un indice : près de neuf dixièmes du gradient de la première matrice sont exactement nuls sur cette image.
Ce que le réseau répond
L'exemple de travail · cours/lecon4/mesures.py, mesure 1
  critère            première image de classe 2 du jeu d'entraînement
  indice retenu      n = 5
  étiquette          c = 2

  -- La sortie du réseau non entraîné --------------------------------------
      k    a_k         delta_k
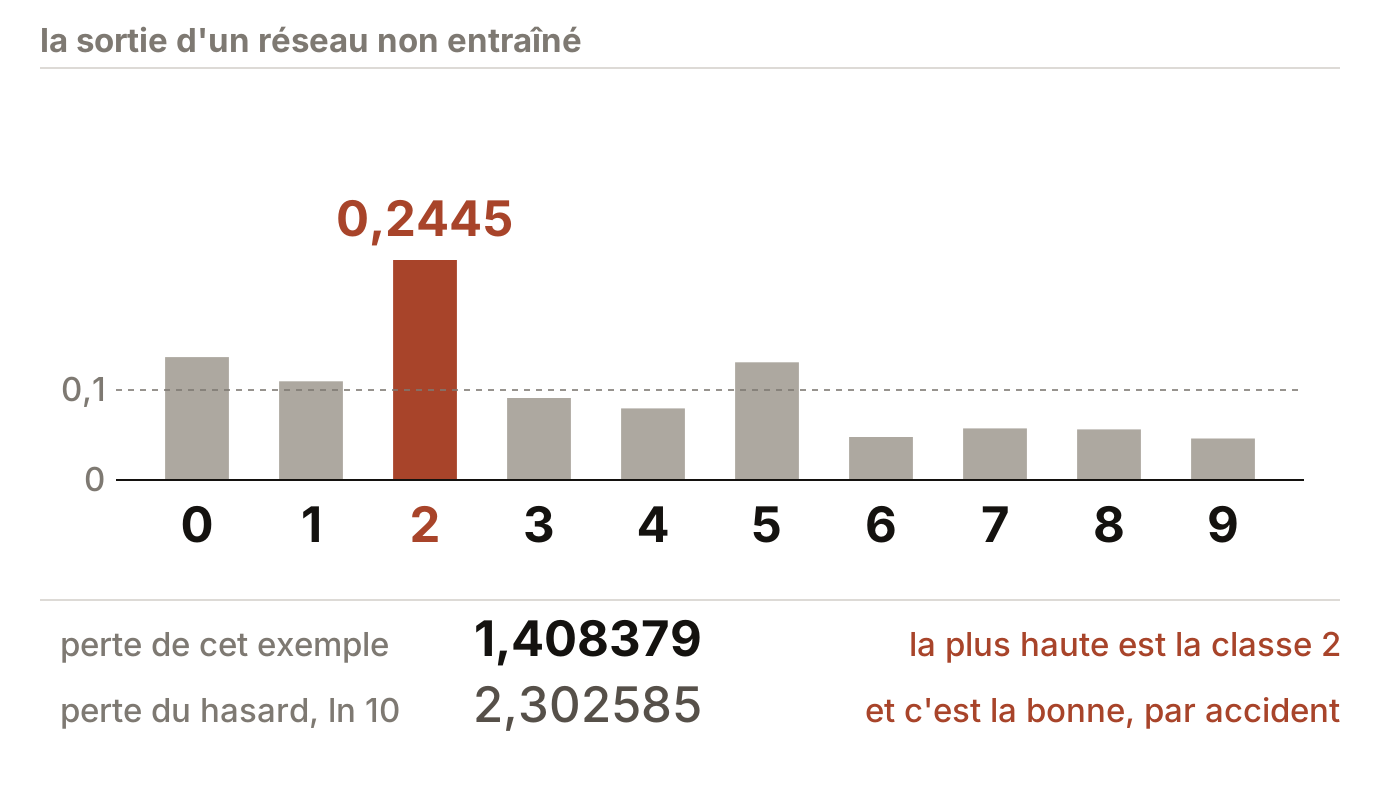
      0    0.1366      +0.1366
      1    0.1098      +0.1098
      2    0.2445      -0.7555
      3    0.0911      +0.0911
      4    0.0796      +0.0796
      5    0.1308      +0.1308
      6    0.0478      +0.0478
      7    0.0574      +0.0574
      8    0.0563      +0.0563
      9    0.0462      +0.0462

  perte de cet exemple            1.408379
  perte du hasard, ln 10          2.302585
  classe prédite                  2
  la plus grande activation       0.2445   (classe 2)

  -- La couche cachée ------------------------------------------------------
  neurones cachés allumés         57 sur 128
  neurones cachés éteints         71 sur 128
  pixels non nuls de l'image      188 sur 784
Lecture
Les dix activations viennent d'un tirage, et l'ordre dans lequel elles tombent n'apprend rien sur l'image : c'est exactement ce qu'on attend d'un réseau non entraîné.
La plus grande est pourtant celle de la classe , à : ce réseau, qui ne sait rien, classe cette image correctement, par accident, et sa perte de est même meilleure que celle du hasard, .
Un réseau non entraîné ne se trompe pas systématiquement ; il répond n'importe quoi, et n'importe quoi tombe juste environ une fois sur dix. La mesure 4 donne la précision de ce réseau sur le jeu de test avant ses deux cents pas : .
neurones cachés sur sont allumés, et ce nombre n'est pas anodin : les autres sont éteints, et un neurone éteint ne fait rien passer, ni à l'aller ni au retour.
Sur la gauche, une grille de vingt-huit cases sur vingt-huit porte en gris l'image d'un deux manuscrit. Les cases encrées se détachent une à une et rejoignent, en glissant vers la droite, les rangs qui leur correspondent dans la première colonne du réseau ; les cases blanches ne bougent pas. La colonne s'assombrit alors, chaque rond à la valeur de son pixel. Une lueur de brique traverse le premier faisceau de la gauche vers la droite, et la colonne cachée s'allume à son tour, très inégalement : quelques ronds sont presque noirs, la plupart restent vides. Une seconde lueur traverse le second faisceau, et les dix ronds de la colonne de sortie se remplissent. À droite de chacun s'inscrit alors son activation mesurée, de zéro virgule zéro quatre six deux à zéro virgule deux quatre quatre cinq. Le rond de la classe deux, le plus sombre des dix, passe au trait de brique avec son étiquette, et sa valeur reste seule en brique sous les neuf autres.
Le signal d'erreur, et pourquoi il dérive par rapport à
- Signal d'erreur d'une coucheerror signal, delta
, vecteur colonne de même dimension que . Sa -ième composante est , un scalaire. Il y a un signal d'erreur par couche : , .
On dérive par rapport à et non par rapport à parce que est l'endroit où les paramètres entrent : . Une fois connu, les gradients de et de s'en déduisent sans autre calcul.
Ce que demande porte sur , et n'est pas modifiable, puisque c'est une valeur calculée. Les seules quantités qu'on puisse modifier sont les poids et les biais : l'image est une donnée, et les activations sont des résultats.
Les deux formes de la règle de la chaîne
On somme dans la seconde forme parce que chaque chemin d'influence apporte sa contribution au premier ordre, et que des contributions au premier ordre s'ajoutent. Ce n'est pas une commodité de calcul.
Une seule composante est négative
Hypothèses
, l'intérieur du simplexe : pour tout , et .
: et pour .
, formule (4.2), admise.
Propriétés utilisées
L'image de est incluse dans l'intérieur du simplexe : aucune coordonnée n'atteint ni
Soustraction composante par composante
Étapes
La composante de la vraie classe. , et strictement, donc .
Les neuf autres. Pour , , et strictement, donc .
Les deux inégalités sont strictes parce que le softmax n'atteint jamais les bords du simplexe.
Résultat
Interprétation
signifie qu'augmenter fait baisser la perte, et pour les neuf autres signifie que les baisser la fait baisser aussi. C'est cela, et rien d'autre, que veut dire « le neurone de la bonne classe doit monter et les neuf autres descendre ».
Ce que ce résultat ne dit pas
L'énoncé porte sur les signes et non sur les tailles : il ne dit pas de combien pousser, et il ne dit rien de ce qui arrive après un pas.
Il vaut pour la sortie d'un softmax avec entropie croisée, et avec un autre coût le point de départ change, la proposition avec lui.
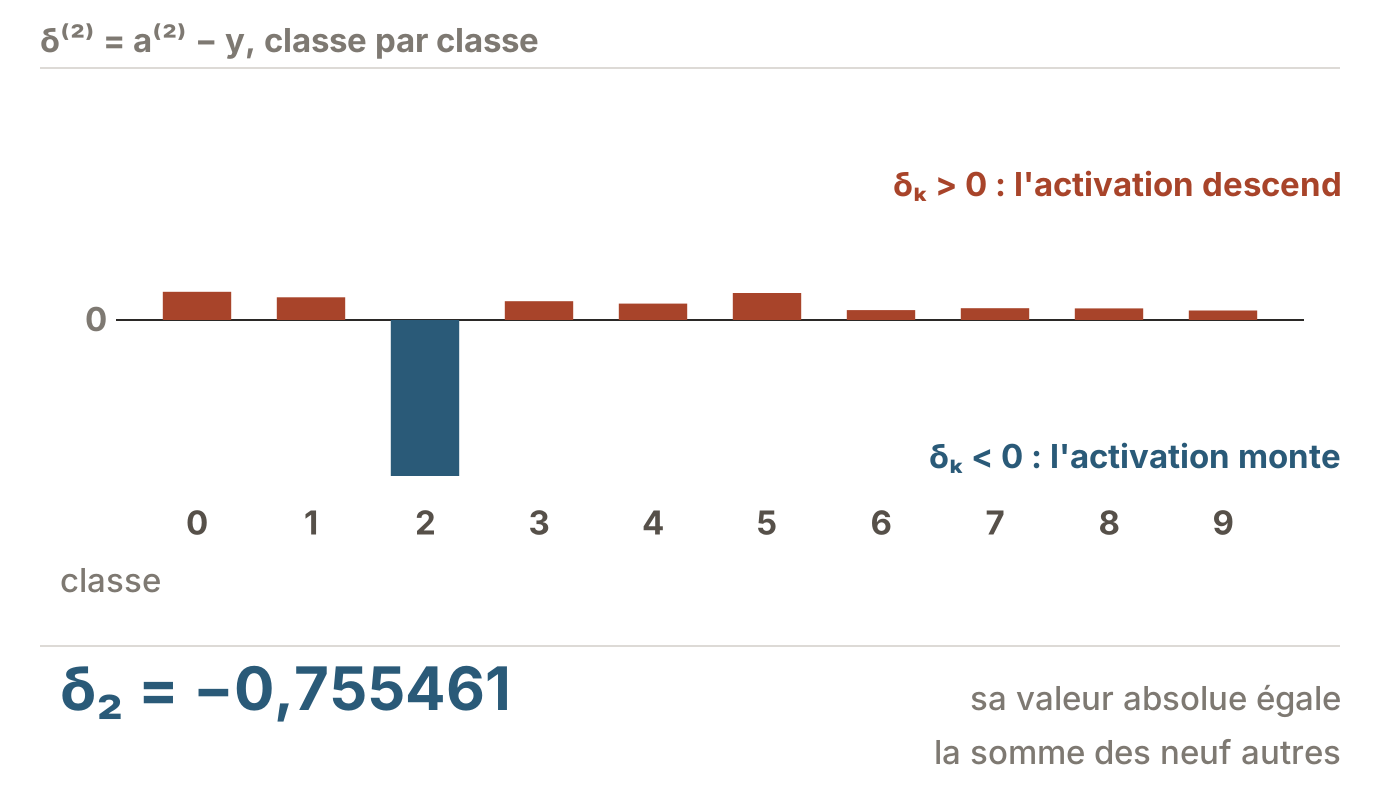
Le réseau pâlit et passe au second plan. Une ligne horizontale se trace au travers de l'écran, et dix barres verticales poussent depuis cette ligne, une par neurone de sortie. Neuf montent, très courtes, d'inégales longueurs ; la troisième descend, et elle descend jusqu'au bas du cadre, incomparablement plus longue que les neuf autres. Sa valeur s'inscrit à son extrémité : moins zéro virgule sept cinq cinq cinq. Les neuf barres courtes passent ensuite au brique et se déplacent l'une après l'autre au-dessus de la troisième, où elles s'empilent bout à bout en une seule colonne qui monte à mesure. Quand la neuvième se pose, un trait de brique marque le sommet de la pile, un second marque le bas de la barre descendante, et les deux sont à la même distance de la ligne. La valeur de la pile s'inscrit : plus zéro virgule sept cinq cinq cinq.
La somme est nulle, et la vraie classe pèse autant que les neuf autres
Hypothèses
Les hypothèses de la proposition 1.
et .
Propriétés utilisées
Linéarité de la somme
Proposition 1 : pour , donc
Étapes
Les deux vecteurs sont des lois de probabilité sur dix classes : leurs coordonnées somment à un.
On isole la composante de la vraie classe. De on tire .
Par la proposition 1, donc , et donc pour .
Résultat
Interprétation
La correction portée sur le neurone de la vraie classe pèse exactement autant que les neuf autres réunies, et : plus le réseau se trompe, plus est petit, plus cette correction est grande. C'est le sens précis qu'il faut donner à l'idée que les corrections sont proportionnelles à l'écart, où la proportionnalité porte sur et non sur une notion vague de distance.
Ce que ce résultat ne dit pas
L'égalité porte sur les valeurs absolues, donc sur des tailles. Elle ne dit pas que la correction du neurone produit sur la perte autant d'effet que celle des neuf autres.
La proposition 2 sur les nombres mesurés · cours/lecon4/mesures.py, mesure 1
  -- Contrôle de la proposition 2 sur ces nombres --------------------------
  somme des dix composantes       +8.327e-17
  |delta_2|                       0.755461
  somme des neuf autres           0.755461
  écart entre les deux            1.110e-16
Lecture
La somme des dix composantes vaut , c'est-à-dire zéro à la précision machine, l'erreur d'arrondi d'une somme de dix flottants.
et la somme des neuf autres vaut à près, donc l'égalité de la proposition 2 est vérifiée jusqu'au dernier chiffre représentable.
, qui est la lecture directe de la formule.
Les dix composantes de sont données par la mesure 1 : , , , , , , , , , .
- a
Vérifier à la main que leur somme est nulle, et que égale la somme des neuf autres, à l'arrondi de l'affichage près.
- b
Que vaudrait si le réseau accordait à la classe ?
- c
Vers quelle valeur tend-il quand s'approche de , et la proposition 1 permet-elle de l'atteindre ?
Aucune réponse à cliquer : il y a un calcul à faire.