Descendre, en dimension quelconque
Le gradient, le taux d'apprentissage, et l'algorithme de descente écrit en entier.
Sur une courbe, il n'y a que deux sens : la gauche et la droite. Dans un espace à cent mille dimensions, par où descend-on ?
En dimension , « la pente » est un nombre. En dimension , un point a autant de directions de départ qu'on veut, et un seul nombre ne peut pas les décrire toutes : il faut l'objet qui remplace la dérivée quand a coordonnées.
Trois objets, définis avant d'être employés
- Dérivée partiellepartial derivative
Pour et , la dérivée en de la fonction d'une variable , obtenue en gelant les autres coordonnées. C'est un scalaire, et il y en a .
- Gradientgradient
Le vecteur colonne des dérivées partielles, de même dimension que . Il est défini quand est de classe sur un ouvert, c'est-à-dire quand ses dérivées partielles existent et sont continues.
- Dérivée directionnelledirectional derivative
Pour avec , la vitesse de variation de quand on part de dans la direction : . La dérivée partielle en est le cas .
Ce que le gradient a de particulier
Parmi toutes les directions unitaires de , et il y en a une infinité, une seule fait monter le plus vite, et c'est celle du gradient. Son opposée fait descendre le plus vite. C'est l'énoncé qui justifie tout le procédé, et ce chapitre ne le démontre pas.
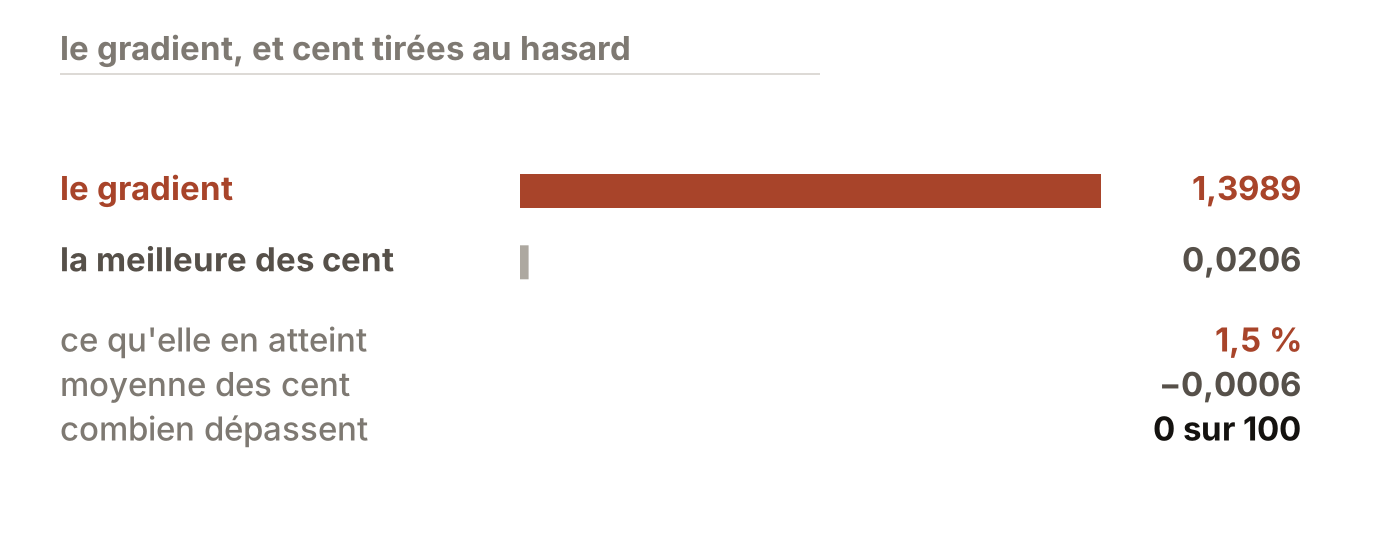
Admettre n'oblige pas à croire sur parole, car l'énoncé se vérifie : on tire cent directions au hasard, on ramène chacune à la longueur , ce qu'on appelle la normaliser et qui revient à diviser un vecteur par sa norme, puis on mesure pour chacune et on compare à celle du gradient lui-même normalisé. Si la proposition est vraie, aucune ne doit la dépasser.
La mesure se fait au point de départ de la graine 0, celui de la page 4, et sur un échantillon de images plutôt que sur les : chacune des cent une dérivées demande deux évaluations du coût, et le faire sur le jeu entier coûterait cent fois plus pour un résultat de même forme. La page 9 dira ce qu'un échantillon coûte en exactitude ; ici, il ne sert qu'à comparer cent une directions entre elles, toutes sur le même échantillon.
Cent directions au hasard · cours/lecon3/mesures.py, mesure 8
    C est le coût sur les 2048 exemples de la mesure 4.
    différence finie CENTRÉE, epsilon = 1e-05

    direction du gradient normalisé   D_u C = +1.39887154
    cent directions unitaires tirées au hasard :
      maximum                         +0.02064745
      minimum                         -0.01105809
      moyenne                         -0.00058565
      combien dépassent le gradient   0 sur 100
      rapport max/gradient            0.0148
Lecture
Aucune des cent ne dépasse le gradient, et ce n'est pas juste : la meilleure des cent atteint de sa valeur.
La moyenne des cent est quasiment nulle, et les valeurs se répartissent de part et d'autre de zéro : une direction tirée au hasard dans est presque orthogonale au gradient, donc elle ne fait ni monter ni descendre.
C'est un effet de la dimension, et il se retrouvera page 11 : dans un espace à cent mille dimensions, deux directions tirées indépendamment sont presque toujours presque orthogonales.
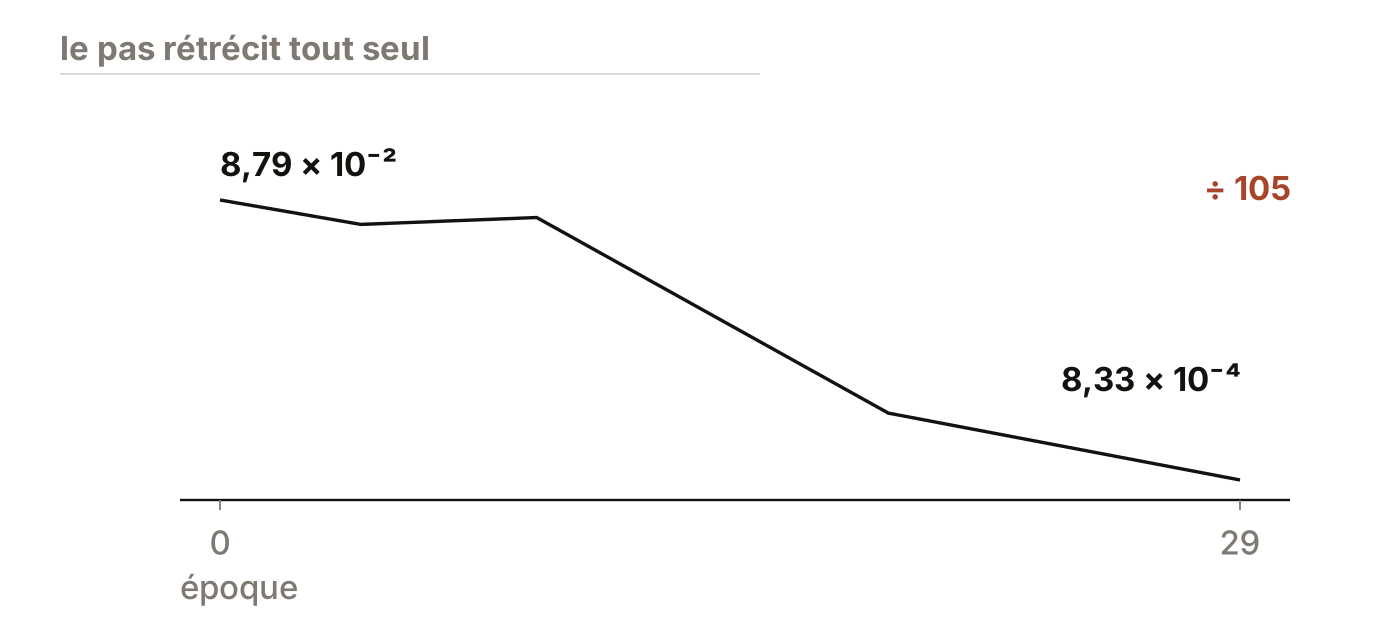
La longueur du gradient dit autre chose que sa direction : elle dit la raideur de la pente. Là où cette longueur est grande, une petite modification de change beaucoup le coût ; là où elle est petite, le coût est plat. Comme la mise à jour est proportionnelle au gradient, les pas rétrécissent d'eux-mêmes quand la pente s'aplatit, à constant. La table ci-dessous la suit sur trente époques, sur le jeu entier et sur un réseau qui apprend, et ses valeurs n'ont donc rien à voir avec le mesuré plus haut au point de départ sur images.
La norme du gradient pendant l'entraînement · cours/lecon3/mesures.py, mesure 7
    époque   L_train   acc_train    L_test   acc_test    ||grad||
         0    0.1055     0.9694    0.1195     0.9641    0.087878
         4    0.0329     0.9895    0.0743     0.9777    0.058533
         9    0.0130     0.9963    0.0743     0.9779    0.065720
        19    0.0011     1.0000    0.0729     0.9816    0.002535
        29    0.0006     1.0000    0.0761     0.9814    0.000833
Lecture
La norme du gradient est divisée par entre la première et la dernière époque mesurée. Le pas effectif, , rétrécit dans le même rapport alors que n'a pas bougé : c'est le mécanisme annoncé, mesuré.
La précision d'entraînement atteint à l'époque , donc le réseau ne se trompe plus sur aucune des images qu'il a vues. Le coût d'entraînement continue pourtant de baisser, parce qu'il reste de la confiance à gagner.
Le coût de test, lui, atteint son plus bas à l'époque , , puis remonte à . Le réseau continue de s'améliorer sur ce qu'il a vu et commence à se dégrader sur ce qu'il n'a pas vu. Ce chapitre le constate et n'en fait rien : c'est le sujet du chapitre d'évaluation.
L'algorithme, en entier
ENTREE D le jeu, fixe eta le taux d'apprentissage, dans R_{>0} T le nombre d'iterationsSORTIE theta un vecteur de R^p 1. theta <- tirage au hasard dans R^p2. pour t de 0 a T-1 :3. g <- grad_theta C_D(theta) un vecteur de R^p4. theta <- theta - eta * g p soustractions5. rendre thetaCinq lignes. La ligne est celle que ce chapitre ne sait pas exécuter efficacement, et la ligne est celle dont décide.
Le gradient a la dimension de ce qu'il dérive.
- a
Quelle est la dimension de pour le réseau ?
- b
Et pour ?
- c
La dimension du gradient dépend-elle du nombre d'images du jeu ? Justifier à partir de .
Aucune réponse à cliquer : il y a un calcul à faire.
Le taux d'apprentissage
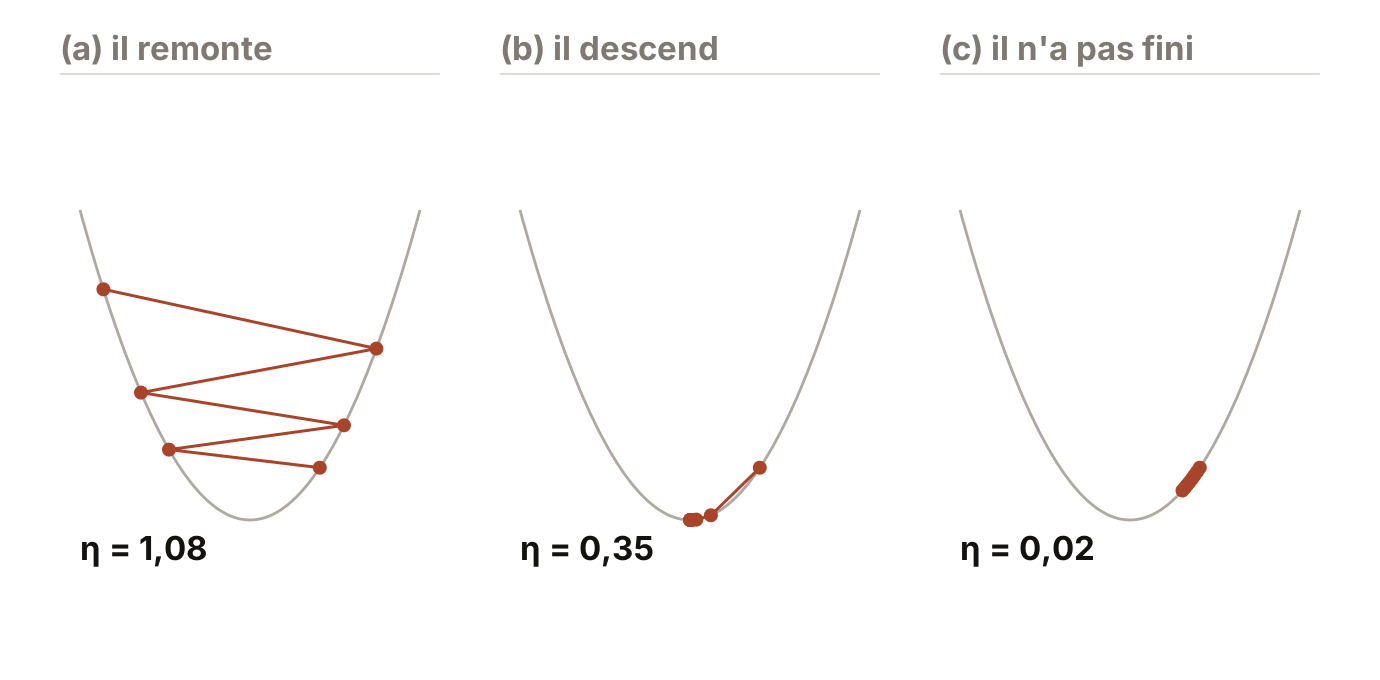
est le taux d'apprentissage : la longueur dont on recule à chaque pas, une fois la direction choisie. C'est le que le chapitre 1 appelait le pas d'apprentissage, et le seul nombre de tout le procédé qu'un humain fixe encore à la main.
La proposition 2 de la page 7 garantit que le coût baisse pour assez petit, sans dire ce que « assez petit » veut dire. Elle a été écrite en dimension un, et elle vaut mot pour mot en dimension : il suffit de remplacer par , et le développement au premier ordre d'une variable par celui de plusieurs, c'est-à-dire par le premier des deux outils que la proposition 3 emprunte au cours d'optimisation. On ne peut donc pas davantage prédire le bon réglage en dimension : on le cherche, sur sept valeurs, cinq époques chacune, à graine égale.
Sept taux d'apprentissage, 5 époques · cours/lecon3/mesures.py, mesure 3
         eta      L_test    acc_test
       10.000      2.4654    0.0892
        3.000      2.3246    0.1009
        1.000      0.1128    0.9709
        0.500      0.0743    0.9777
        0.100      0.1094    0.9677
        0.010      0.2731    0.9217
        0.001      0.6331    0.8523
Lecture
Trois régimes. Au-dessus de , le réseau reste au niveau du hasard, et , à comparer au seuil de du chapitre 2. Les pas sont si grands qu'ils ne descendent rien : chacun traverse la vallée et remonte plus haut de l'autre côté.
Entre et , le réseau apprend vite, et le meilleur réglage est avec en cinq époques.
En dessous de , il apprend mais n'a pas fini : à , ce qui n'est pas une divergence, c'est une lenteur.
et sont tous deux mauvais pour des raisons opposées. Le premier ne converge pas, le second n'a pas eu le temps. Confondre les deux échecs conduirait à corriger dans le mauvais sens.
La même courbe à deux vallons occupe l'écran, avec ses deux axes nommés. Un point plein de brique se pose sur la pente de gauche, exactement là où la bille avait été lâchée. Un segment de droite vient s'appuyer contre la courbe sous le point, dans le sens de la pente, puis s'efface, et le point saute vers la droite d'une longueur nette. La même chose recommence : une tangente, un saut. Les sauts sont d'abord longs, là où la courbe est raide, puis de plus en plus courts à mesure que la pente s'aplatit, et le point finit par ne plus bouger du tout. Il s'est arrêté au fond du PREMIER vallon, celui que la bille avait traversé sans s'y arrêter, et un trait pointillé descend de lui jusqu'à l'axe pour le marquer. Le second vallon, plus profond, est resté là-bas, intact. Le point se reporte alors sur la paroi de ce second vallon et recommence avec des sauts beaucoup plus longs : cette fois il enjambe le fond au lieu de l'atteindre, se retrouve sur la pente d'en face, repart dans l'autre sens et l'enjambe encore. Cinq sauts durant, il passe d'une paroi à l'autre sans jamais toucher le creux qu'il traverse, et il finit plus haut qu'il n'était parti.
Le taux et le taux donnent tous deux un mauvais résultat.
- a
Les deux échecs sont-ils de même nature ? Répondre à partir des deux colonnes de la table.
- b
Que se passerait-il si l'on entraînait dix fois plus longtemps avec ? Et avec ?
- c
Le seuil de bascule est entre et . Ce seuil est-il une propriété de la descente de gradient, ou de cette fonction-là ?
Aucune réponse à cliquer : il y a un calcul à faire.
Comment on obtient ce vecteur, et pourquoi ce n'est pas comme ça
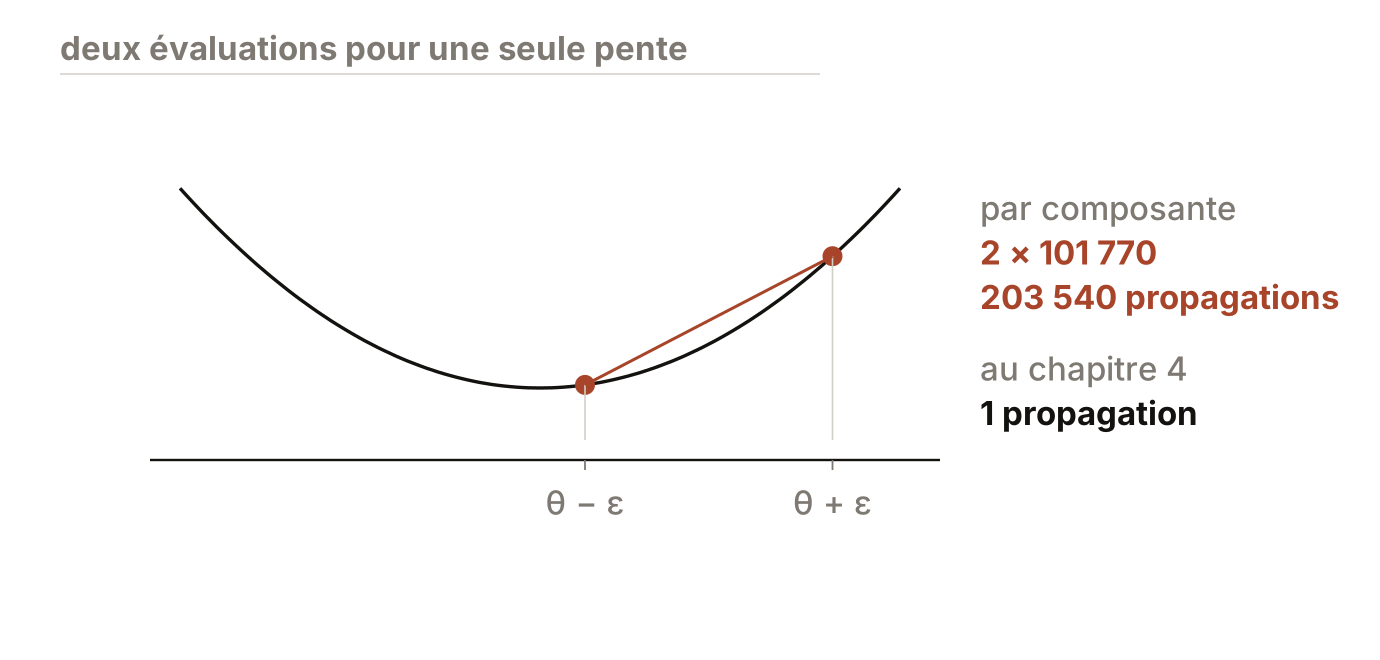
La ligne de l'algorithme demande dérivées partielles. Il existe un procédé qui les donne toutes, qui ne demande que des propagations avant, et qui ne suppose rien sur la forme de : remplacer la limite de par un quotient à fini.
- Différence finie centréecentral finite difference
L'approximation , pour petit. Centrée parce qu'elle évalue de part et d'autre du point ; l'erreur y est en au lieu de pour la version décentrée.
Ce que coûte un gradient par différences finies · cours/lecon3/mesures.py, mesure 9
    une propagation avant sur 2048 exemples     26.3 ms
    UNE composante par différence centrée      50.2 ms   (2 propagations)
    p                                          101770 composantes
    propagations avant pour UN gradient        203540
    temps estimé pour UN gradient             5113 s, soit 1.42 h
    l'algorithme du chapitre 4 en demande      1 propagation avant
    rapport                                    203 540

    Un entraînement de 30 époques compte 28 140 mises à jour.
    Par différences finies, il demanderait     5 années de calcul.
Lecture
Un seul gradient demande propagations avant, soit une heure et demie sur ce poste, pour un pas parmi . Ces pas ne sont pas ceux de l'algorithme écrit plus haut, qui n'en ferait que trente en trente époques : ce sont ceux de l'entraînement réel, qui découpe chaque époque en lots de images et fait donc pas par époque. La page 9 dit pourquoi.
L'entraînement complet demanderait environ cinq années de calcul, quand le même entraînement avec l'algorithme du chapitre 4 prend une minute.
Le procédé n'est pas faux, puisque c'est celui qui a produit toutes les vérifications de ce chapitre. Il est correct et inutilisable, et c'est une distinction qu'il faut savoir faire.