Descendre, en dimension un
Comment faire baisser une courbe quand on ne sait pas où se trouve son minimum.
Un marcheur dans le brouillard ne voit que la pente sous ses pieds. Cela suffit-il pour descendre ?
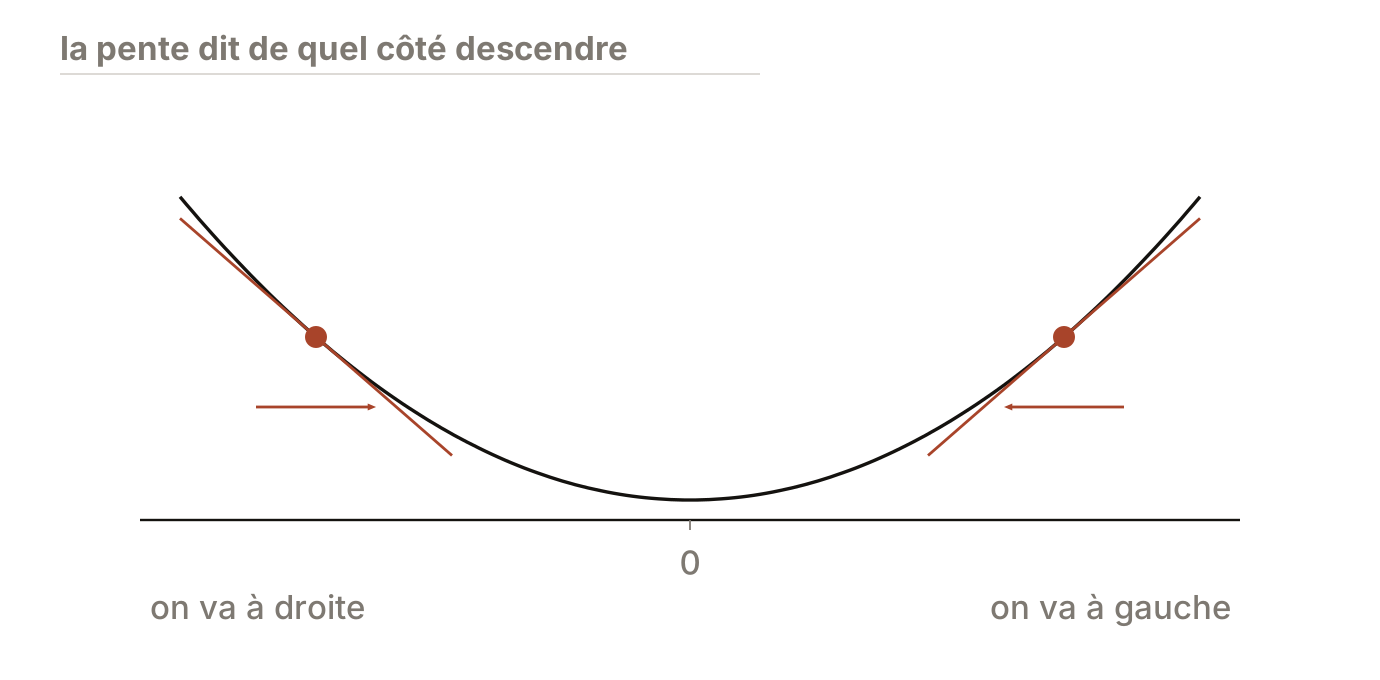
Il faut donc une règle qui dise, à partir de seule, lequel des nombres changer, dans quel sens et de combien.
Personne ne se représente . Tout ce qui suit se voit en dimension , où est une courbe et un point sur un axe, et rien de ce qui sera dit en dimension ne devra être révisé : la page 8 remplacera un nombre par un vecteur, et c'est tout.
Pourquoi ne pas résoudre ?
C'est la méthode qu'on apprend d'abord, et elle marche quand elle marche : sur on écrit , on résout , on trouve , et comme c'est bien un minimum, le tout en deux lignes et sans approximation.
Ici, la même méthode demanderait de résoudre un système de équations à inconnues, non linéaires puisque et y sont, et couplées, chaque équation portant sur tous les paramètres à la fois. Aucune méthode générale ne résout un tel système, et il ne s'agit pas d'un problème de puissance de calcul : on ne sait pas l'écrire sous une forme qui se résolve.
- Fonction convexeconvex function
Une fonction , définie sur une partie convexe , telle que pour tous et tout , . Autrement dit, la corde reste au-dessus de la courbe.
Pourquoi on ne minimise pas ce qu'on veut vraiment
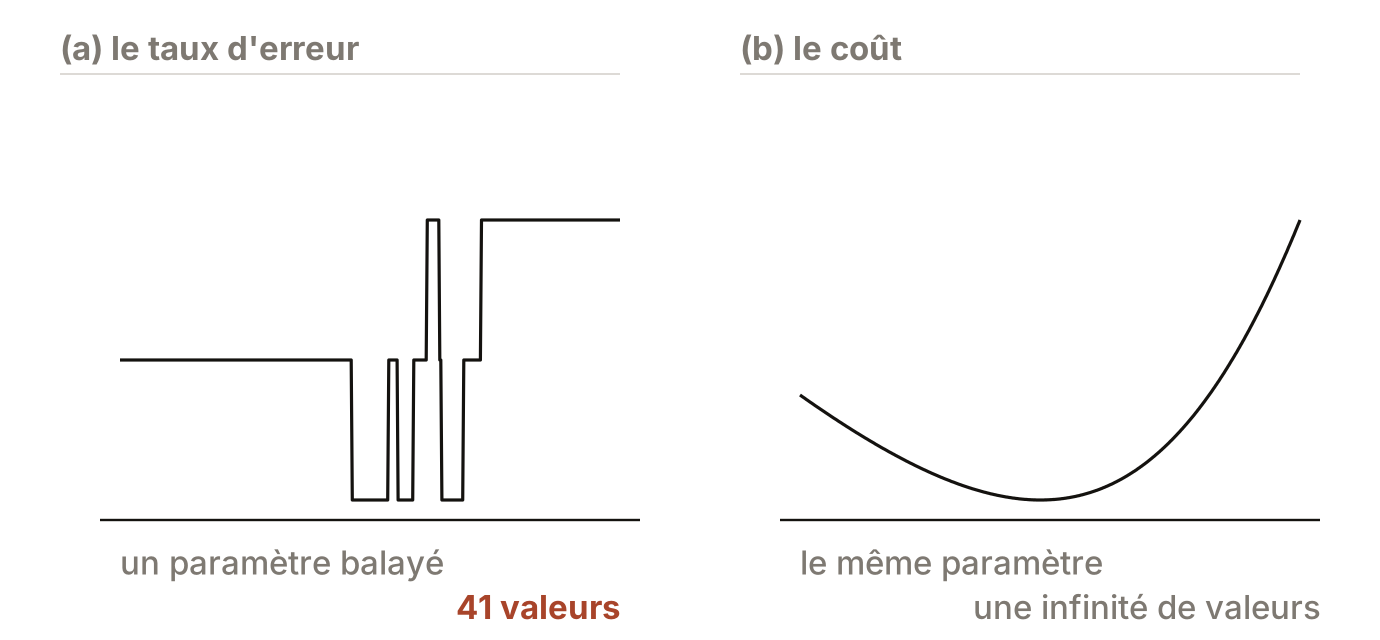
Ce qu'on veut, c'est que le réseau se trompe rarement, autrement dit minimiser le taux d'erreur. Ce n'est pas ce qu'on minimise, et la raison n'est pas un renoncement pratique : c'est une impossibilité, et elle se démontre.
Hypothèses
est le taux d'erreur sur : la proportion des images que le réseau classe mal. est la règle de décision du chapitre 2, qui rend l'indice de la plus grande coordonnée.
est fixé, et un seul paramètre varie, noté . Les autres sont gelés, si bien que est une fonction d'une variable réelle.
Propriétés utilisées
Une somme de indicatrices est un entier de
Définition de la continuité en un point
Une fonction dérivable en un point y est continue
Étapes
ne prend qu'un nombre fini de valeurs. La somme des indicatrices est un entier , donc , un ensemble à éléments. Deux valeurs distinctes y diffèrent d'au moins .
Soit un point où est continue, c'est-à-dire un point pris sur un palier de l'escalier. Prenons , deux fois plus petit que l'écart minimal entre deux valeurs possibles. Par continuité, il existe un intervalle autour de sur lequel , et comme un écart non nul vaudrait au moins , cet écart est nul : est constante sur .
Définition de la continuité, appliquée à un choisi plus petit que le pas de la grille des valeurs. C'est le seul endroit où la finitude sert.
Pour assez petit, reste dans , où est constante : le numérateur est nul, donc le quotient aussi.
Restent les sauts de l'escalier, c'est-à-dire les points où une image au moins bascule d'une classe à l'autre. En ces points, n'est pas définie du tout : la bascule est le moment où deux coordonnées de la sortie sont ex æquo, et le chapitre 2 a laissé indéfinie sur les ex æquo. De part et d'autre, prend deux valeurs distinctes, donc elle n'y est ni continue ni dérivable. Il n'y a donc aucun point où soit à la fois définie et non nulle.
n'est pas définie sur les ex æquo, chapitre 2. Ailleurs, la contraposée du fait que la dérivabilité entraîne la continuité suffit.
Résultat
Interprétation
La mise à jour ne bouge jamais. Aucune descente ne peut minimiser un taux d'erreur, et l'argument ne doit rien à la dimension un : il vaudra coordonnée par coordonnée quand en aura , ce que la page 8 redira une fois l'objet qui les rassemble défini. On minimise donc , qui n'est pas ce qu'on veut, en espérant que la faire baisser fasse baisser , et la mesure de la page 8 montre que c'est bien ce qui se passe, sans que rien ne le garantisse.
Ce que ce résultat ne dit pas
C'est ici que se justifie une décision du chapitre 2. Un neurone dont l'activation serait binaire produirait une sortie à valeurs dans un ensemble fini, donc un coût à valeurs dans un ensemble fini, et la démonstration ci-dessus s'appliquerait à lui aussi : le procédé entier s'effondrerait. Les activations varient continûment pour que le coût soit lisse, et pour aucune autre raison.
La proposition ne dit pas que est inutile : reste la quantité qu'on rapporte. Elle dit qu'on ne peut pas la minimiser directement.
Le comptage précède la dérivation.
- a
Montrer que le taux d'erreur d'un réseau sur images ne peut prendre que valeurs.
- b
En déduire que sa dérivée est nulle là où elle existe.
- c
Cette conclusion dépend-elle de ? Que se passerait-il pour ?
Aucune réponse à cliquer : il y a un calcul à faire.
La règle, et son signe moins
La figure du début donne le sens du déplacement, et il reste à écrire la règle qui s'en sert. Le chapitre 1 en avait nommé les deux ingrédients sans les assembler : le pas , qu'il appelait la longueur d'un déplacement, et le compteur , qu'il appelait le numéro d'itération de la descente.
Hypothèses
est dérivable, et sa dérivée est continue ; on dit qu'elle est de classe .
, et , la règle .
: au point de départ, la pente n'est pas nulle.
Propriétés utilisées
Développement au premier ordre :
Définition du sens de variation par le signe de la dérivée
Étapes
L'analyse par cas d'abord, qui donne le sens du déplacement. Si , alors donc : on va vers la gauche, du côté où décroît. Si , alors : on va vers la droite, du côté où décroît. Le cas est écarté par hypothèse, et la suite y serait de toute façon stationnaire.
Le calcul donne ensuite l'ampleur. On pose et on développe :
Développement au premier ordre, puis substitution de . Le passage de à tient à ce que et sont proportionnels : avec fixé et non nul, donc une quantité négligeable devant l'est aussi devant . Le terme dominant porte le carré de la dérivée, donc il est négatif quel que soit le signe de .
Le seuil se construit alors. Notons le terme négligeable, de sorte que la différence vaut . Dire que , c'est dire que tend vers , donc qu'il existe tel que pour tout de . La différence est alors majorée par , strictement négative.
Définition de , appliquée au seuil , qui est un nombre strictement positif puisque .
Résultat
Interprétation
Le signe moins n'est ni une convention ni une image : c'est le seul signe qui rende le terme dominant négatif dans les deux cas de figure, parce qu'il fait apparaître un carré. Un signe plus donnerait , positif, et ferait monter le coût aussi sûrement.
Ce que ce résultat ne dit pas
Elle ne donne aucun seuil utilisable. L'énoncé affirme qu'un existe, et la démonstration le construit à partir du reste , qu'on ne sait majorer qu'en connaissant au point . Ce seuil change donc à chaque pas.
Elle ne dit rien non plus de ce qui arrive pour : le coût peut monter, ou osciller, ou diverger.
Le seuil exact relève du chapitre d'optimisation. C'est pourquoi la page 8 procède par mesure et non par théorème.
La règle se met à l'épreuve sur la plus simple des cuvettes, , en partant de .
- a
Écrire la mise à jour sous la forme , et donner en fonction de .
- b
Pour puis , calculer les quatre premiers termes et dire laquelle des deux suites converge.
- c
Pour quelles valeurs de la suite converge-t-elle ? Comparer ce seuil à ce que la proposition 2 permettait d'affirmer.
Aucune réponse à cliquer : il y a un calcul à faire.
L'image de la bille, et où elle trompe
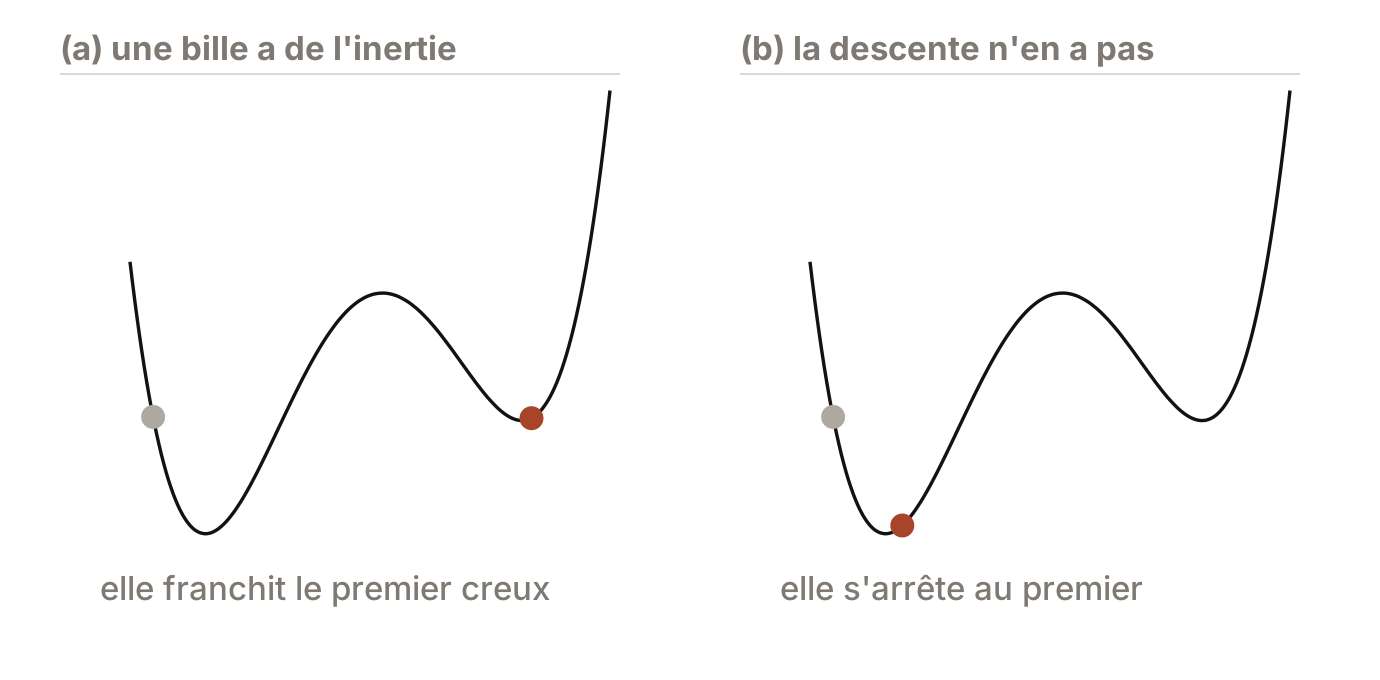
On se représente volontiers la descente comme une bille lâchée sur une surface : elle roule vers le bas, elle finit au fond d'un creux. L'image est utile, parce qu'elle donne le bon geste et fait comprendre qu'il puisse y avoir plusieurs creux, et elle est fausse sur trois points qu'il vaut mieux savoir.
| Une bille | La descente |
|---|---|
A une inertie : elle dépasse le fond, remonte de l'autre côté, oscille avant de s'arrêter | N'en a aucune : chaque pas ne dépend que du point courant, et jamais du pas précédent. Elle peut dépasser, mais seulement si est trop grand, jamais par élan |
Peut franchir une bosse et sortir d'un creux peu profond | Ne le peut pas : arrivée en un point où , elle est immobile pour toujours. C'est exactement ce que la perte non convexe coûte, annoncé plus haut |
Roule dans un paysage qu'on voit, avec un haut et un bas | Se déplace dans , où il n'y a rien à voir : la section suivante dit à partir de quand |
Un repère se dessine, occupant presque tout l'écran ; l'axe horizontal porte le nom « un paramètre » à son extrémité droite, l'axe vertical le nom « le coût » en haut. Une courbe épaisse se trace alors de gauche à droite : elle descend depuis le haut de l'écran, creuse un premier vallon peu profond au tiers gauche, remonte en une bosse arrondie au milieu, creuse un second vallon nettement plus profond aux deux tiers, puis remonte vers la droite. Un cercle vide au trait de brique, de la taille d'une petite bille, vient se poser sur la pente de gauche, exactement tangent au tracé. Il se met à rouler : il descend, accélère, et au lieu de s'arrêter dans le premier vallon il le traverse en pleine vitesse, franchit la bosse du milieu et remonte haut sur la pente qui suit le second vallon. Il redescend, repasse le fond, remonte un peu de l'autre côté, et ses allers et retours se font de plus en plus courts jusqu'à ce qu'il s'immobilise au fond du second vallon, le plus profond. Un trait pointillé descend alors de la bille jusqu'à l'axe horizontal, pour marquer où elle s'est arrêtée : pas là où elle est passée la première fois.
Ce qui change quand il y a deux variables
Le passage à deux variables se voit encore, et c'est le dernier qui se voie. Avec le domaine n'est plus un axe mais un plan, et n'est plus une courbe au-dessus d'un axe mais une surface au-dessus de ce plan : à chaque point du plan correspond une altitude. Descendre veut alors dire choisir une direction dans le plan, et il y en a une infinité au lieu de deux.
À trois variables la représentation cesse, puisqu'il faudrait une quatrième dimension pour porter l'altitude. C'est pourquoi la page 8 remplace le dessin par un calcul, et non parce que le calcul serait plus rigoureux.