• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
11/59
Lecture10 min

Synthèse, formulaire et erreurs fréquentes

Tout le chapitre en une page : le formulaire, le tableau des objets, les erreurs fréquentes.

Onze pages plus tôt, une machine lisait un chiffre manuscrit sans que personne sache dire comment.

Voici tout ce qu'il a fallu pour écrire ce qu'elle fait, et le trajet qui les relie.
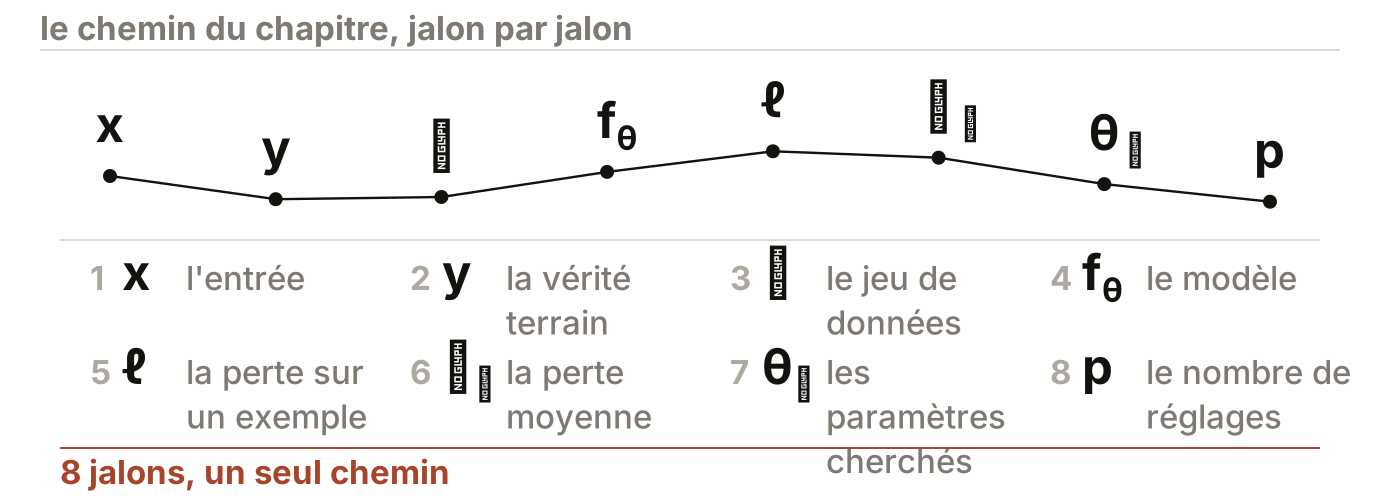
Un chemin légèrement ondulé traverse l'image, portant les bornes d'encre du chapitre. Au-dessus de chacune, le symbole défini à ce jalon : x, y, le jeu de données D, f indice thêta, la perte ell, la perte moyenne grand L indice D, et p. Sous un filet, les jalons sont repris en deux rangées, numérotés, chacun avec son symbole et ce qu'il désigne : l'entrée, la vérité terrain, le jeu de données, le modèle, la perte sur un exemple, la perte moyenne, le nombre de réglages. Sous un filet de brique, une dernière ligne : un seul chemin, et le chapitre tient là.
Un seul chemin, et chaque borne porte ce qu'on y a appris.

Formulaire

D={(x(n), y(n))}n=1N\mathcal{D}=\big\{(\mathbf{x}^{(n)},\,y^{(n)})\big\}_{n=1}^{N}D={(x(n),y(n))}n=1N​
(1)
Le jeu de données : NNN couples, chacun une entrée et la vérité observée qui va avec.
y^=fθ(x)\widehat{y}=f_{\boldsymbol{\theta}}(\mathbf{x})y​=fθ​(x)
(2)
Le modèle : une fonction indexée par ses paramètres. Changer θ\boldsymbol{\theta}θ ne change pas la forme du modèle, cela change la fonction qu'il réalise.
z=wTx+b=∑i=1dwixi+b,y^=zz=\mathbf{w}^{\mathsf{T}}\mathbf{x}+b=\sum_{i=1}^{d}w_i x_i+b, \qquad \widehat{y}=zz=wTx+b=i=1∑d​wi​xi​+b,y​=z
(3)
Le modèle linéaire, le plus simple qui ne soit pas trivial. En régression, rien ne s'intercale entre la somme pondérée et la prédiction : y^\widehat{y}y​ est zzz.
ℓ(y^,y)=(y^−y)2\ell(\widehat{y},y)=(\widehat{y}-y)^{2}ℓ(y​,y)=(y​−y)2
(4)
La perte sur un exemple. Le carré est positif quel que soit le sens de l'erreur, et il pénalise davantage les grands écarts que les petits.
LD(θ)=1N∑n=1N(fθ(x(n))−y(n))2\mathcal{L}_{\mathcal{D}}(\boldsymbol{\theta})=\frac{1}{N}\sum_{n=1}^{N}\Big(f_{\boldsymbol{\theta}}\big(\mathbf{x}^{(n)}\big)-y^{(n)}\Big)^{2}LD​(θ)=N1​n=1∑N​(fθ​(x(n))−y(n))2
(5)
La moyenne des NNN pertes individuelles, et à gauche du signe égal une seule variable : θ\boldsymbol{\theta}θ.

Les conventions d'écriture

Le vecteur colonne, et la transposée

Un vecteur de Rd\mathbb{R}^{d}Rd est toujours une colonne de ddd réels. Une colonne prend de la place au fil d'une phrase : on l'y couche en écrivant x=(x1,x2)T\mathbf{x} = (x_1, x_2)^{\mathsf{T}}x=(x1​,x2​)T, et le T\mathsf{T}T dit qu'il faut la relever. C'est la même convention qui fait écrire le produit wTx\mathbf{w}^{\mathsf{T}}\mathbf{x}wTx : une ligne multipliée par une colonne donne un nombre.

Préactivationpre-activation

Le nombre z=wTx+bz = \mathbf{w}^{\mathsf{T}}\mathbf{x} + bz=wTx+b, pris avant toute transformation ultérieure. Dans ce chapitre, l'estimation vaut y^=z\widehat{y} = zy​=z ; le préfixe n'a donc pas encore d'utilité. Il en prend une au chapitre 2, où une fonction s'insère entre zzz et ce que le modèle rend vraiment.

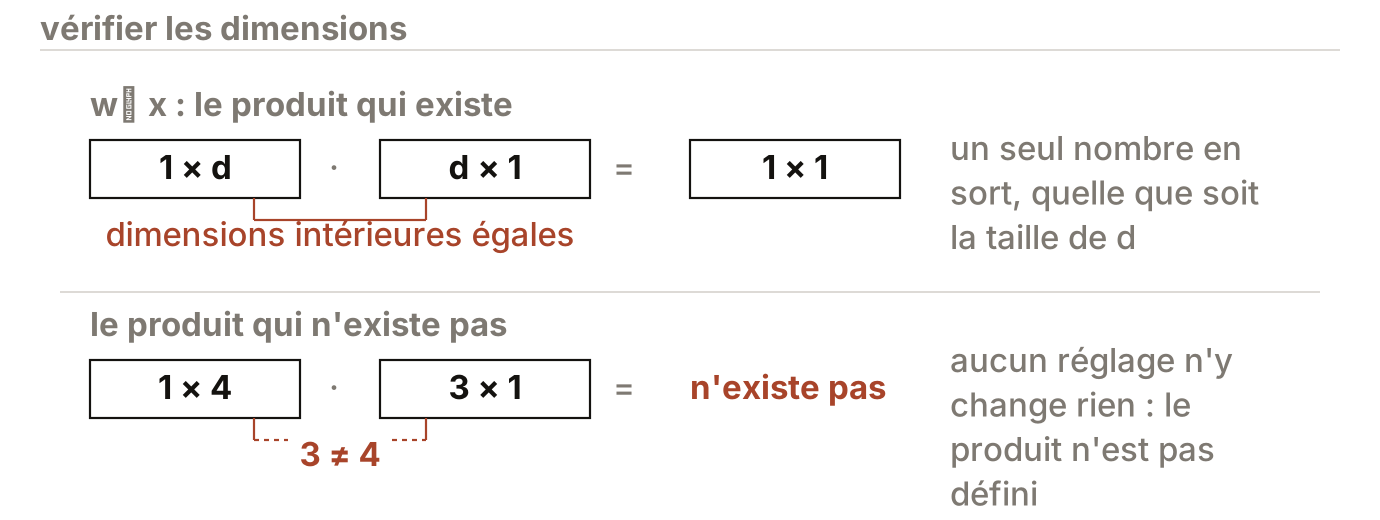
wT⏟1×d x⏟d×1  =  z⏟1×1,(1×d)⋅(d×1)=1×1\underbrace{\mathbf{w}^{\mathsf{T}}}_{1\times d}\ \underbrace{\mathbf{x}}_{d\times 1} \;=\; \underbrace{z}_{1\times 1}, \qquad (1\times d)\cdot(d\times 1) = 1\times 11×dwT​​ d×1x​​=1×1z​​,(1×d)⋅(d×1)=1×1
Les deux dimensions intérieures doivent coïncider, sinon le produit n'existe pas. (1×4)⋅(3×1)(1\times 4)\cdot(3\times 1)(1×4)⋅(3×1) ne s'écrit pas : 4≠34 \neq 34=3.
En haut, une ligne de quatre cases représente le vecteur de poids transposé, une colonne de quatre cases représente le vecteur d'entrée, et une case unique, en brique, représente le résultat. Sous elles, l'égalité des dimensions : un fois quatre, point, quatre fois un, égale un fois un ; les deux quatre intérieurs sont en brique et reliés par un trait. En bas, le cas qui échoue : un fois quatre, point, trois fois un ; le quatre et le trois sont en brique, le trait de liaison se tend entre eux sans se refermer, et dessous s'inscrit quatre différent de trois.
On vérifie les dimensions avant de multiplier, pas après.

$\mathcal{Y}$ et $\widehat{\mathcal{Y}}$ ne sont pas le même ensemble

Y\mathcal{Y}Y est l'ensemble où vivent les vérités terrain ; Y^\widehat{\mathcal{Y}}Y​ est celui où vivent les estimations du modèle. En régression, les deux valent R\mathbb{R}R et la distinction ne se voit pas. En classification, Y\mathcal{Y}Y est fini — dix chiffres, deux réponses — tandis que le modèle rend un nombre entre 000 et 111 : les deux ensembles diffèrent, et confondre leurs éléments est l'erreur la plus coûteuse du domaine.

Trois notations qui se ressemblent et ne disent pas la même chose

ÉcritureCe qu'elle désigneCe qu'elle n'est pas

x(n)x^{(n)}x(n)

Le nnn-ième exemple du jeu de données

Une puissance

xix_{i}xi​

La iii-ième composante d'un vecteur

Un exemple

W[l]W^{[l]}W[l]

La couche lll d'un réseau, à partir du chapitre 2

Ni une puissance, ni un numéro d'exemple

Les trois cohabitent dans une même formule dès le chapitre 2. Parenthèses, indice bas et crochets sont trois marques distinctes, jamais interchangeables.
Représentationrepresentation, feature vector

Le vecteur x\mathbf{x}x par lequel on remplace l'objet réel. Choisir une représentation, c'est décider ce que le modèle aura le droit de voir : l'agence qui retient la surface et le nombre de pièces, et rien d'autre, a déjà décidé que l'étage ne compte pas.

Le tableau des objets

Les seize symboles de ce chapitre

SymboleSignificationEnsembleDimension

x\mathbf{x}x

l'entrée : un exemple, décrit par ses caractéristiques

X⊆Rd\mathcal{X}\subseteq\mathbb{R}^{d}X⊆Rd

d×1d\times1d×1, soit d=2d=2d=2 dans le fil conducteur

xix_ixi​

la iii-ème caractéristique de cette entrée

R\mathbb{R}R

scalaire, iii allant de 111 à ddd

yyy

la vérité terrain : ce qui a été observé dans le monde

Y\mathcal{Y}Y

un nombre en régression, une étiquette en classification

y^\widehat{y}y​

la prédiction : ce que le modèle croit

Y\mathcal{Y}Y, ou R\mathbb{R}R avant décision

même forme que yyy, et jamais confondue avec lui

D\mathcal{D}D

le jeu de données : les couples entrée / vérité

partie de X×Y\mathcal{X}\times\mathcal{Y}X×Y

NNN couples

NNN

le nombre d'exemples du jeu

N∗\mathbb{N}^{*}N∗

scalaire, N=2N=2N=2 dans le fil conducteur

nnn

l'indice d'un exemple, écrit en exposant entre parenthèses

{1,…,N}\{1,\dots,N\}{1,…,N}

scalaire ; x(n)\mathbf{x}^{(n)}x(n) n'est pas une puissance

w\mathbf{w}w

les poids : un par caractéristique d'entrée

Rd\mathbb{R}^{d}Rd

d×1d\times1d×1

bbb

le biais : le décalage, sans lequel le modèle passe par l'origine

R\mathbb{R}R

scalaire

zzz

la préactivation : la somme pondérée wTx+b\mathbf{w}^{\mathsf{T}}\mathbf{x}+bwTx+b

R\mathbb{R}R

scalaire

θ\boldsymbol{\theta}θ

les paramètres, tous réunis : ici le couple (w,b)(\mathbf{w},b)(w,b)

Rp\mathbb{R}^{p}Rp

p=d+1p=d+1p=d+1, soit 333 dans le fil conducteur

ℓ\ellℓ

la perte sur un exemple

R≥0\mathbb{R}_{\ge0}R≥0​

scalaire

LD\mathcal{L}_{\mathcal{D}}LD​

la moyenne des ℓ\ellℓ sur D\mathcal{D}D : la fonction qu'on minimise

R≥0\mathbb{R}_{\ge0}R≥0​

scalaire, fonction de θ\boldsymbol{\theta}θ seul

η\etaη

le pas d'apprentissage : la longueur d'un déplacement

R>0\mathbb{R}_{>0}R>0​

scalaire, réglage et non paramètre appris

ttt

le numéro d'itération de la descente

N\mathbb{N}N

scalaire, un compteur

fθf_{\boldsymbol{\theta}}fθ​

le modèle : la fonction que θ\boldsymbol{\theta}θ choisit

applications de X\mathcal{X}X dans Y\mathcal{Y}Y

une fonction, pas un nombre

Le tableau à garder ouvert pendant le chapitre suivant : chacune de ces seize lignes y sera instanciée sur un cas réel.

Erreurs fréquentes

Ce qu'on croitCe qui est vrai

yyy et y^\widehat{y}y​, c'est la même chose à un chapeau près

yyy est la vérité observée dans le monde, y^\widehat{y}y​ la croyance du modèle. À l'inférence, on calcule y^\widehat{y}y​ précisément parce que yyy n'existe pas encore : l'appartement dont on estime le prix n'a pas été vendu.

LD\mathcal{L}_{\mathcal{D}}LD​ dépend de x\mathbf{x}x

D\mathcal{D}D est fixé une fois pour toutes : les x(n)\mathbf{x}^{(n)}x(n) et les y(n)y^{(n)}y(n) sont des constantes. La seule variable de LD\mathcal{L}_{\mathcal{D}}LD​ est θ\boldsymbol{\theta}θ, et c'est exactement ce qui permet de la minimiser en θ\boldsymbol{\theta}θ.

ℓ\ellℓ et L\mathcal{L}L, c'est la même perte

ℓ\ellℓ porte sur un exemple, LD\mathcal{L}_{\mathcal{D}}LD​ est la moyenne des NNN valeurs de ℓ\ellℓ. Avec θB\boldsymbol{\theta}_BθB​, les deux appartements donnent ℓ=56,25\ell=56{,}25ℓ=56,25 chacun, donc LD=56,25\mathcal{L}_{\mathcal{D}}=56{,}25LD​=56,25 : ici les deux nombres coïncident par accident, jamais par principe.

x(n)\mathbf{x}^{(n)}x(n), c'est x\mathbf{x}x à la puissance nnn

L'exposant entre parenthèses est un numéro d'exemple. x(2)\mathbf{x}^{(2)}x(2) est le deuxième appartement du jeu ; la puissance, elle, s'écrirait sans parenthèses, et l'indice désigne encore autre chose : x2x_2x2​ est la deuxième caractéristique d'une entrée.

une note très basse sur les exemples du fichier, donc un bon modèle

C'est la mémorisation qui est mesurée, pas l'apprentissage. Le but est de bien répondre sur des exemples jamais vus ; le seul verdict est la note obtenue sur des exemples que le modèle n'a jamais vus.

les classes sont codées 000, 111, 222, donc ce sont des nombres

La perte quadratique n'utilise de deux étiquettes que la différence de leurs codes, et ce que cette différence mesure n'est pas la question posée. Sur les dix chiffres manuscrits, confondre un 3 avec un 8 coûte 252525 et le confondre avec un 5 coûte 444 ; renumérotées dans l'ordre alphabétique de leurs noms, les mêmes classes donnent 252525 et 494949, et les deux erreurs ont échangé leur rang.

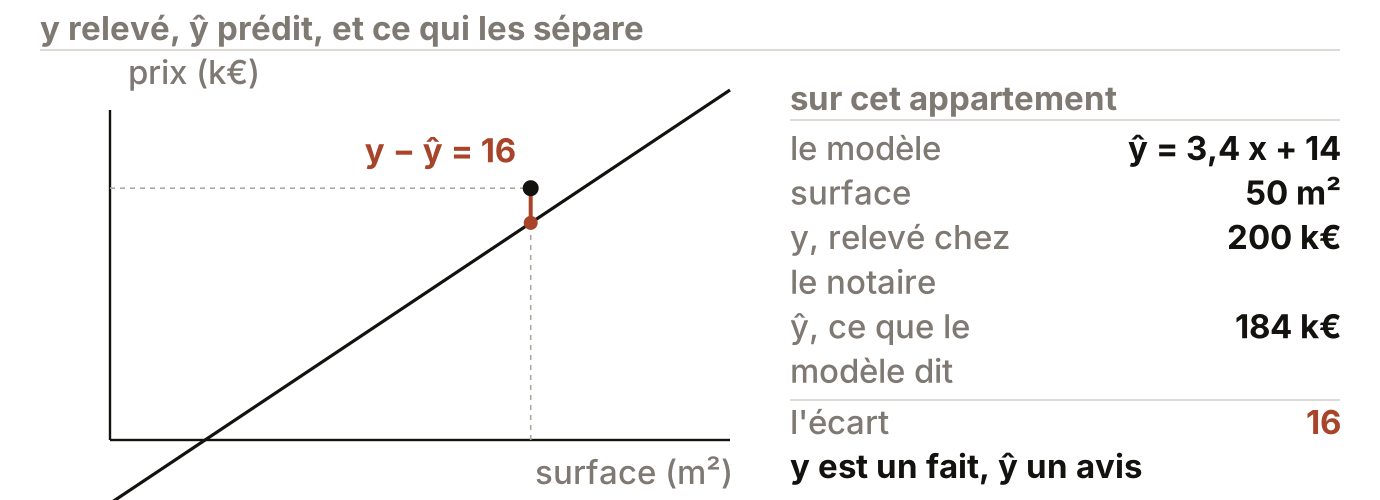
Un plan surface contre prix, traversé par une droite à l'encre. Deux traits gris en pointillé marquent la surface de cinquante mètres carrés et le prix de deux cents ; à leur croisement, un gros point à l'encre. Sous ce point, sur la même verticale, un point de brique marque ce que la droite prédit, et un segment de brique épais joint les deux, coté y moins y chapeau égale seize. À droite, un panneau donne le modèle, y chapeau égale trois virgule quatre x plus quatorze, la surface, cinquante mètres carrés, le prix relevé chez le notaire, deux cents milliers d'euros, ce que le modèle dit, cent quatre-vingt-quatre milliers d'euros, puis l'écart, seize, et une dernière ligne : y est un fait, y chapeau un avis.
Le point est relevé ; la droite n'est qu'un avis.
ExerciceQuestion de vérification15 min

1. Un calcul. On donne x=(2, −1)T\mathbf{x}=(2,\,-1)^{\mathsf{T}}x=(2,−1)T, w=(0,5, 1)T\mathbf{w}=(0{,}5,\,1)^{\mathsf{T}}w=(0,5,1)T, b=0,2b=0{,}2b=0,2, et la vérité terrain y=1,2y=1{,}2y=1,2. Calcule zzz, puis y^\widehat{y}y​, puis ℓ\ellℓ. Écris les trois lignes de calcul, pas seulement les trois résultats.

2. Une typologie. Pour chacun des quatre scénarios, donne la famille d'apprentissage, le type de tâche, et l'ensemble Y\mathcal{Y}Y lorsqu'il existe. (a) Prédire la température qu'il fera demain. (b) Décider si un courriel est indésirable ou non. (c) Reconnaître un vin parmi rouge, blanc et rosé. (d) Regrouper des clients qui se ressemblent, sans aucune étiquette.

3. Le compte des réglages. Un modèle linéaire reçoit ddd caractéristiques et rend un nombre. Combien de réglages contient-il ? Donne le compte pour d=2d=2d=2, puis pour une image de 28×2828\times 2828×28 pixels.

Suite du parcours

Quatre chapitres suivent celui-ci, et ils forment un arc. Aucun ne change de vocabulaire : ils emploient celui du tableau ci-dessus. Le fil conducteur, lui, change : les appartements ont fait leur travail, et c'est la reconnaissance des chiffres manuscrits qui prend la suite, pour la raison établie en section 2.4 — c'est le problème où l'on peut écarter des règles par la mesure au lieu d'en supposer l'absence.

ChapitreCe qu'il construitLa dette qu'il rembourse

2 · Qu'est-ce qu'un réseau de neurones

L'objet qui capte l'arrangement des pixels, et les 101 770 réglages comptés en section 10.2

Les fonctions d'activation σ\sigmaσ, et ce qu'un poids veut dire quand il y en a cent mille

3 · La descente de gradient, comment un réseau apprend

La dérivation pas à pas du gradient de LD\mathcal{L}_{\mathcal{D}}LD​, et la descente qui s'en sert

Comment on trouve les réglages sans les essayer un par un

4 · Ce que fait la rétropropagation

Ce que l'algorithme calcule, et pourquoi, avant toute formule

La vérification par la mesure, quand relire le calcul n'est plus possible

5 · Le calcul de la rétropropagation

La règle de dérivation en chaîne, appliquée couche par couche

Le calcul effectif, terme à terme

Deux questions restent ouvertes après ces quatre chapitres — d'où viennent vraiment les données, et pourquoi un modèle qui réussit sur son fichier peut échouer ailleurs. Elles gardent leur échéance, et elle n'est pas encore fixée.

D'où vient l'ordre de cet arc

Le parcours des chapitres 2 à 5 est inspiré de la série de Grant Sanderson sur les réseaux de neurones, publiée sous le nom 3Blue1Brown : c'est son ordre et ce sont ses notions. Le contenu, les démonstrations, les mesures et les animations de ce cours lui sont propres, et chaque nombre cité y sort d'un programme versionné avec le cours.

Leçon suivante
PrécédenteUn modèle est une fonction à boutonsSuivanteLe cadre du cours