• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
56/59
Lecture9 min

Plusieurs neurones par couche

Ce qui change quand chaque couche compte plusieurs neurones, et d'où vient la transposée.

Qu'est-ce qui change quand une couche compte cent neurones au lieu d'un ?
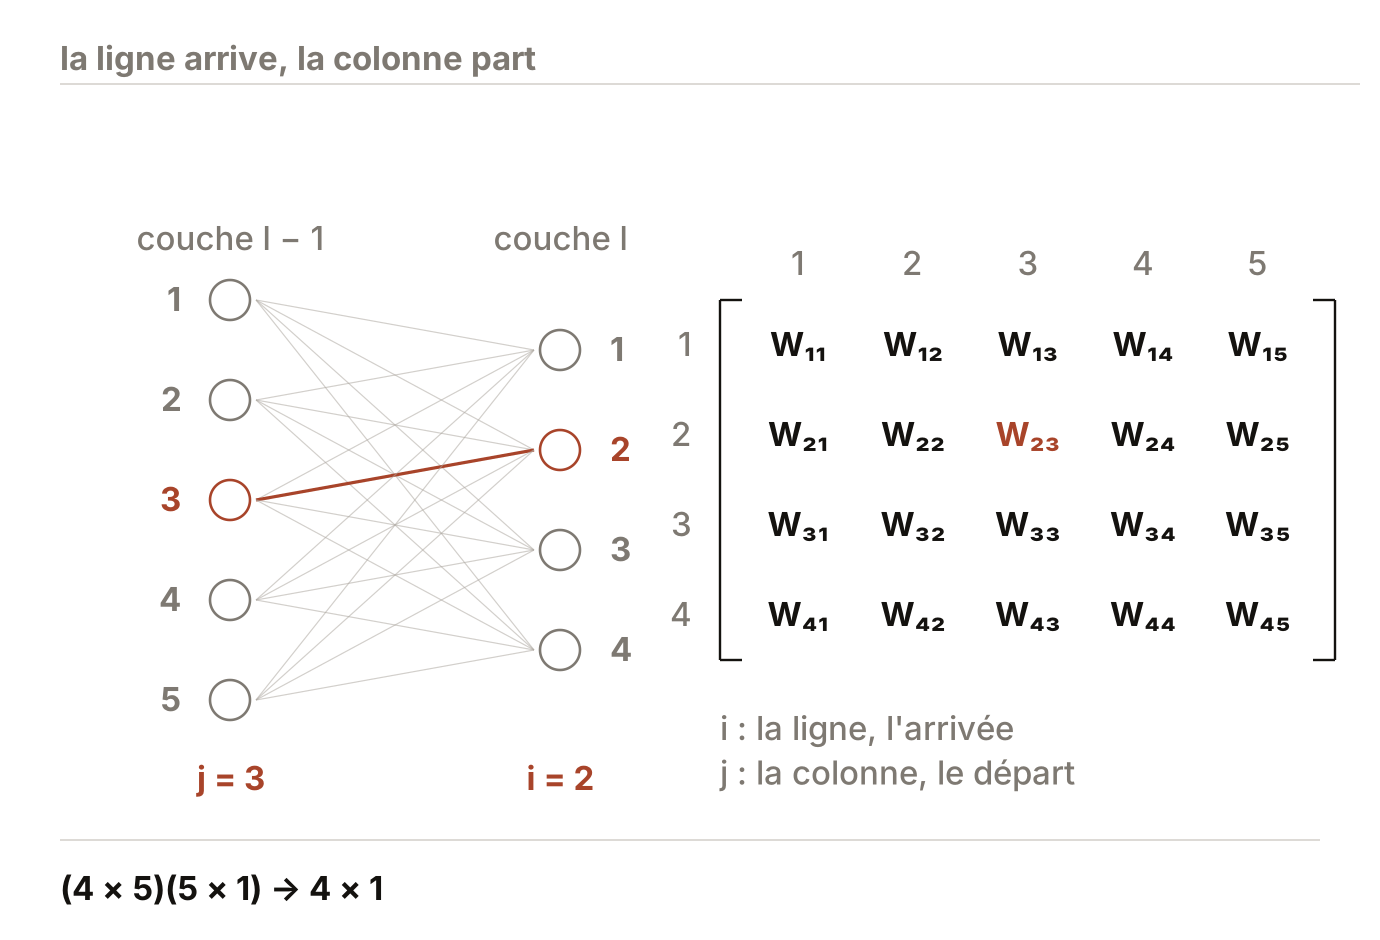
Deux objets côte à côte. À gauche, un réseau de cinq ronds pour la couche l moins un et de quatre ronds pour la couche l, avec tous les traits qui relient les uns aux autres. Le trait qui joint le troisième rond de gauche au deuxième rond de droite est tracé en brique, et les deux ronds qu'il touche sont cerclés de la même couleur. À droite, la matrice de poids de la couche l, écrite entre crochets comme une grille de quatre lignes et de cinq colonnes, où chaque case porte son coefficient. La case de la ligne deux et de la colonne trois est en brique elle aussi. Les numéros de ligne courent de un à quatre le long du bord gauche de la grille, et les numéros de colonne de un à cinq au-dessus.
Un trait du réseau et un coefficient de la matrice sont le même objet, regardé de deux façons.

Un réseau à un neurone par couche fait circuler une valeur par couche, alors qu'une couche de cent neurones en porte cent, et chacun des traits qui l'atteignent porte son propre poids : nommer ce poids demande donc deux indices, celui du neurone d'arrivée et celui du neurone de départ. Des deux dérivées que réclame une couche, l'une garde exactement la forme qu'elle avait, et l'autre devient une somme.

Le réseau général

L∈N∗, L≥2,d0,d1,…,dL∈N∗W[l]∈Mdl,dl−1(R),b[l]∈Rdla[0]=x∈Rd0,z[l]=W[l]a[l−1]+b[l]a[l]=φ(z[l])  (l<L),a[L]=softmax(z[L])\begin{aligned}&L\in\mathbb{N}^{*},\ L\geq 2,\qquad d_{0},d_{1},\dots,d_{L}\in\mathbb{N}^{*}\\ &W^{[l]}\in\mathcal{M}_{d_{l},d_{l-1}}(\mathbb{R}),\qquad \mathbf{b}^{[l]}\in\mathbb{R}^{d_{l}}\\ &\mathbf{a}^{[0]}=\mathbf{x}\in\mathbb{R}^{d_{0}},\qquad \mathbf{z}^{[l]}=W^{[l]}\mathbf{a}^{[l-1]}+\mathbf{b}^{[l]}\\ &\mathbf{a}^{[l]}=\varphi\big(\mathbf{z}^{[l]}\big)\ \ (l<L),\qquad \mathbf{a}^{[L]}=\mathrm{softmax}\big(\mathbf{z}^{[L]}\big)\end{aligned}​L∈N∗, L≥2,d0​,d1​,…,dL​∈N∗W[l]∈Mdl​,dl−1​​(R),b[l]∈Rdl​a[0]=x∈Rd0​,z[l]=W[l]a[l−1]+b[l]a[l]=φ(z[l])  (l<L),a[L]=softmax(z[L])​
(5.7)
La cible passe du scalaire au vecteur : y\mathbf{y}y est l'encodage one-hot du chapitre 2 et la perte est l'entropie croisée −yTln⁡a[L]-\mathbf{y}^{\mathsf{T}}\ln\mathbf{a}^{[L]}−yTlna[L]. Le réseau des pages précédentes en est le cas à deux classes, où σ\sigmaσ est le softmax pour K=2K=2K=2, démontré au chapitre 2, et la perte appariée à l'activation de sortie, page 6, donne δ[L]=a[L]−y\boldsymbol{\delta}^{[L]}=\mathbf{a}^{[L]}-\mathbf{y}δ[L]=a[L]−y des deux côtés.
θ∈Rp,p=∑l=1L(dl dl−1+dl)\boldsymbol{\theta}\in\mathbb{R}^{p},\qquad p=\sum_{l=1}^{L}\big(d_{l}\,d_{l-1}+d_{l}\big)θ∈Rp,p=l=1∑L​(dl​dl−1​+dl​)
(5.8)
Pour 784→64→64→64→64→10784\rightarrow 64\rightarrow 64\rightarrow 64\rightarrow 64\rightarrow 10784→64→64→64→64→10 : p=63 370p=63\,370p=63370.

La convention d'indices

$W^{[l]}_{ij}$

Le poids qui relie le jjj-ième neurone de la couche l−1l-1l−1 au iii-ième neurone de la couche lll. L'indice iii court sur [ ⁣[1,dl] ⁣][\![1,d_{l}]\!][[1,dl​]], l'indice jjj sur [ ⁣[1,dl−1] ⁣][\![1,d_{l-1}]\!][[1,dl−1​]].

L'ordre paraît inversé, puisqu'on écrit d'abord l'arrivée et ensuite le départ, mais c'est celui de la matrice, et la vérification tient en une ligne de dimensions.

ObjetDimensionsIndice de ligneIndice de colonne

W[l]W^{[l]}W[l]

dl×dl−1d_{l}\times d_{l-1}dl​×dl−1​

iii, la couche lll

jjj, la couche l−1l-1l−1

a[l−1]\mathbf{a}^{[l-1]}a[l−1]

dl−1×1d_{l-1}\times 1dl−1​×1

jjj

111

z[l]\mathbf{z}^{[l]}z[l]

dl×1d_{l}\times 1dl​×1

iii

111

(dl×dl−1)(dl−1×1)→dl×1(d_{l}\times d_{l-1})(d_{l-1}\times 1)\rightarrow d_{l}\times 1(dl​×dl−1​)(dl−1​×1)→dl​×1 : Wij[l]W^{[l]}_{ij}Wij[l]​ est bien le coefficient de la ligne iii et de la colonne jjj.
zi[l]=∑j=1dl−1Wij[l] aj[l−1]+bi[l]z^{[l]}_{i}=\sum_{j=1}^{d_{l-1}}W^{[l]}_{ij}\,a^{[l-1]}_{j}+b^{[l]}_{i}zi[l]​=j=1∑dl−1​​Wij[l]​aj[l−1]​+bi[l]​
(5.9)

Écart n°2

La source numérote les couches en exposant entre parenthèses et démarre ses indices à zéro. Les conventions du chapitre 2 sont gardées ici : exposant entre crochets, indices à partir de 1.

Ce qui ne change pas

Signal d'erreur d'une couche à plusieurs neurones

Le vecteur δ[l]∈Rdl\boldsymbol{\delta}^{[l]}\in\mathbb{R}^{d_{l}}δ[l]∈Rdl​ dont la iii-ième composante est δi[l]=∂ℓ/∂zi[l]\delta^{[l]}_{i}=\partial\ell/\partial z^{[l]}_{i}δi[l]​=∂ℓ/∂zi[l]​, la dérivée de la perte par rapport à la somme pondérée du iii-ième neurone de la couche lll. Le scalaire de la page 8 en est le cas dl=1d_{l}=1dl​=1.

DérivationLe poids, quand la couche a plusieurs neurones
1

Hypothèses

  • ·

    Réseau général (5.7).

  • ·

    Wij[l]W^{[l]}_{ij}Wij[l]​ n'apparaît que dans zi[l]z^{[l]}_{i}zi[l]​, et dans aucune autre composante.

2

Chaîne de dépendances

W^{[l]}_{ij} → z^{[l]}_i → ℓ

3

Propriétés utilisées

  • ·

    Formule (5.9)

  • ·

    Règle de la chaîne, forme simple, formule (5.2)

4

Étapes

  1. On cherche les composantes de z[l]\mathbf{z}^{[l]}z[l] où Wij[l]W^{[l]}_{ij}Wij[l]​ figure. Dans (5.9), Wij[l]W^{[l]}_{ij}Wij[l]​ n'apparaît que pour l'indice de ligne iii : la composante zm[l]z^{[l]}_{m}zm[l]​ avec m≠im\neq im=i ne le contient pas.

  2. ∂zi[l]∂Wij[l]=aj[l−1],∂zm[l]∂Wij[l]=0  (m≠i)\frac{\partial z^{[l]}_{i}}{\partial W^{[l]}_{ij}}=a^{[l-1]}_{j},\qquad \frac{\partial z^{[l]}_{m}}{\partial W^{[l]}_{ij}}=0\ \ (m\neq i)∂Wij[l]​∂zi[l]​​=aj[l−1]​,∂Wij[l]​∂zm[l]​​=0  (m=i)
  3. Un seul trajet subsiste, de sorte que la dépendance est une chaîne sans embranchement et que la forme simple de la règle de la chaîne s'applique telle quelle.

  4. ∂ℓ∂Wij[l]=∂ℓ∂zi[l]⋅∂zi[l]∂Wij[l]=δi[l] aj[l−1]\frac{\partial\ell}{\partial W^{[l]}_{ij}}=\frac{\partial\ell}{\partial z^{[l]}_{i}}\cdot\frac{\partial z^{[l]}_{i}}{\partial W^{[l]}_{ij}}=\delta^{[l]}_{i}\,a^{[l-1]}_{j}∂Wij[l]​∂ℓ​=∂zi[l]​∂ℓ​⋅∂Wij[l]​∂zi[l]​​=δi[l]​aj[l−1]​
  5. Le biais se traite de même, avec ∂zi[l]/∂bi[l]=1\partial z^{[l]}_{i}/\partial b^{[l]}_{i}=1∂zi[l]​/∂bi[l]​=1.

5

Résultat

∂ℓ∂Wij[l]=δi[l] aj[l−1],∂ℓ∂bi[l]=δi[l]\frac{\partial\ell}{\partial W^{[l]}_{ij}}=\delta^{[l]}_{i}\,a^{[l-1]}_{j},\qquad\frac{\partial\ell}{\partial b^{[l]}_{i}}=\delta^{[l]}_{i}∂Wij[l]​∂ℓ​=δi[l]​aj[l−1]​,∂bi[l]​∂ℓ​=δi[l]​
6

Interprétation

Ces deux formules ont exactement la forme du cas à un neurone par couche, avec deux indices ajoutés. Pour elles, l'affirmation « ce ne sont que quelques indices de plus » est exacte.

Ce qui change

DérivationL'activation, quand plusieurs chemins y mènent
1

Hypothèses

  • ·

    Réseau général (5.7).

  • ·

    aj[l−1]a^{[l-1]}_{j}aj[l−1]​ figure dans toutes les composantes z1[l],…,zdl[l]z^{[l]}_{1},\dots,z^{[l]}_{d_{l}}z1[l]​,…,zdl​[l]​.

2

Chaîne de dépendances

a^{[l-1]}_j → z^{[l]}_1, …, z^{[l]}_{d_l} → ℓ

3

Propriétés utilisées

  • ·

    Formule (5.9)

  • ·

    Règle de la chaîne, forme à plusieurs chemins, formule (5.3)

4

Étapes

  1. On compte les trajets. Dans (5.9), aj[l−1]a^{[l-1]}_{j}aj[l−1]​ apparaît pour chaque valeur de iii : il y a dld_{l}dl​ chemins de aj[l−1]a^{[l-1]}_{j}aj[l−1]​ vers ℓ\ellℓ, un par neurone de la couche lll. Un embranchement existe, donc c'est l'autre forme qui s'applique.

  2. ∂zi[l]∂aj[l−1]=Wij[l]\frac{\partial z^{[l]}_{i}}{\partial a^{[l-1]}_{j}}=W^{[l]}_{ij}∂aj[l−1]​∂zi[l]​​=Wij[l]​
  3. ∂ℓ∂aj[l−1]=∑i=1dl∂ℓ∂zi[l] ∂zi[l]∂aj[l−1]=∑i=1dlδi[l] Wij[l]\frac{\partial\ell}{\partial a^{[l-1]}_{j}}=\sum_{i=1}^{d_{l}}\frac{\partial\ell}{\partial z^{[l]}_{i}}\,\frac{\partial z^{[l]}_{i}}{\partial a^{[l-1]}_{j}}=\sum_{i=1}^{d_{l}}\delta^{[l]}_{i}\,W^{[l]}_{ij}∂aj[l−1]​∂ℓ​=i=1∑dl​​∂zi[l]​∂ℓ​∂aj[l−1]​∂zi[l]​​=i=1∑dl​​δi[l]​Wij[l]​

    Formule (5.3), avec m=dlm=d_{l}m=dl​ chemins.

  4. On reconnaît cette somme. À colonne jjj fixée, sommer sur l'indice de ligne iii le produit δi[l]Wij[l]\delta^{[l]}_{i}W^{[l]}_{ij}δi[l]​Wij[l]​, c'est calculer la jjj-ième composante de (W[l])Tδ[l]\big(W^{[l]}\big)^{\mathsf{T}}\boldsymbol{\delta}^{[l]}(W[l])Tδ[l].

5

Résultat

grada[l−1] ℓ=(W[l])Tδ[l] ∈Rdl−1\mathrm{grad}_{\mathbf{a}^{[l-1]}}\,\ell=\big(W^{[l]}\big)^{\mathsf{T}}\boldsymbol{\delta}^{[l]}\ \in\mathbb{R}^{d_{l-1}}grada[l−1]​ℓ=(W[l])Tδ[l] ∈Rdl−1​
6

Interprétation

La transposée du chapitre 4 n'est pas une commodité d'écriture : elle vient de cet embranchement, puisqu'une activation nourrit tous les neurones de la couche suivante et que l'indice sur lequel on somme est donc celui des lignes, non celui des colonnes.

Ce que ce résultat ne dit pas

  • ·

    L'égalité vaut composante par composante, et le passage à l'écriture matricielle demande encore de vérifier les dimensions.
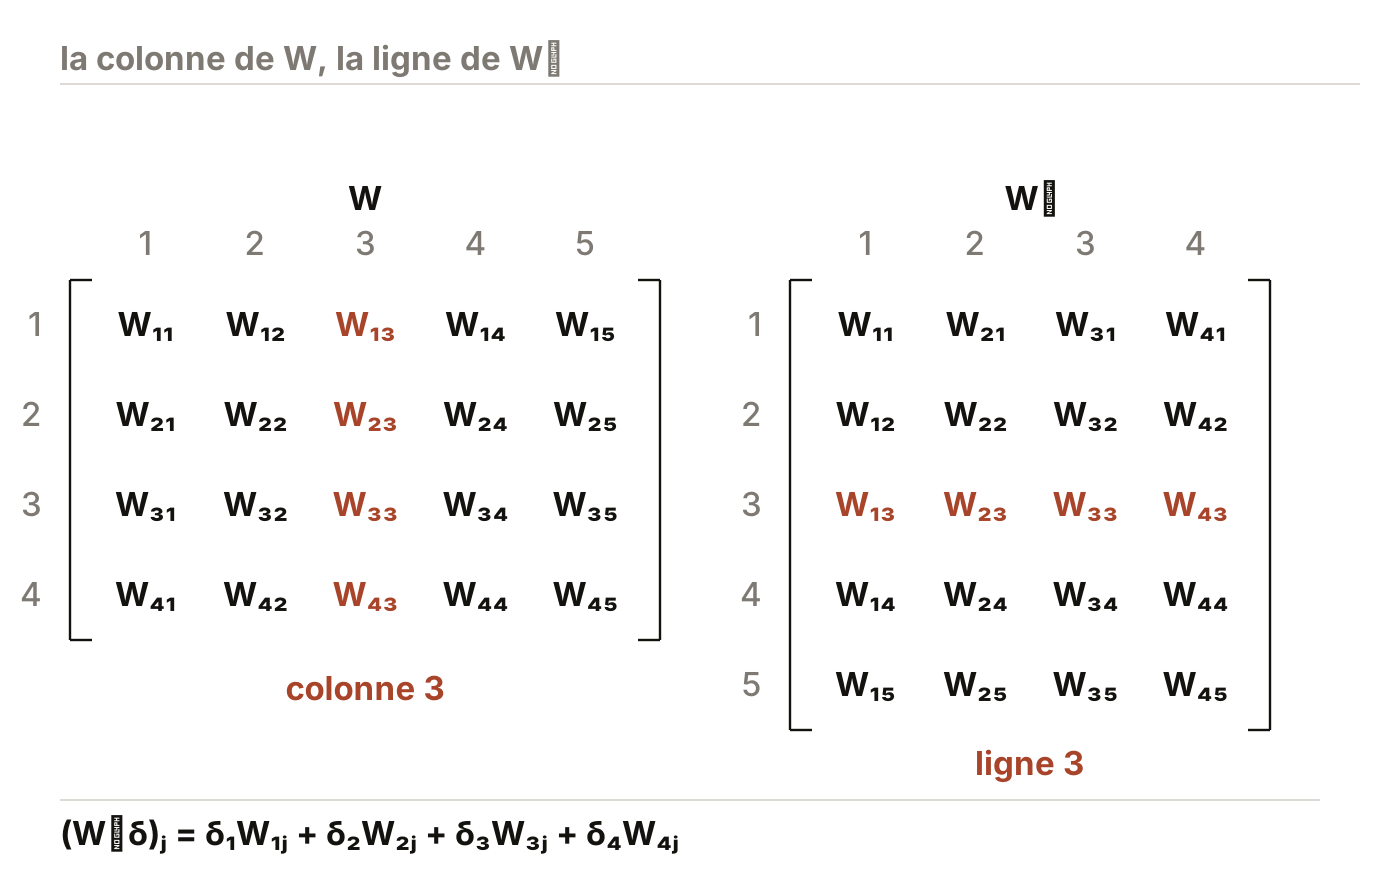
Deux grilles de coefficients, chacune entre crochets. La première est la matrice de poids de la couche l, quatre lignes et cinq colonnes, où chaque case porte son coefficient ; sa troisième colonne est en brique, et ses quatre cases portent W un trois, W deux trois, W trois trois et W quatre trois. La seconde est la transposée de la même matrice, cinq lignes et quatre colonnes ; sa troisième ligne est en brique et porte les quatre mêmes coefficients, dans le même ordre, mais couchés au lieu d'être empilés. Un trait joint la colonne en brique de la première grille à la ligne en brique de la seconde.
Les quatre coefficients sont les mêmes des deux côtés, et seule leur lecture change : la somme sur iii devient un produit matriciel sans qu'aucun nombre ne bouge.

Écart n°3

La source affirme que passer à plusieurs neurones par couche n'ajoute que quelques indices. Ce n'est vrai que du poids et du biais. Un terme change de nature : ∂ℓ/∂aj[l−1]\partial\ell/\partial a^{[l-1]}_{j}∂ℓ/∂aj[l−1]​ passe d'un produit à une somme, parce qu'un embranchement apparaît.

La récurrence générale

Le procédé se répète : de grada[l−1] ℓ\mathrm{grad}_{\mathbf{a}^{[l-1]}}\,\ellgrada[l−1]​ℓ on obtient δ[l−1]\boldsymbol{\delta}^{[l-1]}δ[l−1] en multipliant composante par composante par φ′(zj[l−1])\varphi'(z^{[l-1]}_{j})φ′(zj[l−1]​), puis les deux identités du poids et du biais donnent les dérivées des paramètres de la couche l−1l-1l−1.

δj[l−1]=(∑i=1dlδi[l] Wij[l]) φ′(zj[l−1])\delta^{[l-1]}_{j}=\Big(\sum_{i=1}^{d_{l}}\delta^{[l]}_{i}\,W^{[l]}_{ij}\Big)\,\varphi'\big(z^{[l-1]}_{j}\big)δj[l−1]​=(i=1∑dl​​δi[l]​Wij[l]​)φ′(zj[l−1]​)
(5.10)
L'initialisation reste δ[L]=a[L]−y\boldsymbol{\delta}^{[L]}=\mathbf{a}^{[L]}-\mathbf{y}δ[L]=a[L]−y : seule l'hérédité change de forme quand la couche compte plusieurs neurones.
Vérification rapide n° 58

Deux dérivées d'une même couche ne se traitent pas de la même façon.

  1. a

    Pourquoi ∂ℓ/∂Wij[l]\partial\ell/\partial W^{[l]}_{ij}∂ℓ/∂Wij[l]​ reste-t-il un produit alors que ∂ℓ/∂aj[l−1]\partial\ell/\partial a^{[l-1]}_{j}∂ℓ/∂aj[l−1]​ devient une somme ?

  2. b

    Répondre par la structure des dépendances, non par la forme des formules.

Aucune réponse à cliquer : il y a un calcul à faire.

Vérification rapide n° 59

La convention d'indices est celle de la matrice.

  1. a

    Wij[l]W^{[l]}_{ij}Wij[l]​ relie quel neurone à quel neurone ?

  2. b

    Vérifier sur les dimensions que l'ordre des indices est celui de la matrice.

Aucune réponse à cliquer : il y a un calcul à faire.

Le même transport du signal d'erreur s'écrit avec deux indices et une somme dans (5.10), et avec le seul symbole ⊙\odot⊙ au chapitre 4.

Leçon suivante
PrécédenteLa récurrence, et son corollaireSuivanteLa forme vectorielle