La forme vectorielle
Les mêmes équations écrites sans indices, en quatre lignes.
Peut-on écrire tout cela sans un seul indice ?
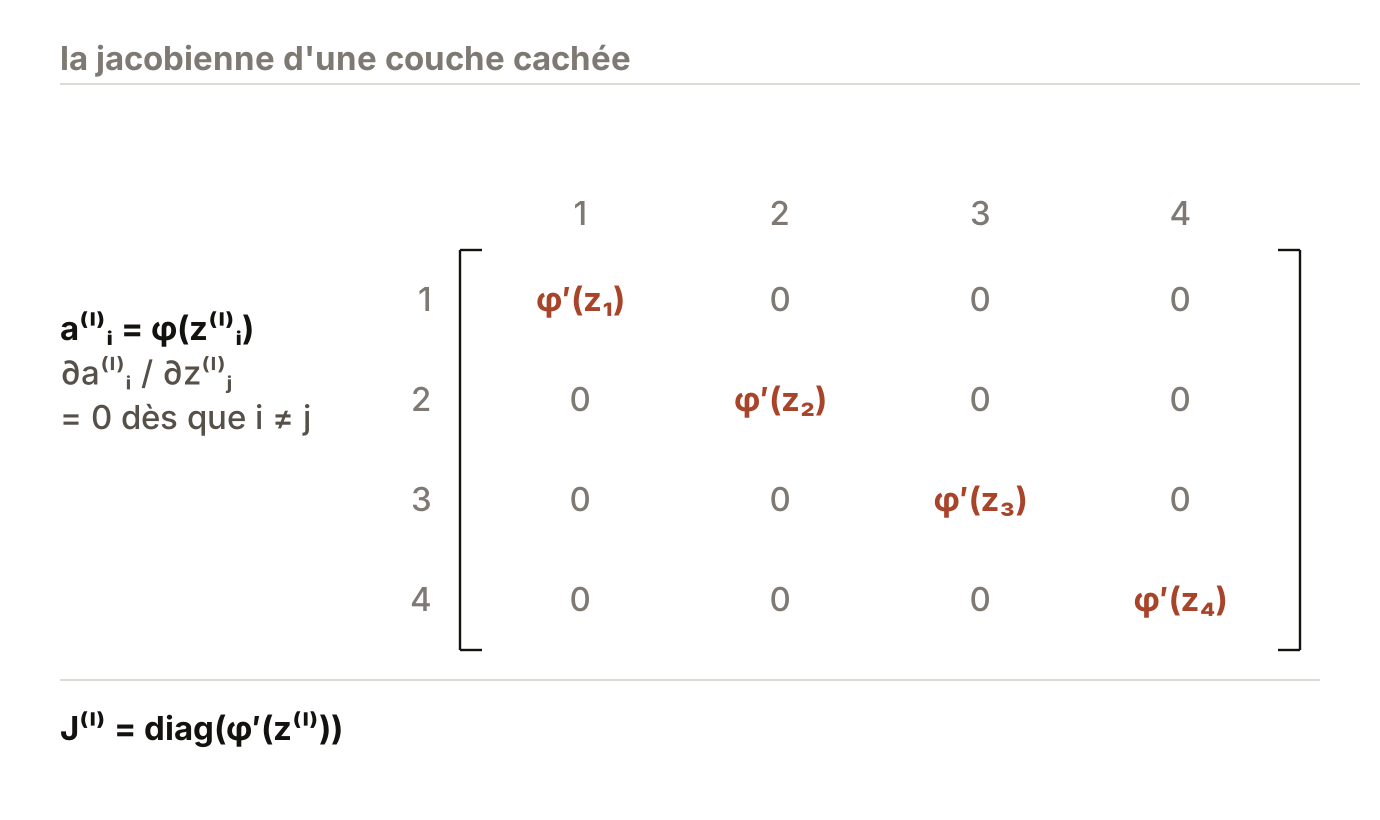
Les identités du retour se sont écrites jusqu'ici avec deux indices et une somme sur les chemins, et elles s'écrivent aussi bien avec des matrices et des vecteurs seuls. Le passage réclame un objet de plus, la jacobienne, et une propriété à démontrer : celle de l'activation par la somme pondérée ne porte que des zéros hors de sa diagonale.
La jacobienne
- JacobienneJacobian matrix
Pour différentiable en , la matrice dont le coefficient de la ligne et de la colonne est , évaluée en .
| Objet | Pour quelle fonction | Type |
|---|---|---|
Dérivée partielle | Une composante, une variable | Un scalaire |
Gradient | Un vecteur colonne de | |
Jacobienne | Une matrice |
Le retour ne demande que deux jacobiennes, et la seconde s'écrit avec la notation : la matrice carrée dont la diagonale porte les composantes de et dont tous les autres coefficients sont nuls.
Pourquoi la seconde est diagonale
Hypothèses
s'applique composante par composante : , définition page 5.
, la somme sur les chemins de la page 9 écrite au rang plutôt qu'au rang .
Propriétés utilisées
Définition de la jacobienne
pour
Étapes
La jacobienne de l'activation est diagonale. ne dépend que de : sa dérivée par rapport à est nulle dès que .
Une matrice diagonale multiplie composante par composante. Pour , la -ième composante de vaut : c'est la définition du produit de Hadamard.
On compose. La somme sur les chemins a donné , et il reste à traverser l'activation.
Dimensions : .
Résultat
Interprétation
Le produit de Hadamard du chapitre 4 n'était pas une commodité d'écriture : c'est ce que devient un produit matriciel quand la matrice est diagonale, et elle est diagonale parce que l'activation s'applique composante par composante.
Ce que ce résultat ne dit pas
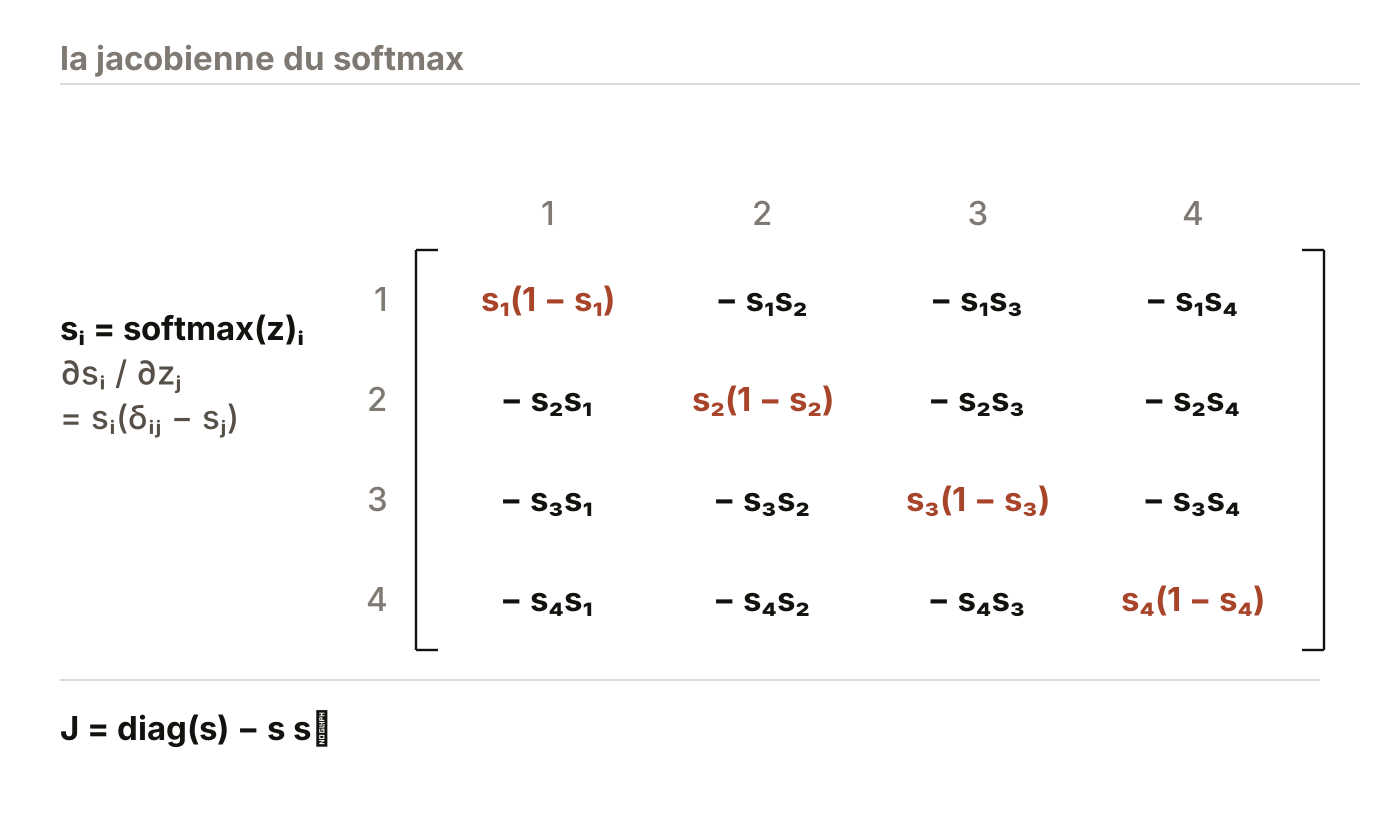
Le softmax, lui, n'a pas une jacobienne diagonale : chacune de ses composantes dépend de toutes les composantes de .
Le contrôle, et son contre-exemple
Mesure 6 · la jacobienne d'une couche cachée, par différences finies, 20 indices
  -- relu · couche cachee 3, indices 1 a 20 --------------------------------
    coefficients hors diagonale       380
    hors diagonale non nuls           0
    module maximal hors diagonale     0.000e+00
    module minimal sur la diagonale   0.000e+00

  -- sigmoide · couche cachee 3, indices 1 a 20 ----------------------------
    coefficients hors diagonale       380
    hors diagonale non nuls           0
    module maximal hors diagonale     0.000e+00
    module minimal sur la diagonale   1.465e-01
Lecture
coefficients, dont hors diagonale.
Aucun coefficient hors diagonale n'est non nul, pour les deux activations, et c'est bien ce que la diagonalité annonçait.
Le module minimal sur la diagonale vaut pour , dont la porte est fermée dès que la préactivation est négative, et pour la sigmoïde, dont la dérivée ne s'annule jamais.
Mesure 7 · la même jacobienne pour le softmax de sortie
    couche de sortie, les 10 indices
    coefficients hors diagonale       90
    hors diagonale non nuls           90
    module maximal hors diagonale     2.597e-02
    somme de chaque colonne           4.857e-11
Lecture
coefficients, dont hors diagonale, et les sont non nuls.
Le plus grand d'entre eux vaut : ce n'est pas du bruit d'arrondi.
Chaque colonne somme à zéro, à près : pousser une préactivation redistribue de la probabilité entre les classes sans en créer.
Un tableau carré de vingt rangées sur vingt colonnes occupe la hauteur de l'écran, chacune de ses quatre cents cases remplie d'une encre sombre uniforme et séparée de ses voisines par un filet très pâle. Une étiquette posée au-dessus indique que l'activation considérée est la sigmoïde. Les cases commencent alors à s'éteindre par vagues obliques qui traversent le tableau en diagonale, rangée après rangée, laissant derrière elles des cases entièrement vides ; seules celles qui se trouvent sur la diagonale allant du coin supérieur gauche au coin inférieur droit conservent leur encre. Quand la dernière vague est passée, il ne reste qu'une ligne oblique de vingt cases pleines sur un damier vide, et le contour de ces vingt cases passe en couleur brique. À droite du tableau s'inscrivent alors deux cotes, le nombre de coefficients hors diagonale et le nombre de ceux qui ne sont pas nuls, puis une troisième donnant le plus petit module relevé sur la diagonale.
Un tableau carré de dix rangées sur dix colonnes occupe le centre de l'écran, ses cent cases remplies d'une encre sombre uniforme, sous une étiquette portant le mot softmax. Une vague oblique le traverse exactement comme elle avait traversé le tableau précédent, mais cette fois aucune case ne s'éteint : les cases s'éclaircissent au passage de la vague puis retrouvent toutes leur encre. Les dix cases de la diagonale prennent ensuite un contour brique, tandis que les quatre-vingt-dix autres restent pleines. Trois cotes s'inscrivent à droite du tableau : le nombre de coefficients hors diagonale, le nombre de ceux qui ne sont pas nuls — le même — et le plus grand module relevé hors diagonale. Enfin, les colonnes du tableau s'éclairent l'une après l'autre de gauche à droite, et sous le tableau s'inscrit la somme de chaque colonne, un nombre de l'ordre de dix puissance moins onze.
Les équations, sans indices
Une colonne étroite de cases est posée à gauche de l'écran et une ligne de cases au-dessus, à angle droit l'une de l'autre, désignées l'une par delta et l'autre par a transposé. Entre elles, un grand tableau carré est entièrement vide, ses cases seulement dessinées par un filet très pâle. Une case de la colonne s'éclaire en brique, une case de la ligne s'éclaire en brique, et à l'endroit précis où leur rangée et leur colonne se croisent, une case du tableau se remplit d'encre. Le couple s'éteint, un autre couple s'éclaire ailleurs, et une deuxième case se remplit à son croisement ; la chose se répète plusieurs fois en des points dispersés du tableau. Puis le balayage s'accélère : la case éclairée de la colonne descend rangée après rangée, et à chaque descente toute une rangée du tableau se remplit d'un coup, jusqu'à ce que le tableau soit plein. Deux cotes s'inscrivent enfin à droite, l'une donnant la taille vraie du bloc et son nombre de coefficients, l'autre le nombre de multiplications que tous les produits extérieurs du réseau coûtent.
| Expression | Dimensions des facteurs | Résultat |
|---|---|---|
Une bibliothèque d'apprentissage écrit ces quatre lignes une fois pour toutes, et ce qui reste à savoir faire est de lire une chaîne de dépendances et de dire, à chaque nœud, si elle se ramifie.
La jacobienne est diagonale, mesures 6 et 7.
- a
Pourquoi cette jacobienne est-elle diagonale ?
- b
Qu'est-ce qui cesserait d'être vrai dans la récurrence du signal d'erreur si l'activation mélangeait les composantes ?
Aucune réponse à cliquer : il y a un calcul à faire.