• Projets00
  • AI Academy13
  • Veille07 entrées ces 7 derniers jours
  • Outils00
Profil
Déposer un projet
ProjetsAI AcademyVeilleOutilsProfilDéposer
Le cours
52/59
Démonstration5 min

Les trois dérivées constitutives

Les trois dérivées dont tout le reste est fait, chacune tirée de son équation.

De combien la perte bouge-t-elle quand on pousse un poids d'un cheveu ?
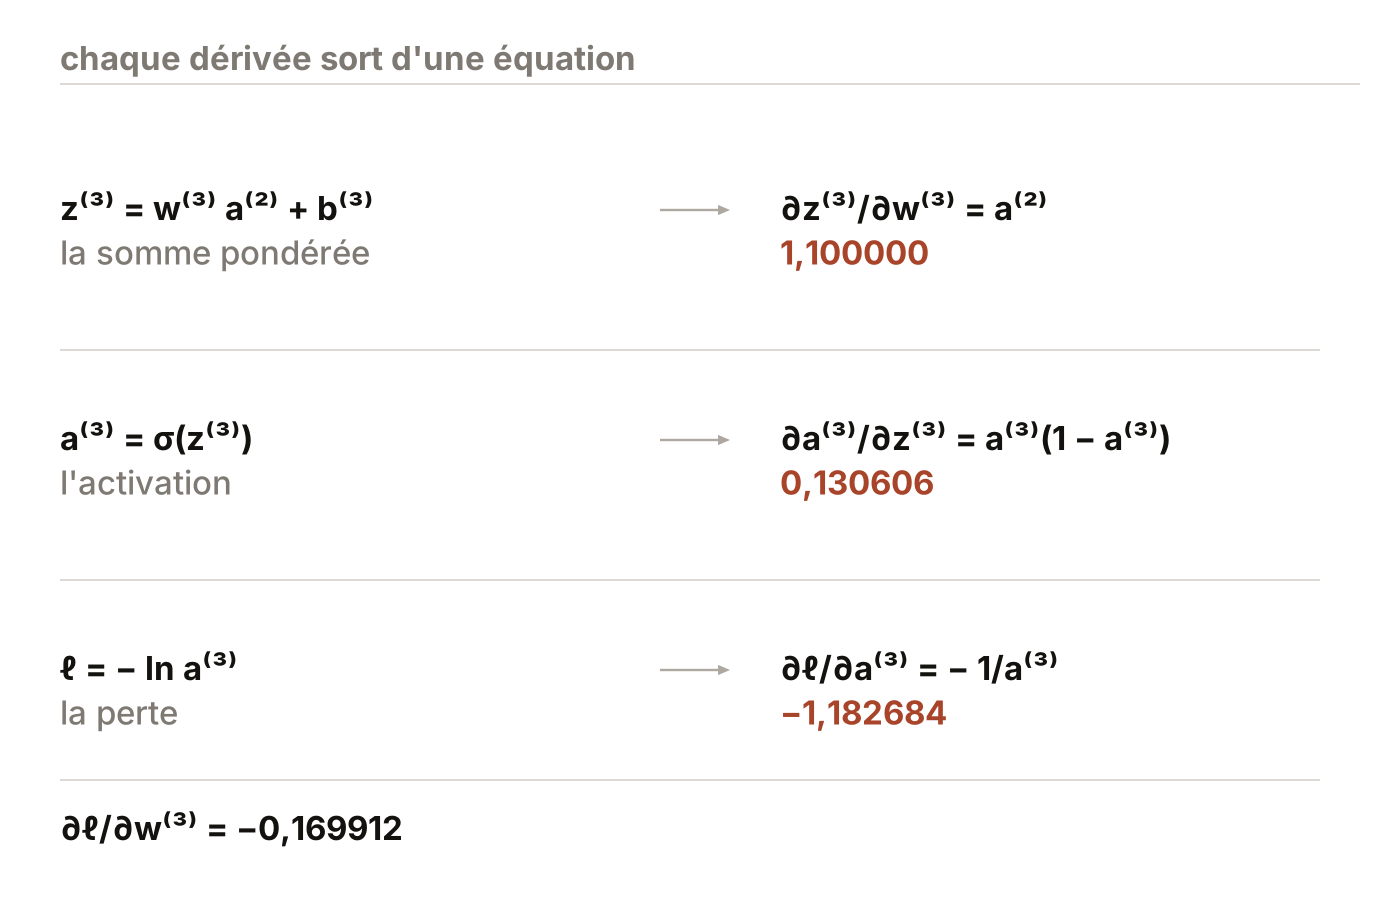
Trois bandes empilées, chacune portant une équation du réseau et, juste dessous, la dérivée qui en sort. En haut, la somme pondérée, z exposant trois égale w exposant trois fois a exposant deux plus b exposant trois, et sous elle la dérivée de z exposant trois par rapport à w exposant trois, qui vaut a exposant deux. Au milieu, l'activation, a exposant trois égale sigma de z exposant trois, et sous elle la dérivée de a exposant trois par rapport à z exposant trois, qui vaut sigma prime de z exposant trois. En bas, la perte ell, égale à moins le logarithme de a exposant trois, et sous elle la dérivée de la perte ell par rapport à a exposant trois, qui vaut a exposant trois moins y divisé par a exposant trois fois un moins a exposant trois.
Seul le premier des trois facteurs dépend de la perte, et c'est par elle que ce cours s'écarte de la série de Grant Sanderson, publiée sous le nom 3Blue1Brown, qui emploie le coût quadratique.

Chacun des trois facteurs sort d'une équation différente du réseau, et se calcule sans les deux autres. Le deuxième est la dérivée de l'activation, et il réclame donc une activation écrite en général, avant tout choix de ReLU ou de sigmoïde.

Ce qu'on suppose d'une activation pour pouvoir la dériver

Activation $\varphi$activation function

Une fonction φ:R→R\varphi:\mathbb{R}\rightarrow\mathbb{R}φ:R→R, dérivable sauf en un nombre fini de points. Appliquée à un vecteur, elle agit composante par composante : φ(u)i=φ(ui)\varphi(\mathbf{u})_{i}=\varphi(u_{i})φ(u)i​=φ(ui​), convention du chapitre 2. Sa dérivée est notée φ′\varphi'φ′, prolongée aux points de non-dérivabilité par la convention du chapitre 2 : ReLU′(0)=0\mathrm{ReLU}'(0)=0ReLU′(0)=0.

φ\varphiφφ(z)\varphi(z)φ(z)φ′(z)\varphi'(z)φ′(z)Majorant de φ′\varphi'φ′

ReLU\mathrm{ReLU}ReLU

max⁡(0,z)\max(0,z)max(0,z)

111 si z>0z>0z>0, 000 sinon

111

σ\sigmaσ

1/(1+e−z)1/(1+e^{-z})1/(1+e−z)

σ(z)(1−σ(z))\sigma(z)\big(1-\sigma(z)\big)σ(z)(1−σ(z))

1/41/41/4, chapitre 2, page 9

Une dérivée écrite avec φ′\varphi'φ′ vaut pour ces deux lignes par simple substitution, et la dernière colonne dit de combien φ′\varphi'φ′ peut au plus multiplier.

L'activation qui entre est la sensibilité de la somme pondérée à son poids

Dérivation∂z[L]/∂w[L]=a[L−1]\partial z^{[L]}/\partial w^{[L]}=a^{[L-1]}∂z[L]/∂w[L]=a[L−1]
1

Hypothèses

  • ·

    z[L]=w[L]a[L−1]+b[L]z^{[L]}=w^{[L]}a^{[L-1]}+b^{[L]}z[L]=w[L]a[L−1]+b[L].

  • ·

    a[L−1]a^{[L-1]}a[L−1] et b[L]b^{[L]}b[L] sont gelés pendant la dérivation : ils ne dépendent pas de w[L]w^{[L]}w[L].

2

Étapes

  1. On dérive une fonction affine de w[L]w^{[L]}w[L]. Le terme b[L]b^{[L]}b[L] est constant, et a[L−1]a^{[L-1]}a[L−1] est le coefficient.

  2. ∂∂w[L](w[L]a[L−1]+b[L])=a[L−1]\frac{\partial}{\partial w^{[L]}}\big(w^{[L]}a^{[L-1]}+b^{[L]}\big)=a^{[L-1]}∂w[L]∂​(w[L]a[L−1]+b[L])=a[L−1]
3

Résultat

∂z[L]∂w[L]=a[L−1]\frac{\partial z^{[L]}}{\partial w^{[L]}}=a^{[L-1]}∂w[L]∂z[L]​=a[L−1]
4

Interprétation

L'effet d'une variation du poids sur la somme pondérée est d'autant plus fort que le neurone précédent est actif. Cette lecture, et la limite de son rapprochement avec la règle de Hebb, sont établies au chapitre 4, page 5.

Ce que ce résultat ne dit pas

  • ·

    a[L−1]a^{[L-1]}a[L−1] dépend de l'exemple : cette dérivée n'est pas une constante du réseau.

La pente de l'activation, prise au point que la somme pondérée atteint

a[L]=φ(z[L])⟹∂a[L]∂z[L]=φ′(z[L])a^{[L]}=\varphi(z^{[L]})\quad\Longrightarrow\quad\frac{\partial a^{[L]}}{\partial z^{[L]}}=\varphi'(z^{[L]})a[L]=φ(z[L])⟹∂z[L]∂a[L]​=φ′(z[L])
(5.5)
C'est la définition de φ′\varphi'φ′, évaluée au point z[L]z^{[L]}z[L] et non ailleurs.

L'écart entre la sortie et la cible gouverne la dérivée de la perte

Dérivation∂ℓ/∂a[L]\partial\ell/\partial a^{[L]}∂ℓ/∂a[L] croît avec l'écart entre la sortie et la cible
1

Hypothèses

  • ·

    ℓ=−[yln⁡a[L]+(1−y)ln⁡(1−a[L])]\ell=-\big[y\ln a^{[L]}+(1-y)\ln(1-a^{[L]})\big]ℓ=−[ylna[L]+(1−y)ln(1−a[L])], entropie croisée binaire.

  • ·

    a[L]∈ ]0,1[a^{[L]}\in\,]0,1[a[L]∈]0,1[.

2

Étapes

  1. On dérive terme à terme. ln⁡\lnln a pour dérivée l'inverse, et le second terme porte un signe.

  2. ∂ℓ∂a[L]=−ya[L]+1−y1−a[L]\frac{\partial\ell}{\partial a^{[L]}}=-\frac{y}{a^{[L]}}+\frac{1-y}{1-a^{[L]}}∂a[L]∂ℓ​=−a[L]y​+1−a[L]1−y​
  3. On réduit au même dénominateur.

  4. ∂ℓ∂a[L]=a[L]−ya[L](1−a[L])\frac{\partial\ell}{\partial a^{[L]}}=\frac{a^{[L]}-y}{a^{[L]}\big(1-a^{[L]}\big)}∂a[L]∂ℓ​=a[L](1−a[L])a[L]−y​

    Mise au même dénominateur, puis simplification.

3

Résultat

∂ℓ∂a[L]=a[L]−ya[L](1−a[L])\frac{\partial\ell}{\partial a^{[L]}}=\frac{a^{[L]}-y}{a^{[L]}\big(1-a^{[L]}\big)}∂a[L]∂ℓ​=a[L](1−a[L])a[L]−y​
4

Interprétation

Le numérateur est exactement l'écart a[L]−ya^{[L]}-ya[L]−y entre la sortie et la cible : la dérivée est nulle quand la sortie atteint la cible, et d'autant plus grande en valeur absolue que la sortie en est loin.

Ce que ce résultat ne dit pas

  • ·

    Le dénominateur a[L](1−a[L])a^{[L]}(1-a^{[L]})a[L](1−a[L]) tend vers 000 aux deux bords : cette expression seule n'est pas exploitable numériquement quand la sortie sature.

Les trois dérivées en nombres, et le court-circuit qui efface le dénominateur

∂ℓ∂a[L]⋅∂a[L]∂z[L]=a[L]−ya[L](1−a[L])⋅a[L](1−a[L])=a[L]−y\frac{\partial\ell}{\partial a^{[L]}}\cdot\frac{\partial a^{[L]}}{\partial z^{[L]}}=\frac{a^{[L]}-y}{a^{[L]}\big(1-a^{[L]}\big)}\cdot a^{[L]}\big(1-a^{[L]}\big)=a^{[L]}-y∂a[L]∂ℓ​⋅∂z[L]∂a[L]​=a[L](1−a[L])a[L]−y​⋅a[L](1−a[L])=a[L]−y
Le dénominateur de la troisième dérivée est exactement la deuxième, puisque a[L]=σ(z[L])a^{[L]}=\sigma(z^{[L]})a[L]=σ(z[L]) donne σ′(z[L])=a[L](1−a[L])\sigma'(z^{[L]})=a^{[L]}\big(1-a^{[L]}\big)σ′(z[L])=a[L](1−a[L]), démontré au chapitre 2, page 9. Court-circuiter, c'est lire ∂ℓ/∂z[L]=a[L]−y\partial\ell/\partial z^{[L]}=a^{[L]}-y∂ℓ/∂z[L]=a[L]−y d'un coup au lieu de calculer les deux facteurs puis de les multiplier.

Mesure 1 · les trois dérivées constitutives, dernière couche

  -- les trois dérivées constitutives, dernière couche ---------------------
  dz3/dw3 = a2                = 1.100000
  da3/dz3 = a3 (1 - a3)       = 0.130606
  dl/da3  = (a3 - y)/a3(1-a3) = -1.182684
  produit des trois           = -0.169912
  court-circuit : dl/dz3      = -0.154465

Lecture

  • ·

    La première vaut a[2]=1,100000a^{[2]}=1{,}100000a[2]=1,100000, l'activation de la couche précédente.

  • ·

    La deuxième vaut σ′(1,7)=0,845535×0,154465=0,130606\sigma'(1{,}7)=0{,}845535\times 0{,}154465=0{,}130606σ′(1,7)=0,845535×0,154465=0,130606.

  • ·

    La troisième vaut −0,154465/0,130606=−1,182684-0{,}154465/0{,}130606=-1{,}182684−0,154465/0,130606=−1,182684 : son numérateur est l'écart à la cible.

  • ·

    Le produit des trois vaut −0,169912-0{,}169912−0,169912, et c'est ∂ℓ/∂w[3]\partial\ell/\partial w^{[3]}∂ℓ/∂w[3].

  • ·

    La dernière ligne est le produit des deux dernières seules : −1,182684×0,130606=−0,154465-1{,}182684\times 0{,}130606=-0{,}154465−1,182684×0,130606=−0,154465, où le dénominateur de l'une a effacé le facteur de l'autre.

Le même nombre pour deux quantités différentes

1−a[3]=0,1544651-a^{[3]}=0{,}1544651−a[3]=0,154465 dans la deuxième dérivée, et a[3]−y=−0,154465a^{[3]}-y=-0{,}154465a[3]−y=−0,154465 dans la troisième : les deux valeurs ne coïncident que parce que la cible vaut 111, qui fait de a[3]−ya^{[3]}-ya[3]−y l'opposé de 1−a[3]1-a^{[3]}1−a[3]. Avec y=0y=0y=0 elles n'auraient plus rien de commun.

Vérification rapide n° 52

La première dérivée constitutive sort de l'équation z[3]=w[3]a[2]+b[3]z^{[3]}=w^{[3]}a^{[2]}+b^{[3]}z[3]=w[3]a[2]+b[3].

  1. a

    Établir ∂z[3]/∂w[3]\partial z^{[3]}/\partial w^{[3]}∂z[3]/∂w[3] à partir de cette équation.

  2. b

    Dire quelles quantités sont gelées pendant la dérivation, et pourquoi ce gel est licite.

Aucune réponse à cliquer : il y a un calcul à faire.

Leçon suivante
PrécédenteL'arbre des dépendancesSuivanteL'assemblage, et le biais