L'assemblage, et le biais
Les trois dérivées mises bout à bout, et ce qu'un autre coût changerait au produit.
Que vaut le produit de ces trois rapports, sur des nombres ?
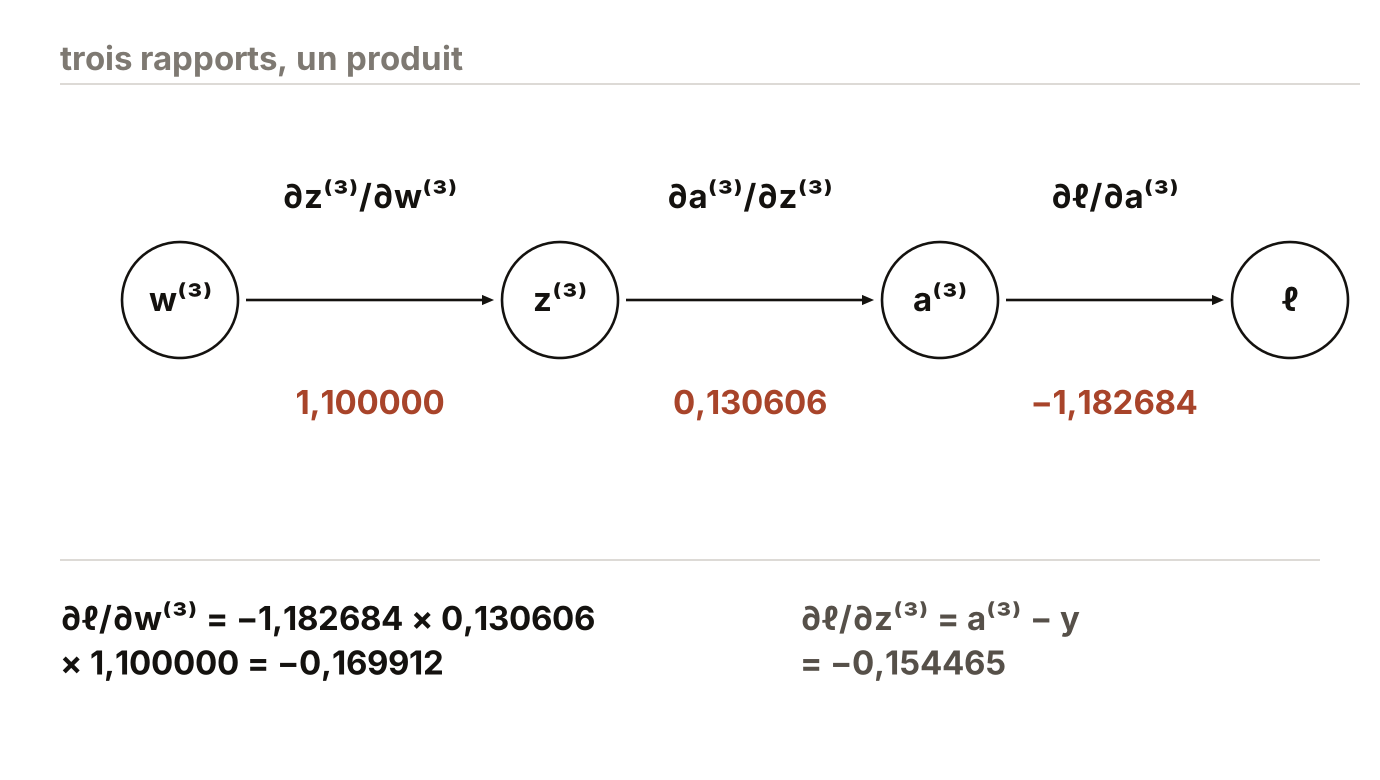
Deux des trois rapports se simplifient donc l'un l'autre, et ce qui reste est l'écart entre la sortie et la cible, multiplié par l'activation qui entre. Le biais suit la même chaîne, avec un coefficient qui vaut .
Les deux premiers facteurs se fondent en l'écart à la cible
- Perte appariée à une activation de sortiematched loss and output activation
Une perte et une activation de sortie sont appariées quand le produit se réduit à , c'est-à-dire quand la dérivée de l'activation disparaît du produit au lieu d'y rester. L'entropie croisée binaire et forment un tel couple, et c'est le calcul de la page 5 qui l'établit ; le coût quadratique et n'en forment pas un.
Hypothèses
Réseau à un neurone par couche, équations (5.4).
Perte appariée à l'activation de sortie : entropie croisée binaire sur .
La chaîne est sans embranchement.
Chaîne de dépendances
w^{[L]} → z^{[L]} → a^{[L]} → ℓ
Propriétés utilisées
La décomposition en trois rapports, page 4
Les trois dérivées de la page 5
Le court-circuit de et de , page 5
Étapes
La somme pondérée donne deux dérivées. est affine en comme en .
L'activation donne . , donc .
La perte est appariée à l'activation de sortie. Le facteur qu'on vient d'écrire est effacé par , et il ne reste de leur produit que l'écart à la cible.
Page 5 : est exactement le dénominateur de , et les deux facteurs s'annulent.
On assemble. La décomposition en trois rapports donne le produit des trois facteurs ; les deux premiers viennent d'être remplacés par leur produit simplifié.
Résultat
Interprétation
Le biais est le cas le plus simple : le facteur qui le multiplie dans la somme pondérée vaut , donc sa dérivée est l'écart lui-même, et elle ne dépend d'aucune activation.
Ce que ce résultat ne dit pas
Le court-circuit tient à l'appariement de la perte et de l'activation de sortie ; avec un autre couple, ne disparaît pas.
Ces deux identités ne concernent que la dernière couche.
Avec le coût quadratique, la pente de l'activation reste au produit
Si la perte était , sa dérivée par rapport à l'activation vaudrait , aucun dénominateur ne viendrait effacer , et ce facteur resterait au produit.
| Perte | ||
|---|---|---|
Quadratique | ||
Entropie croisée, appariée à |
En nombres : le poids porte une activation, le biais porte l'écart seul
Mesure 1 · la passe arrière, dernière couche
  delta3 = a3 - y            = -0.154465
  dl/dw3 = delta3 . a2       = -0.169912
  dl/db3 = delta3            = -0.154465
Lecture
: la sortie est en dessous de la cible, l'écart est négatif.
, la valeur déjà obtenue page 5 par le produit des trois.
: aucune activation n'y figure.
Le gradient du coût est la moyenne des gradients des exemples
Le coût sur un jeu de données est la moyenne des pertes de ses exemples, et la dérivée d'une moyenne est la moyenne des dérivées : est la moyenne des , sans facteur ni approximation. C'est démontré au chapitre 4, proposition 7.
Deux composantes du gradient sur six
Le réseau minuscule a six paramètres, donc son gradient a six composantes. Les deux identités ci-dessus en donnent deux, celle du poids et celle du biais de la dernière couche, et les quatre autres portent sur , qu'aucune des deux ne touche.
Le tableau des deux coûts donne deux expressions de .
- a
Avec le coût quadratique, la dérivée par rapport au dernier poids comporte un facteur que notre perte fait disparaître. Lequel ?
- b
Pourquoi disparaît-il ?
Aucune réponse à cliquer : il y a un calcul à faire.
Le gradient compte une composante par paramètre, formule (5.1).
- a
Combien de composantes le gradient du réseau compte-t-il ?
- b
Combien les deux identités de la dernière couche en donnent-elles sur le réseau minuscule, et combien en reste-t-il ?
Aucune réponse à cliquer : il y a un calcul à faire.
Aucun de ces quatre paramètres n'apparaît dans , et sur l'arbre de la page 4 ils atteignent tous la perte par le même nœud, l'activation .