La deuxième voie : les poids
Corriger un poids : la correction est proportionnelle à l'activation qui l'alimente.
Un neurone de sortie reçoit cent vingt-huit traits, et chacun porte un nombre à corriger. Deux de ces traits partent de deux neurones cachés dont l'un est très actif et l'autre presque éteint : leurs deux poids reçoivent-ils la même correction ?
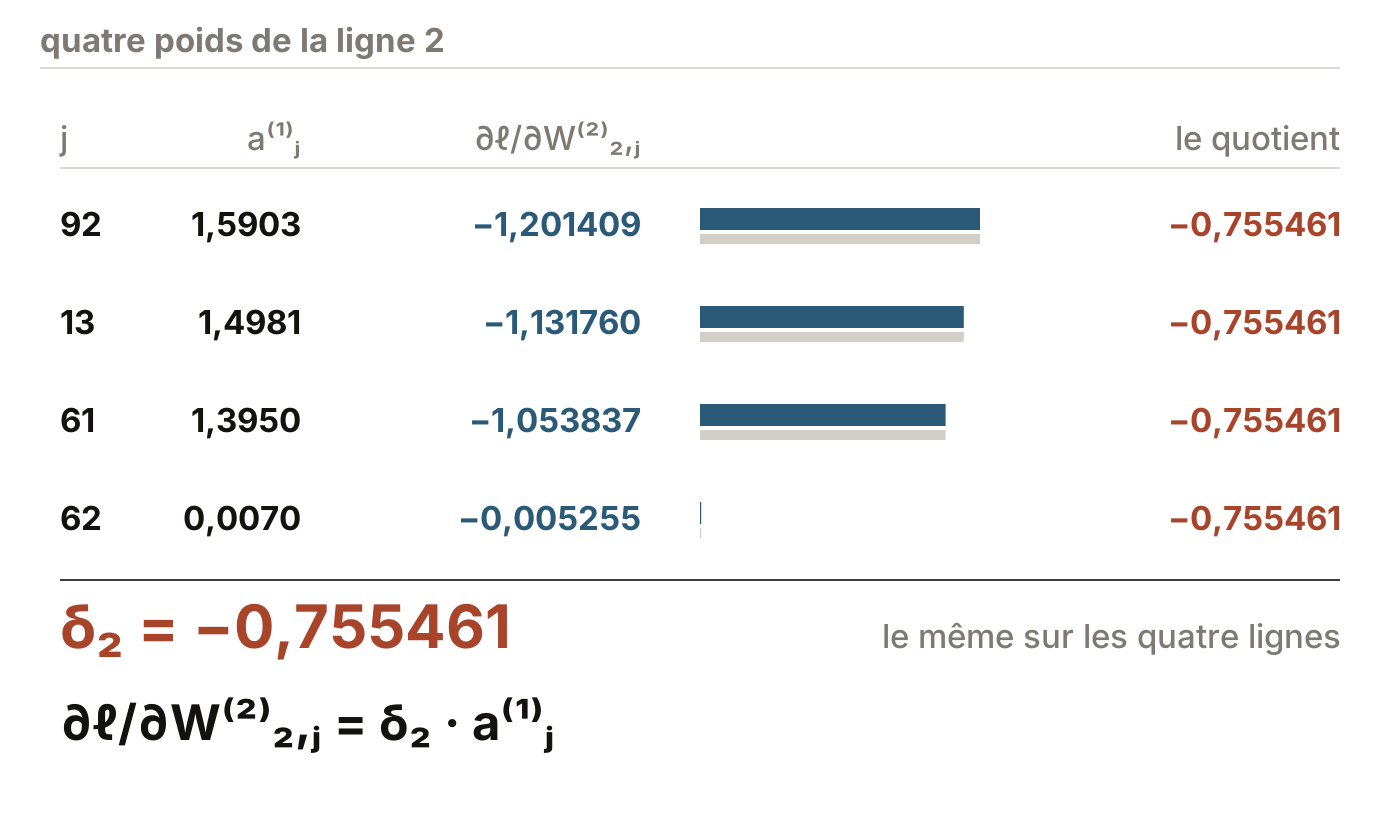
Les quatre neurones sont désignés par un critère, les trois plus actifs et le moins actif parmi ceux qui sont allumés, et non choisis à la main. La colonne de droite est la même sur les quatre lignes, jusqu'à la sixième décimale.
Cette constance n'est pas un hasard de mesure : elle est forcée, et le calcul le montre.
Le produit extérieur
- Produit extérieurouter product
Pour et , la matrice de coefficient général . C'est le produit matriciel ordinaire d'une colonne par une ligne : .
La dérivée par rapport à un poids de sortie
Hypothèses
.
est fixé : il ne dépend pas de , puisqu'il est produit avant.
.
Chaîne de dépendances
W_{kj}^{[2]} → z_k^{[2]} → a^{[2]} → ℓ
Propriétés utilisées
Règle de la chaîne à plusieurs chemins, formule (4.4)
Le poids n'apparaît que dans la ligne de la somme pondérée
Étapes
Dans la somme , un seul terme contient , et son facteur est .
On rassemble les égalités en une seule. Le coefficient de la matrice recherchée est le produit de la -ième composante de par la -ième composante de , ce qui est la définition du produit extérieur.
Vérification des dimensions : le résultat a exactement la forme de , ce qui est nécessaire pour que ait un sens.
Résultat
Interprétation
À ligne fixée, est exactement proportionnel à , de coefficient , et le rapport entre deux coefficients d'une même ligne vaut donc exactement le rapport des deux activations correspondantes. « Ajuster les poids proportionnellement aux activations » n'est pas une heuristique qu'on adopterait par analogie : c'est ce que dit l'identité, et la mesure 3 le vérifie à la sixième décimale.
Ce que ce résultat ne dit pas
La proportionnalité vaut à ligne fixée : entre deux lignes différentes le coefficient change, et les tailles ne se comparent plus par les seules activations.
L'identité ne dit rien du meilleur rendement d'un ajustement, c'est-à-dire de la baisse de perte obtenue par unité de déplacement, une notion du chapitre 3, page 10, qui n'est pas redéveloppée ici.
La proportionnalité, sur les nombres
Quatre poids d'une même ligne · cours/lecon4/mesures.py, mesure 3
  -- Proportionnalité à l'activation, ligne k = 2 (delta_k < 0) ------------
      j       a_j        d l / d W_kj      quotient
      92      1.5903     -1.201409       -0.755461
      13      1.4981     -1.131760       -0.755461
      61      1.3950     -1.053837       -0.755461
      62      0.0070     -0.005255       -0.755461

  delta_2                                      -0.755461
  rapport de la plus grande à la plus petite    228.6
Lecture
Le quotient vaut pour les quatre neurones, à la sixième décimale : c'est , et c'est la proposition 4 lue de droite à gauche.
Le poids qui part du neurone le plus actif reçoit une correction fois plus grande que celui du neurone le moins actif, et ce rapport est celui de leurs deux activations, et rien d'autre.
Le réseau pâlit. Quatre ronds apparaissent en colonne au centre droit du cadre, régulièrement espacés : ce sont quatre neurones cachés, tirés de la couche de cent vingt-huit. Les trois premiers sont remplis d'encre, de plus en plus pâle ; le quatrième est vide, son contour seul. À gauche de chacun s'inscrit son activation mesurée : un virgule cinq neuf zéro trois, un virgule quatre neuf huit un, un virgule trois neuf cinq zéro, et zéro virgule zéro zéro sept zéro. Le troisième rond de la colonne de sortie passe au trait de brique avec son étiquette. Quatre traits gris relient alors les quatre ronds à ce neurone, tous de la même finesse. Ils s'épaississent ensemble, chacun de la correction que son poids reçoit : le premier devient un ruban large, le deuxième et le troisième à peine moins, et le quatrième reste un cheveu qu'on distingue à peine du papier. Une valeur s'inscrit enfin à droite du neurone de sortie : moins zéro virgule sept cinq cinq quatre six un.
La même ligne, pour un neurone qui n'est pas celui de la classe · mesure 3
  -- Le même tableau pour une ligne k = 0 (delta_k > 0) --------------------
      j       a_j        d l / d W_kj      quotient
      92      1.5903     +0.217237       +0.136601
      13      1.4981     +0.204643       +0.136601
      61      1.3950     +0.190553       +0.136601
      62      0.0070     +0.000950       +0.136601

  delta_0                                      +0.136601
Lecture
Tous les signes sont inversés, et une seule quantité a changé : au lieu de .
Le quotient reste constant sur les quatre lignes et vaut , donc la structure de la proposition 4 ne dépend pas du signe.
Les corrections de cette ligne sont cinq fois et demie plus petites que celles de la ligne , dans le rapport : ce sont les mêmes activations, avec un autre signal d'erreur.
Deux neurones cachés ont pour activations et , et sont reliés au même neurone de sortie .
- a
Quel est le rapport des corrections apportées aux deux poids ? Justifier par la proposition 4, sans calculer les dérivées.
- b
Ce rapport change-t-il si l'on remplace le neurone de sortie par un autre ?
Aucune réponse à cliquer : il y a un calcul à faire.
Un neurone caché est éteint pour l'exemple courant : , donc .
- a
Que valent les dix dérivées , , et pourquoi ?
- b
Le corollaire dit que coefficients de sont nuls sur l'exemple de travail. Retrouver ce nombre à partir de la mesure 1.
Aucune réponse à cliquer : il y a un calcul à faire.