Ce que Hebb dit, et ce qu'il ne dit pas
La ressemblance avec la règle de Hebb, ce qu'elle a de juste, et l'endroit où elle casse.
Un énoncé de 1949 dit que deux neurones qui s'activent ensemble renforcent la liaison qui les unit, et la correction qu'on vient de calculer y ressemble beaucoup. Jusqu'où va la ressemblance ?
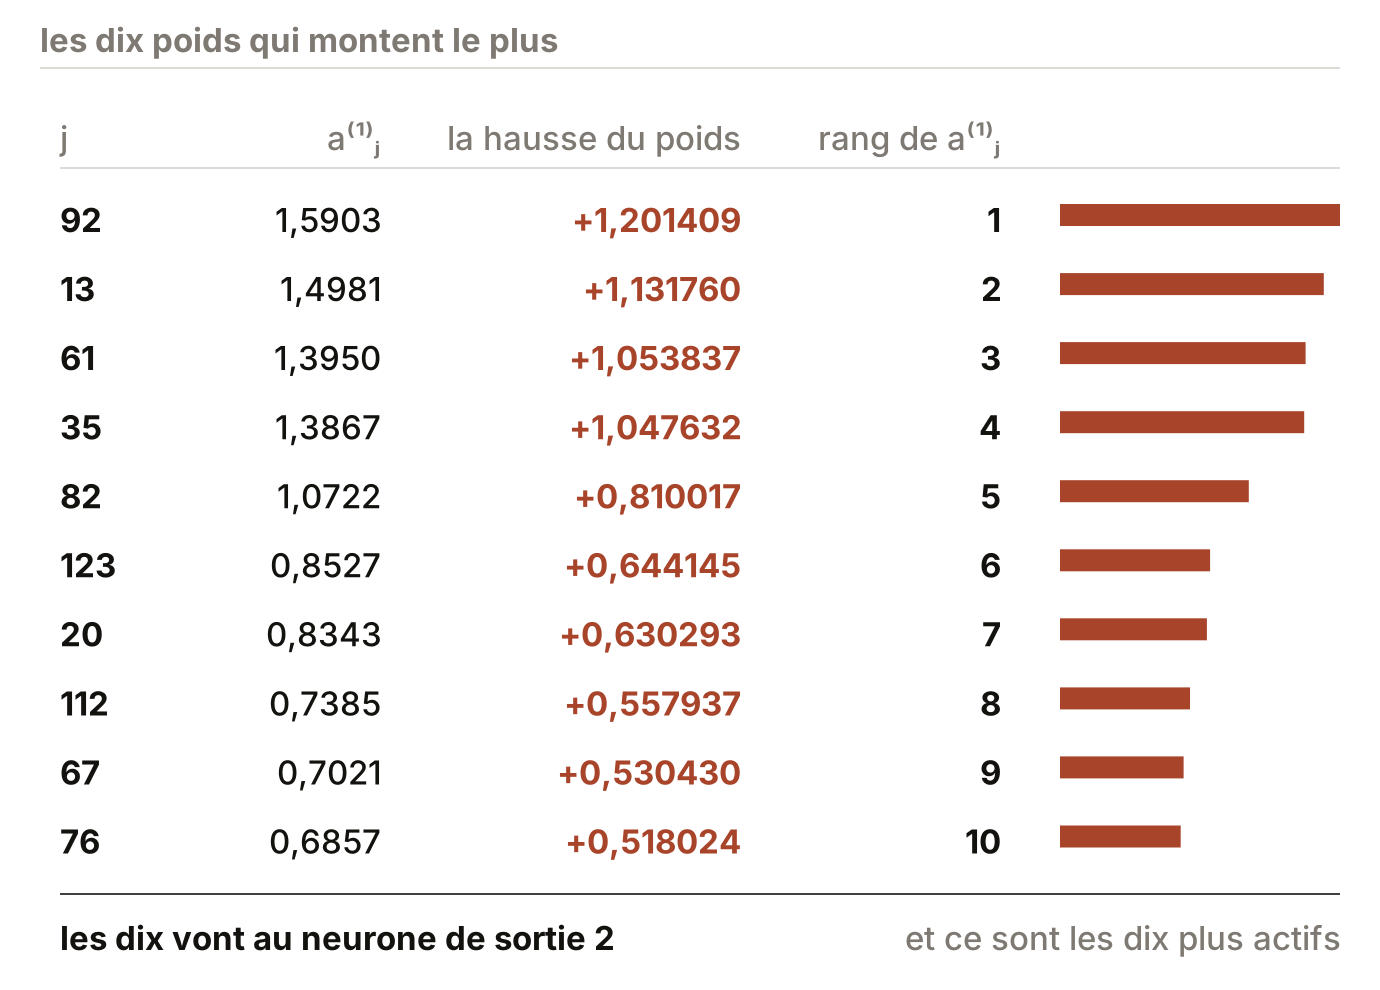
Le programme a classé les poids de la couche de sortie par la hausse qu'ils reçoivent, au facteur près, et n'a gardé que les dix premiers. Deux régularités sautent aux yeux : un seul neurone de sortie apparaît, et la colonne des rangs d'activation donne à sans un trou.
Aucune des deux n'est une coïncidence, et les deux se démontrent avec ce qui précède.
La théorie de Hebb
- Règle de HebbHebbian learning
Énoncé formulé par Donald Hebb en 1949 : quand deux neurones s'activent ensemble de façon répétée, la liaison qui les unit se renforce. Résumé en une formule mnémonique, neurons that fire together wire together.
Le rapprochement, écrit précisément
- 01
Le poids augmente si et seulement si et , et la proposition 1 dit que le premier ne vaut que pour un seul , celui de la vraie classe.
- 02
L'augmentation est d'autant plus grande que est grand : la proposition 4 donne , la proposition 1 permet de l'écrire , et la mise à jour la multiplie par , ce qui fait .
- 03
Les liaisons qui se renforcent le plus relient donc les neurones cachés les plus actifs au neurone de sortie de la vraie classe, ce qui est la moitié de l'énoncé de Hebb, obtenue par un calcul de dérivée. L'autre moitié manque : l'activité du neurone de sortie n'entre nulle part dans (4.7).
Le contrôle
Le contrôle de Hebb · cours/lecon4/mesures.py, mesure 6
      rang    k     j       a_j        -d l / d W_kj    rang de a_j
      1       2     92      1.5903     +1.201409        1
      2       2     13      1.4981     +1.131760        2
      3       2     61      1.3950     +1.053837        3
      4       2     35      1.3867     +1.047632        4
      5       2     82      1.0722     +0.810017        5
      6       2     123     0.8527     +0.644145        6
      7       2     20      0.8343     +0.630293        7
      8       2     112     0.7385     +0.557937        8
      9       2     67      0.7021     +0.530430        9
      10      2     76      0.6857     +0.518024        10

  neurones de sortie concernés                   [2]
  la vraie classe est                            2
  rangs d'activation des dix neurones cachés     [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
  activation la plus faible des dix              0.6857
  activation la plus forte des 128               1.5903
Lecture
Les dix couples portent tous , la vraie classe, et aucun autre neurone de sortie n'apparaît, ce qui est la proposition 1 : une seule composante de est négative, donc un seul neurone de sortie voit ses poids augmenter.
Les rangs d'activation sont à , dans l'ordre et sans trou, donc le classement par correction reçue et le classement par activation coïncident exactement, ce qui est la proposition 4 : à ligne fixée, l'un est l'autre multiplié par .
Le contrôle ne pouvait donc pas échouer si les propositions 1 et 4 sont justes, et c'est précisément pour cela qu'il est intéressant : il montre que l'énoncé de Hebb, sur ce réseau et cet exemple, est une conséquence des deux propositions, et non une observation indépendante.
Où l'analogie casse
Deux choses distinguent la mise à jour (4.7) de la règle de Hebb, et aucune des deux n'est un détail.
La correction d'un poids de sortie vaut , avec et .
- a
Pour quel signe de le poids augmente-t-il, et quelle classe cela désigne-t-il ?
- b
Combien de lignes de voient leurs poids augmenter sur un exemple donné ? Justifier par la proposition 1.
Aucune réponse à cliquer : il y a un calcul à faire.
Le texte donne deux raisons pour lesquelles l'analogie avec la règle de Hebb est inexacte.
- a
Énoncer ces deux raisons, et dire pour chacune quelle quantité de la formule (4.7) est en cause.
- b
Construire un cas où deux neurones s'activent fortement ensemble et où pourtant leur liaison descend.
Aucune réponse à cliquer : il y a un calcul à faire.