Synthèse de la série, formulaire et ressources
Les cinq chapitres bout à bout, le formulaire, et les erreurs fréquentes.
Qu'est-ce qu'un réseau, au juste, une fois les cinq chapitres derrière soi ?
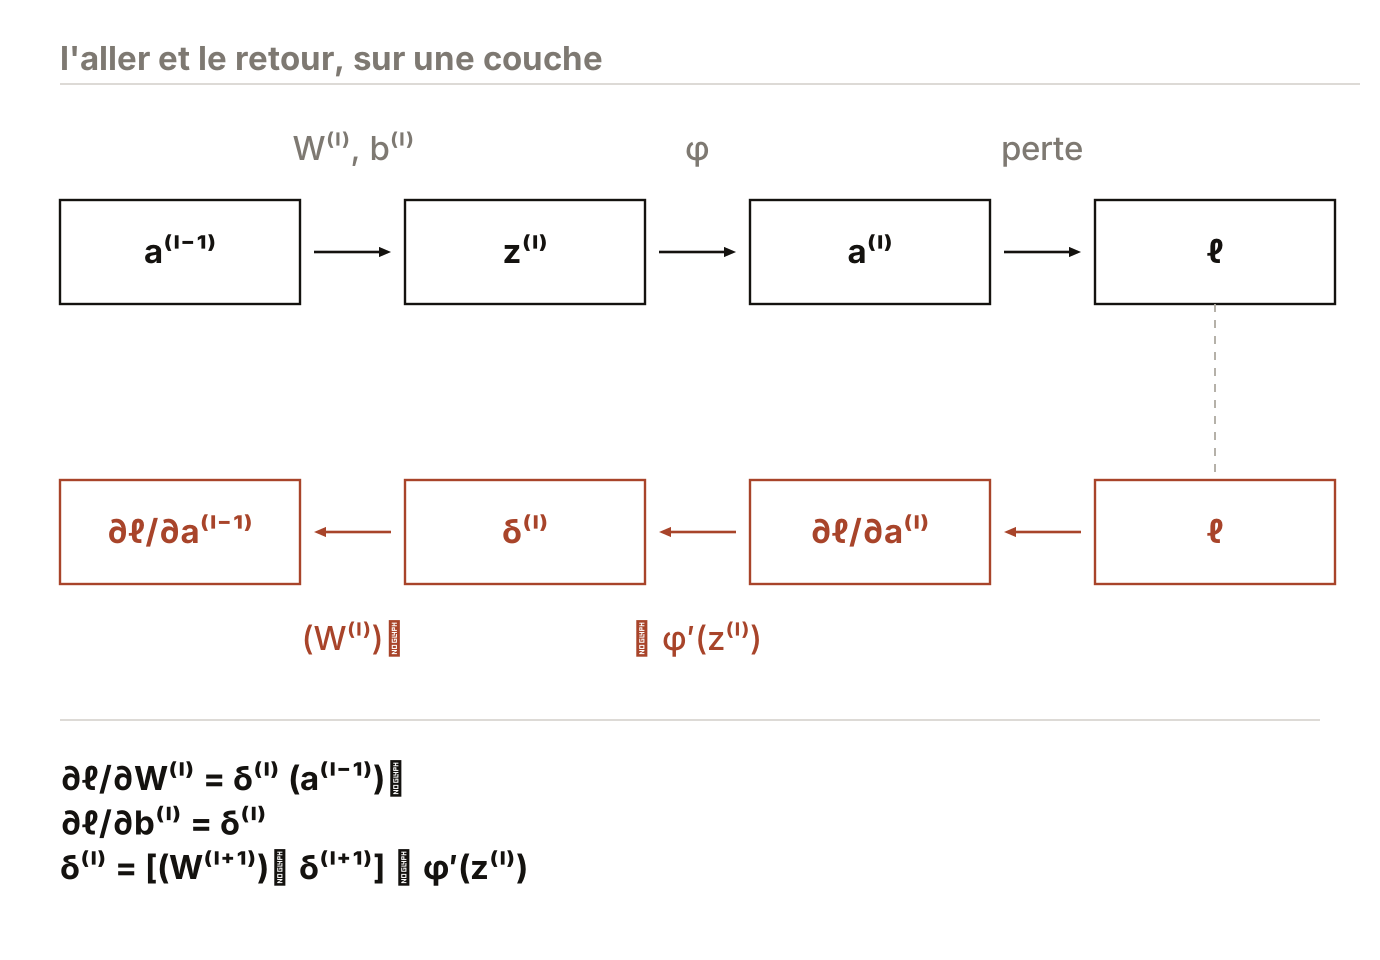
Un modèle est une fonction à paramètres, et apprendre consiste à choisir ces paramètres à partir d'exemples. Un réseau de neurones enchaîne des couches dont chacune applique une matrice puis une fonction composante par composante : c'est la multiplication matricielle qui porte la propagation. Le coût transforme « le réseau se trompe » en un nombre dérivable, et minimiser ce nombre, c'est descendre la direction . La rétropropagation est ce qui rend ce gradient calculable : elle décompose un réseau d'influences en une chaîne de dépendances, et la règle de la chaîne en donne chaque terme.
Ce que chaque chapitre ajoute
| Chapitre | Ce qu'il établit | L'objet qu'il ajoute |
|---|---|---|
1 · Panorama | Ce qu'est un modèle, une perte, un jeu de données | , , |
2 · Le réseau | Ce qu'un réseau calcule, et ce que ses poids valent | , , |
3 · L'optimisation | Pourquoi cette direction, ce pas, cette initialisation | , , la différence finie |
4 · La rétropropagation | Ce que fait l'algorithme, sur deux couches | , , le produit extérieur |
5 · Le calcul | Sa forme générale, démontrée par récurrence | quelconque, , |
Formulaire
| Ce qui est établi | Démontré page |
|---|---|
Ce dont dépend la perte, décomposé en trois rapports | 4 |
Les trois dérivées constitutives, chacune sous son équation | 5 |
Le poids et le biais de la dernière couche | 6 |
L'activation de la couche précédente | 7 |
Le signal d'erreur se transporte d'une couche à la précédente | 8 |
Le poids, quand la couche a plusieurs neurones | 9 |
L'activation, quand plusieurs chemins y mènent | 9 |
Le retour, écrit sans indices | 10 |
Ce que coûtent une passe avant et une passe retour | 11 |
Le tableau des objets
| Objet | Type | Défini où |
|---|---|---|
, | Entiers | Page 9 |
Page 9 | ||
, , , | Pages 9 et 8 | |
, | , appliquées composante par composante | Page 5 |
Page 10 | ||
, nulle hors diagonale | Page 10 | |
Produit composante par composante | Chapitre 4 | |
Entier, formule (5.8) | Page 9 |
L'algorithme complet
entree theta = (W[1], b[1], ..., W[L], b[L]), x, ysortie grad W[1], grad b[1], ..., grad W[L], grad b[L] a[0] <- x pour l de 1 a L : # passe avant z[l] <- W[l] a[l-1] + b[l] si l < L : a[l] <- phi(z[l]) sinon : a[l] <- softmax(z[l]) delta <- a[L] - y # passe arriere pour l de L a 1 : grad W[l] <- delta (a[l-1])^T grad b[l] <- delta si l > 1 : delta <- ((W[l])^T delta) ⊙ phi'(z[l-1])Erreurs fréquentes
- 01
Appliquer la forme simple de la règle de la chaîne là où il y a un embranchement. Dès que la couche a plusieurs neurones, est une somme, pas un produit.
- 02
Lire comme un quotient. C'est une limite ; le quotient dépend de , sa limite non.
- 03
Oublier que s'évalue en , et non en ni en .
- 04
Garder le facteur à la dernière couche. Avec une perte appariée à l'activation de sortie, définie page 6, il a déjà disparu dans ; le remettre le compte deux fois.
- 05
Traîner un facteur . Il vient du coût quadratique, que ce parcours n'emploie pas.
- 06
Oublier la transposée dans la remontée. n'a même pas les bonnes dimensions ; le contrôle est immédiat.
- 07
Confondre jacobienne et gradient. Le gradient d'une fonction à valeurs réelles est la transposée de sa jacobienne, qui a alors une seule ligne.
- 08
Croire que le produit de Hadamard est une commodité d'écriture. Il vient de ce que est diagonale, et elle l'est parce que agit composante par composante.
- 09
Traverser le softmax composante par composante. Sa jacobienne n'est pas diagonale : coefficients hors diagonale non nuls, mesure 7.
- 10
Écrire pour le poids allant du neurone vers le neurone . L'ordre est l'inverse, et il est celui de la matrice.
- 11
Conclure d'une vérification numérique qu'une identité est démontrée. Une différence finie contrôle un cas, pas un énoncé.
- 12
Lire un écart relatif là où la dérivée est plus petite que le plancher d'arrondi. Il ne mesure alors plus rien, mesure 4.
Sur un réseau avec sur les couches cachées et en sortie, écrire les dimensions de , de et de ; puis compter par la formule (5.8), et majorer le coût du gradient en propagations avant.
Attendu · Sept dimensions, la valeur de $p$, et un majorant du coût.
Pour aller plus loin
| Ressource | Auteur | Ce qu'on y trouve |
|---|---|---|
Neural Networks and Deep Learning | Michael Nielsen | Un livre en ligne qui démontre les quatre équations de la rétropropagation et les met en œuvre en Python. |
Calculus on Computational Graphs: Backpropagation | Christopher Olah | Un billet qui traite la rétropropagation comme un parcours de graphe, et la rapproche de la différentiation en mode direct. |
Distill | Revue collective | Des articles d'apprentissage automatique dont les figures sont interactives. |
Deep Learning | Ian Goodfellow, Yoshua Bengio, Aaron Courville | Un ouvrage de référence dont le chapitre 6 couvre la différentiation automatique sur des graphes quelconques. |
La règle de la chaîne, dont chaque dérivation se sert, se démontre dans le bloc de mathématiques du parcours.
L'ordre des notions suit celui du dernier chapitre de la série de Grant Sanderson sur les réseaux de neurones, publiée sous le nom 3Blue1Brown. Le texte, les définitions, les démonstrations, les sept mesures et les vingt-huit animations sont propres à ce cours, et les écarts pris à la source sont signalés à la page où ils se produisent.