Dix neurones
Passer d'un neurone à dix, transformer leurs scores en probabilités, et mesurer ce que ça vaut.
Une pièce de calcul ne rend qu'un seul nombre, quand la tâche en réclame dix, un par chiffre possible, puis une réponse unique. Dix nombres sans échelle commune ne se comparent pourtant à rien, et il faudra les ramener sur une échelle où la somme des dix vaut un. Comment passe-t-on d'une brique isolée à un modèle qui tranche entre dix chiffres ?
Dix neurones au lieu d'un
Dix neurones qui lisent tous la même chose et rendent chacun leur nombre forment ce qu'on appelle une couche, et c'est l'objet de cette page.
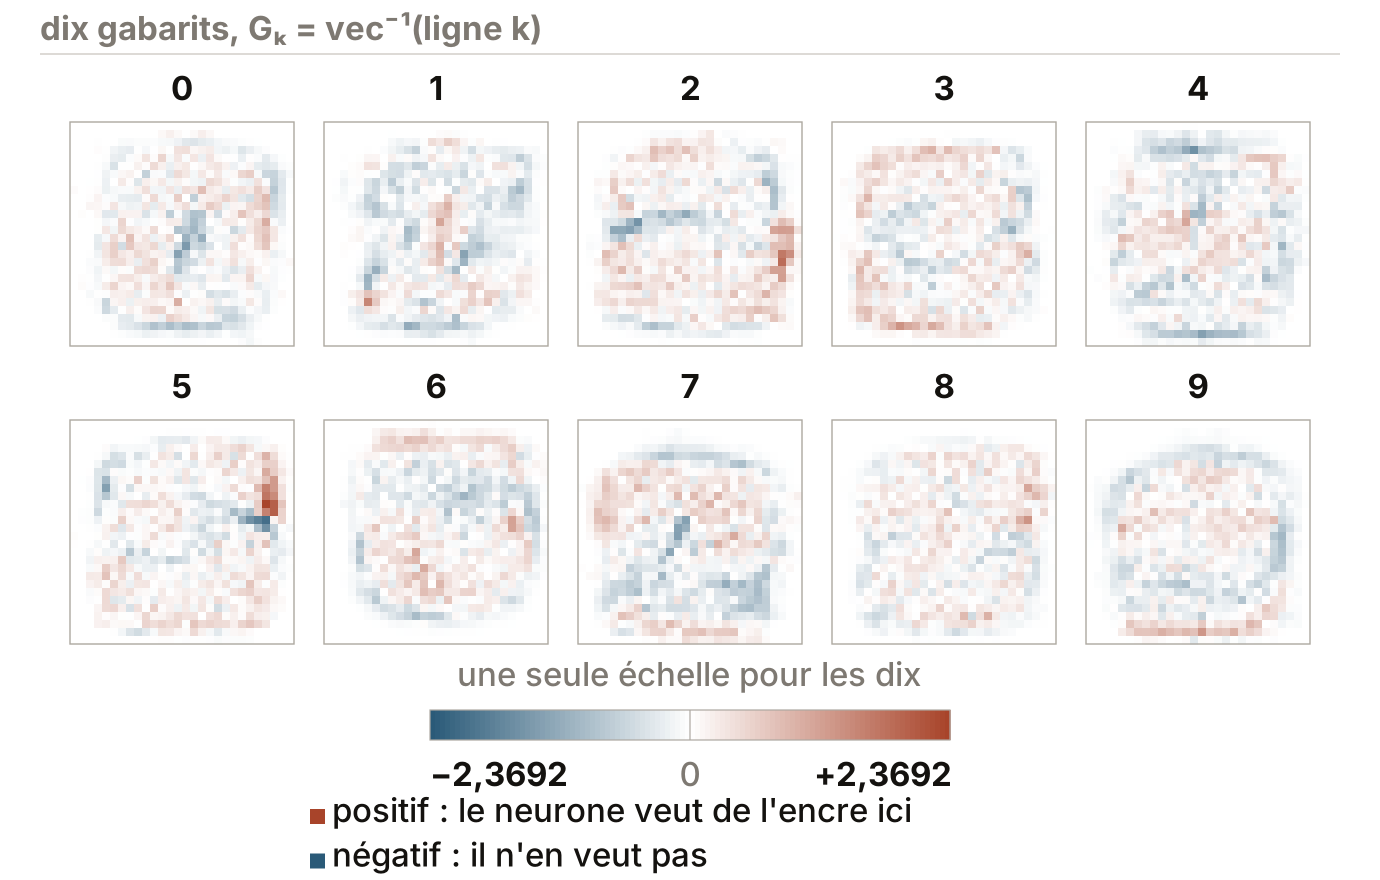
On prend donc dix neurones indépendants, un par chiffre, et le neurone a son propre vecteur de poids ainsi que son propre biais . Empiler les dix en lignes donne une matrice, et les dix un vecteur.
Ce que l'indice bas désigne ici
Deux emplois de l'indice bas se croisent ici, et c'est la graisse qui les sépare. En maigre, désigne comme à la page 4 le poids du pixel de rang , donc un nombre. En gras, désigne le vecteur des poids du neurone qui note le chiffre , donc une ligne entière de . Là où la graisse ne se voit pas, c'est la phrase qui dit lequel des deux est en jeu. Le reste, lui, la -ième coordonnée de , un nombre.
De la même façon, était un nombre à la page 4 et est ici le vecteur des dix.
Vérification des dimensions : , auquel de dimension s'ajoute. La ligne de étant , la coordonnée est exactement la préactivation du -ième neurone, si bien que rien de neuf n'a été introduit et que dix copies du même objet ont seulement été rangées.
À gauche, une petite grille carrée porte un sept manuscrit en gris. Au centre, deux colonnes de ronds vides sont reliées par un voile de traits très pâles ; celle de droite compte dix ronds étiquetés de zéro à neuf, et celui du sept est noirci et cerclé de rouge. Tout à droite, dix nombres sont écrits l'un sous l'autre, chacun à la hauteur du rond qui lui répond, sous le mot « avant ». Les cases de la grille se mettent alors à bouger ensemble, chacune vers une autre place ; quand elles s'immobilisent, le sept a disparu et il ne reste qu'un semis de taches grises où aucune forme ne se reconnaît. Le voile de traits s'efface, et dix bandes horizontales de petits carrés rouges et bleus s'installent à sa place, une par rond de la colonne de droite, entre deux crochets ; des points de suspension y remplacent la plupart des carrés. Les carrés montrés glissent au-dehors et s'effacent, et d'autres arrivent en sens inverse pour prendre leur place. Les bandes disparaissent, le voile de traits revient, et les taches de la grille brouillée s'envolent une à une vers la colonne de gauche, qui se remplit d'un motif tout autre qu'au début. La lumière traverse, la colonne de droite s'allume exactement comme la première fois, et le même cadre rouge se referme sur le rond du sept. Dix nombres s'écrivent enfin sous le mot « après », à côté des premiers : ce sont les mêmes, chiffre pour chiffre.
Les objets de la couche, typés
| Symbole | Type | Ensemble | Dimension | Rôle |
|---|---|---|---|---|
Matrice | Paramètre appris | |||
Vecteur | Paramètre appris | |||
Vecteur | Calculé | |||
Vecteur | , défini en | Calculé, de somme | ||
Vecteur | Donnée, tirée de par | |||
Scalaire entier | Donnée. Un code, pas une quantité | |||
Couple | L'ensemble des paramètres |
est un couple d'objets de types différents, et on l'identifie à un vecteur de en rangeant chaque bloc bout à bout, avec . C'est le procédé de la page 3, où rangeait une grille en colonne, employé ici sur des blocs de taille quelconque et sur des paramètres au lieu d'une image.
De dix scores à une loi de probabilité
est un vecteur de dix réels quelconques : rien n'y est positif, rien n'y somme à , et deux valeurs de donnent des échelles incomparables. On veut une réponse et une confiance, donc un objet d'un ensemble plus petit.
- Simplexe ouvertopen probability simplex
L'ensemble des vecteurs de à coordonnées strictement positives et de somme . Ses éléments sont exactement les lois de probabilité sur classes qui n'excluent aucune classe.
Le petit rond en exposant note cette exclusion du bord : une coordonnée peut s'approcher de autant qu'on veut sans jamais l'atteindre, et c'est ce que veut dire ouvert.
L'indice est la dimension de cet ensemble, pas son nombre de coordonnées. Un élément a bien coordonnées, mais la contrainte en retire une : dès que sont donnés, est forcé. Il reste degrés de liberté. Pour , on écrit donc .
- Softmax
L'application qui exponentie chaque coordonnée puis divise par la somme. L'exponentielle rend tout strictement positif, la division normalise.
Les deux morceaux se recollent, et le modèle de cette page s'écrit d'un trait : . C'est la boîte de la page 1 dans sa première version, celle qui ne fait qu'un calcul entre l'image et la réponse.
Hypothèses
est défini par , avec .
est le vecteur de uns.
, . Cette fonction ne sert ici qu'à nommer le résultat du cas ; la page 9 l'étudie pour elle-même.
Propriétés utilisées
pour tout réel , donc toute division par une somme d'exponentielles est licite
Étapes
(i) Invariance par translation. Pour tout et tout :
, et autorise la simplification.
n'est donc pas injective : toute la droite a la même image.
Conséquence : ce n'est pas une application composante par composante. Si elle l'était, il existerait telle que la coordonnée de l'image ne dépende que de . Ajoutons alors à la seule coordonnée : la coordonnée de l'image serait inchangée, puisque ne bouge pas. Or elle change, car le dénominateur augmente de pour . Contradiction.
L'argument porte sur une modification d'une seule coordonnée, alors que (i) en modifiait toutes : les deux ne se contredisent pas.
(ii) Le cas . On calcule la première coordonnée :
Division du numérateur et du dénominateur par , strictement positif.
Résultat
Interprétation
Chaque coordonnée de la sortie dépend de toutes les coordonnées de , par le dénominateur. Un score n'a donc aucun sens seul : seuls les écarts entre scores en ont un. Et ce que le cas binaire appelle « le » score est en réalité l'écart entre deux scores, dont l'un est implicitement fixé à zéro. La sigmoïde n'est pas une fonction différente du softmax : c'en est le cas particulier à deux classes.
Ce que ce résultat ne dit pas
L'invariance par translation a une conséquence pratique immédiate : on peut retrancher à toutes les coordonnées sans changer le résultat, et c'est exactement ce que fait le programme de mesures pour que ne déborde jamais.
Elle a aussi une conséquence sur les paramètres : ajouter une même constante aux dix biais ne change rien à la sortie. Le modèle a donc un degré de liberté inutile.
Comparer la sortie à la vérité
- Prédiction, et le cas des ex æquo
La classe prédite est . n'est pas défini sur tout entier : sur l'ensemble des dont le maximum est atteint par au moins deux coordonnées, il ne désigne aucun indice unique. est donc définie sur . Cet ensemble est réuni par les égalités , chacune retirant un degré de liberté : il est donc d'épaisseur nulle dans , et deux coordonnées calculées en virgule flottante n'y tombent pas. La convention retenue par le programme, en cas d'égalité, est de prendre le plus petit indice.
Ce que ce modèle compte, et ce qu'il vaut
Parmi ces nombres, sont attachés aux pixels que la page 2 a trouvés blancs sur les images à la fois. Quelle que soit leur valeur, ils ne déplacent aucun score, puisqu'ils sont toujours multipliés par zéro.
Trois réglages apparaissent dans la sortie qui suit, et le chapitre 3 seul dira comment on les choisit. Une époque est un passage complet sur les images d'entraînement. Le pas règle l'ampleur de chaque correction apportée aux paramètres. L'initialisation dit de quelles valeurs on part, ici de zéro partout, ce qui donne dix scores nuls et dix probabilités égales sur la première image. Les corrections, elles, ne sont pas nulles pour autant, et le chapitre 3 dira pourquoi.
Le modèle $784\rightarrow 10$ entraîné · cours/lecon2/mesures.py, section 4
    p                                       7850 parametres
    initialisation                          zero
    eta                                     0.5
    epoques                                 30

    PRECISION DE TEST                       0.9193
    ERREURS                                 807 sur 10 000
    perte de test                           0.2931

      epoque   acc_test
           1     0.9172
           2     0.9066
           3     0.9211
           5     0.9176
          10     0.9193
          15     0.9251
          20     0.9235
          25     0.9221
          30     0.9193
Lecture
contre un seuil de : le modèle a appris quelque chose, et beaucoup.
L'essentiel du score est acquis dès la première époque, à , et les vingt-neuf suivantes ne font plus que le faire osciller : entre les époques et il va et vient entre et , sans jamais s'écarter d'un point. Le chiffre retenu, , est celui de la dernière époque et non le meilleur des neuf, parce que choisir le meilleur reviendrait à régler le modèle sur le jeu de test.
La perte de test, , est la moyenne de sur les images, et non la perte d'une image particulière.
erreurs sur , et la page 7 démontre que ce plafond n'est pas un défaut de réglage.
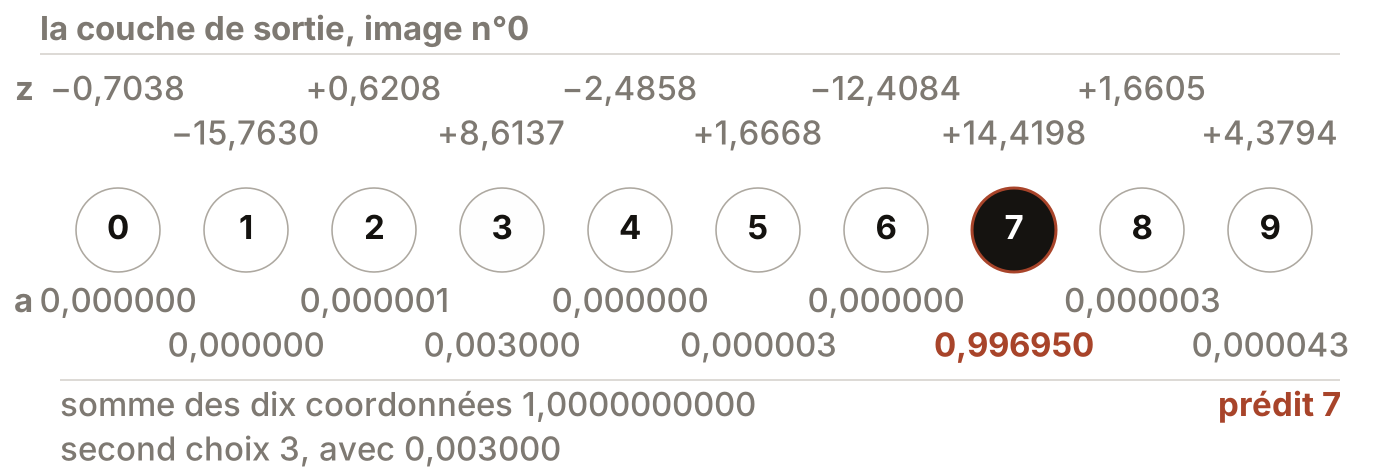
Une sortie complète, sur l'image de test n°0
      classe :         0         1         2         3         4         5         6         7         8         9
      a_k    :    0.0000    0.0000    0.0000    0.0030    0.0000    0.0000    0.0000    0.9969    0.0000    0.0000
      predit 7 avec 0.996950   second choix 3 avec 0.003000
      somme des dix coordonnees : 1.0000000000
Lecture
Les dix coordonnées somment à à la précision d'affichage : est bien dans .
Aucune coordonnée n'est exactement nulle : les zéros affichés sont des arrondis. C'est le sens du mot « ouvert » dans .
, et l'étiquette vraie est .
La sortie ci-dessus se lit sans le programme qui l'a produite.
- a
Quelle classe le réseau prédit-il, et quelle confiance accorde-t-il à son second choix ?
- b
Que vaut pour cette sortie, à trois décimales ?
- c
Si l'on ajoutait à chacune des dix préactivations , que deviendrait ? Justifier par la proposition 5.
Aucune réponse à cliquer : il y a un calcul à faire.
Le compte des paramètres se fait sans instancier d'abord.
- a
Pour classes et entrées, donner l'ensemble d'appartenance de , celui de , et l'expression de .
- b
Instancier pour et .
- c
Quelle part de est occupée par les biais ? Cette part grandit-elle ou diminue-t-elle quand augmente ?
Aucune réponse à cliquer : il y a un calcul à faire.